揭秘Transformer架构:从编码器到多头注意力
概要
本文详细介绍了Transformer编码器的整体架构与实现细节。编码器由N个堆叠的编码器层构成,每个编码器层包含两个关键子层:多头自注意力机制和前馈神经网络,均配有层标准化和残差连接。多头注意力机制将输入特征拆分为多个头并行处理,提高效率与鲁棒性。前馈网络对注意力输出进行非线性变换。
文章还深入解析了掩码张量、注意力计算公式(QKT/dk)、层标准化等技术要点,并提供了完整的PyTorch实现代码,包括注意力计算、多头注意力类、前馈网络、层标准化等核心组件的定义与测试案例。整个架构通过残差连接和层标准化有效缓解梯度消失问题,为自然语言处理任务提供了强大的特征提取能力。
整体架构流程
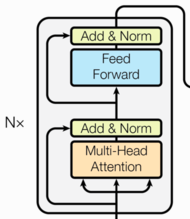
编码器:
由N个编码器层堆叠而成
每层编码器由两个子层连接结构构成
第一个子层是由多头自注意力子层和规范化层以及一个残差连接
第二个子层是由前馈全连接子层和规范化层以及一个残差连接
多头注意力机制:
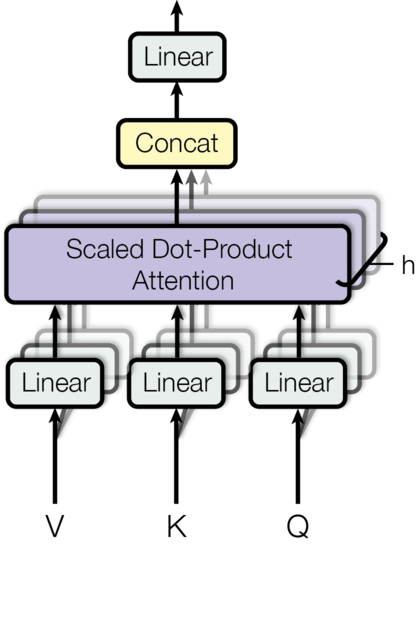
什么是多头注意力机制:
多头含义:将输入的特征空间(embed_dim)拆分成多个空间head,例如在本案例中head = 8,即拆分成8个
多头注意力机制的作用:
多个头可以关注不同的特征
并行可以提高效率,充分利用CPU
提高鲁棒性,单个头的作用会被其他头纠正
前馈全连接层
功能:对注意力机制输出的特征进行非线性变换
定位:在transformers每个编码器和解码器中,紧跟多头注意力之后
类比:类似于ANN中的全连接层
输入 → Linear1 → ReLU → Dropout → Linear2 → 输出
规范化层
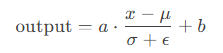
子层连接结构
原始输入
│
↓
[子层处理](如注意力计算/前馈网络)
│
↓
[LayerNorm] ← 可学习的缩放/偏移参数
│
↓
[Dropout] ← 随机屏蔽部分数据
│
↓
+ 原始输入(残差连接)
│
↓
最终输出
技术名词解释
掩码张量:
什么是张量:
里面只有0或1的元素;
张量的作用:
让另一个张量中的一些数值被遮掩,一般0是遮掩,1不遮掩
注意力机制:
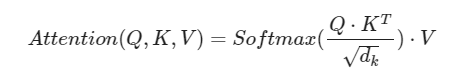
代码实现
1、导包
import torch
import torch.nn as nn
import math
import copy
import torch.nn.functional as F # 提供激活函数
import matplotlib
matplotlib.use('TkAgg')  # 或 'Qt5Agg',取决于你的环境
import matplotlib.pyplot as plt
from dm01input import * # 导入dm01input的方法
2、生成矩阵
# 生成下三角矩阵
def generate_triu(size):
    return torch.triu(torch.ones(1,size,size,dtype=torch.int),1)

# 生成掩码矩阵
def generate_padding_mask(tensor_x):
    tensor_x[tensor_x == 0] = 0

    tensor_x[tensor_x != 0] = 1
    return tensor_x.to(dtype=torch.int)
# 绘图:生成下三角矩阵
def show__triu():
    plt.figure(figsize = (5,5))
    plt.imshow(generate_triu(20)[0])
    plt.show()
3、定义attention的计算方法
| 步骤 | 数学公式 | 作用 |
|---|---|---|
| 点积分数 | QKTdkdkQKT | 计算查询和键的相似度,缩放防止梯度消失。 |
| 掩码 | masked_fill(−∞)masked_fill(−∞) | 屏蔽无效位置,确保模型仅关注有效信息。 |
| Softmax | Softmax(⋅)Softmax(⋅) | 生成概率分布,表示每个键对查询的重要性。 |
| 加权求和 | Attention=WVAttention=WV | 聚合值(value)信息,生成上下文表示。 |
def attention(query,key,value,mask = None,dropout = None):
    # 模拟注意力表达式
    # query/key/value-->[batch_size, seq_len, embed_dim]
    # mask-->shape-->[batch_size, seq_len, seq_len]
    # dropout--》实例化的对象
    # 第一步:获得词嵌入表达的维度
    d_k = query.size(-1)
    scores = torch.matmul(query,torch.transpose(key,-1,-2)/math.sqrt(d_k))
    if mask is not None:
        scores = scores.masked_fill(mask == 0,-1e9) # 将mask为0的位置填充为负无穷忽略无效位置
    atten_weights = F.softmax(scores,dim = -1)

    if dropout is not None:
        atten_weights = dropout(atten_weights)
    return torch.matmul(atten_weights,value),atten_weights
测试
def dm01_test_attention():
    position_result = dm02_test_position()
    query = key = value = position_result
    atten_result, atten_weights = attention(query, key, value)
    print(f'atten_result--》{atten_result.shape}')
    print(f'atten_weights--》{atten_weights.shape}')
    mask = torch.zeros(2, 4, 4)
    atten_result1, atten_weights1  = attention(query, key, value, mask)
    print(f'atten_result1--》{atten_result1.shape}')
    print(f'atten_weights1--》{atten_weights1.shape}')
4、定义多头注意力类
定义克隆函数
作用:深度复制某个神经网络module共N次,存储在nn.ModuleList中返回
copy.deepcopy:深拷贝,生成完全独立的副本
copy.copy:浅拷贝,副本与原对象共享子对象(列表、字典、其他模块)
def clones(module,N):
    return nn.ModuleList([copy.deepcopy(module) for _ in range(N)])
self.atten = None:初始化,暂时不赋值,forward方法中,将注意力权重保存到这里
class MutiHeadAttention(nn.Module):
    def __init__(self,head,embed_dim,dropout_p = 0.1):
        super().__init__()
        # 第一步:确定embed_dim是否能被head整除
        assert embed_dim % head ==0
        # 第二步:确定每个head应该处理多少维度特征
        self.d_k = embed_dim // head
        # 第三步:定义head的属性
        self.head = head
        # 第四步:定义4个全连接层
        self.linears = clones(nn.Linear(embed_dim,embed_dim),4)
        # 第五步:定义atten权重属性
        self.atten = None
        # 第六步:实例化dropout对象
        self.dropout = nn.Dropout(p =dropout_p)
    def forward(self,query,key,value,mask = None):
        # 需要对mask的形状进行升维度
        # mask-->输入的形状--》[head, seq_len, seq_len]-->[8, 4, 4],升维之后--》[1, 8, 4, 4]
        if mask is not None:
            mask = mask.unsqueeze(dim=0)
        # 获取当前输入的batch_size
        batch_size = query.size(0)
        # 开始处理query,key,value,都要经过线性变化并且切分为8个头
        # model(x)-->就是将数据经过linear层处理x-->[2, 4, 512]-->经过Linear-->[2, 4, 512]-->分割--》[2, 4, 8, 64]-->transpose-->[2, 8, 4, 64]
        query,key,value = [model(x).view(batch_size, -1, self.head, self.d_k).transpose(1, 2)
                             for model, x in zip(self.linears, (query, key, value))]
        # 接下来将上述处理后的query,key,value--》shape-->[2, 8, 4, 64]送入attention方法进行注意力的计算:
        # query--》[2, 8, 4, 64]和key--》[2, 8, 4, 64]转置结果[2, 8, 64, 4]进行相乘--》shape--》[2,8, 4, 4](所以传的mask矩阵是4维的)
        # [2, 8, 4, 4]要和value-->[2, 8, 4, 64]-->相乘--》shape--》x-->[2, 8, 4, 64]
        x,self.atten =attention(query,key,value,mask=mask,dropout=self.dropout)
        # 需要将多头注意力的结果进行合并
        #  x.transpose(1, 2)-->【2,4, 8, 64】
        # y 合并后的结果-->[2, 4, 512]
        y = x.transpose(1, 2).contiguous().view(batch_size, -1, self.head*self.d_k)
        # 经过线性变化得到指定输出维度的结果
        return self.linears[-1](y)
测试
def dm02_test_mutiheadattention():
    # 获取输入部分:[2, 4, 512]
    position_result = dm02_test_position()
    query = key = value = position_result
    # 计算注意力:因为是自注意力
    mutiHead_atten = MutiHeadAttention(head = 8,embed_dim = 512)
    mask = torch.zeros(8,4,4)
    result = mutiHead_atten(query,key,value,mask)
    print(f'多头自注意力机制的结果--》{result}')
    print(f'多头自注意力机制的结果--》{result.shape}')
5、定义前馈全连接层
d_model:输入输出层
d_ff:中间层
输入 → Linear1 → ReLU → Dropout → Linear2 → 输出
# TODO 3、定义前馈全连接层:两层线性层
class FeedForward(nn.Module):
    def __init__(self,d_model,d_ff,dropout_p = 0.1):
        super().__init__()
        self.d_model = d_model
        self.d_ff = d_ff
        self.linear1 = nn.Linear(d_model,d_ff)
        self.linear2 = nn.Linear(d_ff,d_model)
        self.dropout = nn.Dropout(p= dropout_p)
    def forward(self,x):
        return self.linear2(self.dropout(F.relu(self.linear1(x))))
def dm03_test_feedforward():
    position_result = dm02_test_position()
    query = key = value = position_result
    mutiHead_atten =MutiHeadAttention(head=8,embed_dim=512)
    mask = torch.zeros(8,4,4)
    atten_result= mutiHead_atten(query,key,value,mask)
    print(f'多头自注意力机制的结果--》{atten_result.shape}')
    my_ff = FeedForward(d_model=512,d_ff=1024)
    ff_result = my_ff(atten_result)
    print(f'前馈全连接层输出结果--》{ff_result.shape}')
    print(f'前馈全连接层输出结果--》{ff_result}')
测试
def dm03_test_feedforward():
    position_result = dm02_test_position()
    query = key = value = position_result
    mutiHead_atten =MutiHeadAttention(head=8,embed_dim=512)
    mask = torch.zeros(8,4,4)
    atten_result= mutiHead_atten(query,key,value,mask)
    print(f'多头自注意力机制的结果--》{atten_result.shape}')
    my_ff = FeedForward(d_model=512,d_ff=1024)
    ff_result = my_ff(atten_result)
    print(f'前馈全连接层输出结果--》{ff_result.shape}')
    print(f'前馈全连接层输出结果--》{ff_result}')
6、 规范化层
参数:
-
self.a:控制"是否要放大/缩小某些特征的重要性" -
self.b:控制"是否要整体抬高/压低某些特征的值"
公式:
代码
class LayerNorm(nn.Module):
    def __init__(self,features,eps = 1e-6):
        super().__init__()
        self.features =features # 特征维度/向量维度
        self.eps =eps # 确保分母永远不会为0
        self.a = nn.Parameter(torch.ones(features))
        self.b = nn.Parameter(torch.zeros(features))

    def forward(self,x):
        x_mean = torch.mean(x,dim=-1,keepdim=True)
        x_std = torch.std(x,dim=-1,keepdim = True)
        return self.a*(x-x_mean)/(x_std + self.eps) +self.b
测试
def dm04_test_layernorm():
    position_result = dm02_test_position()
    query = key =value = position_result
    mutiHead_atten = MutiHeadAttention(head=8,embed_dim=512)
    mask = torch.zeros(8,4,4)
    atten_result = mutiHead_atten(query,key,value,mask)
    print(f'多头自注意力机制的结果--》{atten_result.shape}')
    my_ff = FeedForward(d_model = 512,d_ff=1024)
    ff_result = my_ff(atten_result)
    print(f'前馈全连接层输出结果--》{ff_result.shape}')
    my_layernorm = LayerNorm(features = 512)
    result = my_layernorm(ff_result)
    print(f'result--》{result.shape}')
    print(f'result--》{result}')
7、定义子层连接结构
功能:
原始输入
│
↓
[子层处理](如注意力计算/前馈网络)
│
↓
[LayerNorm] ← 可学习的缩放/偏移参数
│
↓
[Dropout] ← 随机屏蔽部分数据
│
↓
+ 原始输入(残差连接)
│
↓
最终输出
名词含义:
残差连接:output = x + Dropout(LayerNorm(Sublayer(x)))中Dropout(LayerNorm(Sublayer(x)))就是残差
layer_norm:对子层输出做标准化
代码:
class SublayerConnection(nn.Module):
    def __init__(self,size,dropout_p = 0.1):
        super().__init__()
        self.size =size
        self.layer_norm = LayerNorm(features=size)
        self.dropout = nn.Dropout(p = dropout_p)

    def forward(self,x,sublayer):
        x1 = x+ self.dropout(self.layer_norm(sublayer(x)))
        return x1
测试
def dm05_test_sublayer():
    # 获取输入部分:[2, 4, 512]
    position_result = dm02_test_position()
    # 实例化多头注意力机制对象
    mutiHead_atten = MutiHeadAttention(head=8, embed_dim=512)
    mask = torch.zeros(8, 4, 4)
    # 定义一个处理多头自注意力机制的函数对象
    sublayer = lambda x: mutiHead_atten(x, x, x, mask)
    # 实例化子层连接结构对象
    sublayer_connect = SublayerConnection(size=512)
    result = sublayer_connect(position_result, sublayer)
    print(f'子层连接结构:result--》{result.shape}')
    print(f'result--》{result}')
8、定义编码器层
代码
class EncoderLayer(nn.Module):
    def __init__(self,size,self_atten,feed_forward,dropout_p):
        super().__init__()
        self.size =size
        self.self_atten =self_atten
        self.feed_forward =feed_forward
        self.sub_layers = clones(SublayerConnection(size,dropout_p),2)
    def forward(self,x,mask):
        # x-->来自输入部分--》[batch_size, seq_len, embed_dim]:[2, 4, 512]
        # mask-->[head, seq_len, seq_len]-=-->[8, 4, 4]
        # 经过第一个子层连接结构:先经过多头自注意力层--》然后经过norm-->最后残差连接
        x1 = self.sub_layers[0](x, lambda x: self.self_atten(x, x, x, mask))
        # 经过第二个子层连接结构:先经过前馈全连接层--》然后经过norm-->最后残差连接
        x2 = self.sub_layers[1](x1, self.feed_forward)
        return x2
测试
def dm06_test_encoderlayer():
    # 获取输入部分:[2, 4, 512]
    position_result = dm02_test_position()
    # 实例化多头注意力机制对象
    mutiHead_atten = MutiHeadAttention(head=8, embed_dim=512)
    # 实例化前馈全连接层对象
    ff = FeedForward(d_model=512, d_ff=1024)
    mask = torch.zeros(8, 4, 4)
    #  实例化编码器层对象
    encoder_layer = EncoderLayer(size=512, self_atten=mutiHead_atten, feed_forward=ff, dropout_p=0.1)
    # 将数据送入编码器层
    result = encoder_layer(x=position_result, mask=mask)
    print(f'编码器层得到的结果--》{result}')
    print(f'编码器层得到的结果--》{result.shape}')
9、定义编码器
代码
class Encoder(nn.Module):
    def __init__(self,layer,N):
        super().__init__()
        self.layer=layer
        self.layers = clones(layer,N)
        self.norm = LayerNorm(features = layer.size)
    def forward(self,x,mask):
        for layer in self.layers:
            x = layer(x,mask)
        return self.norm(x)
测试
def dm07_test_encoder():
    # 获取输入部分:[2, 4, 512]
    position_result = dm02_test_position()
    # 实例化多头注意力机制对象
    mutiHead_atten = MutiHeadAttention(head=8, embed_dim=512)
    # 实例化前馈全连接层对象
    ff = FeedForward(d_model=512, d_ff=1024)
    mask = torch.zeros(8, 4, 4)
    #  实例化编码器层对象
    encoder_layer = EncoderLayer(size=512, self_atten=mutiHead_atten, feed_forward=ff, dropout_p=0.1)
    #  实例化编码器对象
    encoder = Encoder(layer=encoder_layer, N=6)
    # 将数据送入编码器
    encoder_output = encoder(position_result,  mask)
    print(f'encoder_output编码器得到的结果--》{encoder_output}')
    print(f'encoder_output编码器得到的结果--》{encoder_output.shape}')
    return encoder_output
10、程序入口
if __name__ == '__main__':
    dm01_test_attention()
    dm02_test_mutiheadattention()
    dm03_test_feedforward()
    dm04_test_layernorm()
    dm05_test_sublayer()
    dm06_test_encoderlayer()
    dm07_test_encoder()
中国智能体开发者社区,聚焦智能体与大模型开发,提供前沿资讯、实用工具链、开源项目及行业案例。通过技术沙龙、开发者大赛等活动,促进经验交流与协作,助力开发者快速构建创新智能应用。
更多推荐



 28
 0
- 0


 已为社区贡献1条内容

所有评论(0)