登录社区云,与社区用户共同成长
邀请您加入社区
Transformer / LLM、提示词、微调、RAG、函数调用、MCP、Agent、多智能体、上下文工程、Skills、OpenClaw、Harness 完整技术串讲与论文参考
本文详解AI智能体架构的9大核心技术:AI智能体基础架构、Agentic AI多智能体协作、WorkFlow任务流程、RAG检索增强、模型微调、函数调用、MCP协议、A2A智能体通信及AG-UI交互设计。这些技术构建了从底层到应用层的完整体系,帮助开发者构建高效灵活的大模型应用。
把仓库 3 年的隐性知识,蒸馏成可验证的结构化产物,再注入虚拟人,让知识"活"起来。知识不流失:人员流动、记忆模糊,但蒸馏产物永久留存知识可验证:每个结论都有代码/文档/提交依据知识可复用:虚拟人让知识随时可问、可用知识可演进:工具链让知识随仓库同步更新。
节点类型定义示例实体具体的代码/模块/文件src/core/概念抽象的业务/技术概念“状态管理”、“模型汇聚”、“分层架构”决策架构决策(ADR)ADR-001(用 Pinia)模式可复用的实现模式统一请求封装、Store 工厂"description": "全局状态管理模块","source": "架构文档",节点 ID 规范类型:名称,如concept:状态管理pattern:统一请求封装。"
这篇文章揭示了AI Agent与大语言模型(LLM)的本质区别,并详细解释了Agent的工作原理。核心观点包括: 大语言模型本质是无状态的文本处理函数,所有"记忆"都是通过客户端重传历史对话实现的,这导致对话成本呈平方级增长。 AI Agent是"大脑+手脚+循环"的系统,由三部分组成: 大模型作为决策核心 工具调用作为执行手段 循环机制实现持续交互 Agent的实际工作流程: ① 客户端维护对话
这篇文章的核心观点是:理解AI Agent系统的关键在于掌握其底层的第一性原理,而非具体框架的实现细节。作者通过分析一个典型Agent请求的生命周期,揭示了大型Agent框架中各个模块存在的必要性——它们都是为了解决现实场景中的特定问题而自然演化出的解决方案。 文章提出了阅读Agent源码的方法论: 以完整请求为线索追踪控制流 关注模块存在的根本原因(解决什么问题) 区分智能判断与执行权限的边界
本文系统梳理了视频生成领域的核心基础架构模型,包括T5、CLIP、DDIM、DiT等12种关键技术。这些模型在文本编码、图像生成、视频处理等环节各具特色:T5统一文本处理框架,CLIP实现图文跨模态理解,扩散模型(DDIM/LDM)提升生成质量,DiT/FiT通过Transformer架构优化计算效率。特别关注VideoGPT和ShareGPT4Video在视频生成领域的创新,前者结合VQ-VAE
AI-Python机器学习与深度学习技术实战:CNN/Transformer/扩散模型、SHAP可解释及Hermes智能体自动化
摘要: 本文深入解析了大模型人类偏好对齐技术(RLHF/DPO/GRPO)的演进与实现。对齐(Alignment)旨在让模型满足有益、诚实、无害三要素,通过三阶段(SFT、奖励建模、强化学习)实现。传统RLHF依赖PPO优化策略,但训练复杂;DPO省去奖励模型,直接优化偏好;2024年DeepSeek R1提出的GRPO通过群体策略优化成为开源首选。2026年ICML提出的SelectiveRM利
如果说程序员已经是高薪职业,那么干AI的程序员,就是高薪中的高薪。学AI大模型,就是冲刺高薪的最优解!零基础小白不知道从哪入门?有基础的程序员找不到系统学习路径?实战项目练手无门?面试不知道考什么?别慌!今天就给大家整理了一份【2026年最新版】AI大模型免费学习资源包,覆盖从入门到实战、从理论到面试、从基础到进阶的全流程,所有资料均已整理归档,无冗余、无套路,免费分享给每一位想抓住AI风口的程序
你有没有想过,当你对ChatGPT说“帮我写一段下周去三亚旅游的天气穿搭指南,要考虑到可能会下阵雨,风格要轻松幽默”,它是怎么理解“阵雨”和“穿搭”之间的微妙联系的?又是怎么知道“三亚”和“轻松幽默”之间应该建立什么样的基调?它甚至还能根据你前面聊过的话题,把你特别怕热、一出汗就心烦这个细节自然地编织进去。这已经脱离了冷冰冰的程序执行范畴,像是一个真正听懂了你的朋友在帮你筹划。这背后的底层秘密,是
Transformer之外,Shazeer很早就参与推动稀疏MoE,也就是混合专家模型——这条路线的核心思想是,不让每次计算都激活整个模型,而是根据不同输入调用不同“专家”模块,从而在扩大模型容量的同时控制计算成本。这让Shazeer的跳槽不再是“Transformer之父去OpenAI继续加强Transformer”的故事,更像是一个参与定义Transformer时代的人,开始参与寻找Trans
什么是开源模型?先简单概括来说:GPT、Claude 系列长期提供且只提供API 服务,我们只能调用模型,而无法获得模型本身,了解模型内部,这就是我们普遍意义上的闭源模型。而 LLaMA、Qwen、DeepSeek 等模型则可以下载安装到本地运行,因此常常被统称为开源大模型。蟹老板不公开蟹黄堡秘方,这是闭源模型:我们只能去店里买蟹堡,但不知道里面用了什么材料、怎么做。蟹老板公开了制作蟹黄堡所需材料
2017年具有革命性的Transformer架构开始,解决了早期模型(诸如循环神经网络(RNN)和长短期记忆网络(LSTM))在处理长距离依赖和顺序处理时存在的困难性,通过自注意力机制重新定义了自然语言处理(NLP)。2018-2020年,预训练Transformer模型时代,其特点是预训练模型的兴起以及对模型规模前所未有的关注。这一时期出现了两个具有影响力的模型家族:BERT和GPT,它们展示了
再具体一点,假设我们在做英译中任务,Decoder 正在生成中文的“爱”字。首先,它的会去询问 Encoder 中的英文单词,发现英文单词 "Love" 的与它的最匹配。于是,它从 "Love" 对应的中提取了语义特征。最终,Decoder 结合了自身的上下文和从 Encoder 拿到的“爱”的语义特征,成功输出了“爱”。
接下来我们逐步拆解这个过程。
接下来是一些碎碎念。
换句话说,DeiT 本身依然是一个全局 attention、无层级结构、内部缺乏局部归纳偏置的模型。中提出的 ViT 的另一变体:的出发点。
本文介绍了Agent开发和大模型作为当前技术圈最热门的方向,以及相关岗位的高薪吸引力。然而,由于市场对具备实际能力的人才需求旺盛,许多求职者难以胜任。为此,作者推荐了一款《就业保薪班》,承诺通过系统学习和实战项目,帮助学员掌握Agent开发和大模型技术,并提供了就业保障和分期付款服务,旨在帮助学员顺利转型成为合格的Agent大模型工程师。放眼2026技术圈,Agent 绝对是当下最热门的方向。不管
在有了 PAD 后,从理论上来说: Transformer 可以处理无限长的序列,只要把该 batch 中的其他序列都填充至最长长度就好了。这便是 Transformer-XL 的核心改进点,同时,作者提出了一种改进后的 RPE,下面就来详细展开。,我们会这这一批次的编码信息存入缓存窗口,而下一批次的输出后,就会把下一个批次的输出再存入其中。时,我们提到了位置编码,提到了因果掩码,但并没有对数据本
面试官:来讲讲大模型的 DPO 和 PPO 有什么区别?🙋♂️我:DPO 和 PPO 都是用来做对齐的,让模型的输出更符合人类偏好。DPO 比 PPO 简单一些。
└─────────────────┘│ Runtime Services 启动│。├─ cronReconciliation│├─ 停止诊断心跳├─ 停 cron、停心跳。├─ 停 retained 插件清理│├─ 停定价刷新├─ 取消所有事件订阅。
GeoAI遥感深度学习:场景分类·语义分割·目标检测·变化检测四大任务,从CNN、Transformer到空间基础模型与AI Agent全流程实战技术应用
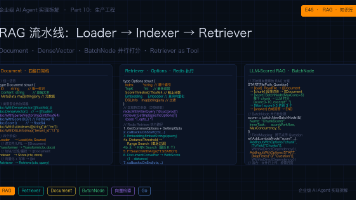
本文深入解析了企业级 AI Agent 中 RAG(检索增强生成)的核心组件设计与实现。文章将 RAG 流程拆分为构建期(Loader→Transformer→Indexer)和查询期(Retriever)两个阶段,详细介绍了四个核心接口的设计: Document 作为数据载体,包含内容、元数据和向量信息,提供类型安全的元数据操作方法 Loader 负责从各种来源加载原始文档 Transforme
本文介绍了开发AI Agent时常见的工具调用性能问题及解决方案。作者在LangChain JS开发中发现新手常犯的串行调用工具导致性能低下的问题,通过代码对比展示串行与并行(Promise.all)的耗时差异(从2.5s优化到2s)。文章详细拆解了Agent的核心架构(LLM+工具+记忆等),并给出基于DeepSeek模型搭建文件读取工具的实战Demo,包含完整NodeJS代码。最后总结了生产环
AI Agent 千行实战:6 个设计套路,从代码看懂 Agent 怎么跑
智能体开发方案覆盖从低代码可视化到专业编程框架的多个层级,不同方案在抽象程度、灵活度、开发成本与定制能力上存在明确差异,对应不同的业务场景与开发团队。
2026年,AI已深度渗透日常生活,但多数人对AI的理解仍停留在表面。本文以通俗语言解析人工智能(AI)、大模型和智能体的核心逻辑:AI是让机器具备智能行为的领域,经历了从规则系统到机器学习再到深度学习的演进。2017年Transformer架构的出现成为关键转折点,其注意力机制大幅提升了模型性能。当前AI的突破源于算力、数据和算法三要素的成熟。2022年ChatGPT的爆发式增长标志着大模型时代
本文摘要:Transformer架构是AI领域的革命性突破,解决了传统RNN模型的长距离依赖和并行计算难题。其核心在于Self-Attention机制,通过同时处理所有输入并计算注意力权重,使模型能有效理解上下文关系。关键创新包括多头注意力(不同关注维度)、位置编码(处理序列顺序)以及QKV(查询-键-值)匹配机制。Transformer的并行处理能力和强大扩展性使其成为ChatGPT等大模型的基
第一次在昇腾NPU 上跑 LLaMA-13B 的时候,显存爆了。不是模型太大,是 attention 计算中间存了一大堆临时矩阵,把 HBM(高带宽内存)撑到爆。那会还没用 ops-transformer 的 FlashAttention,用的是 PyTorch 原生的。后来翻 ops-transformer 的代码才发现,人家根本不存那些中间矩阵——直接在 SRAM(静态随机存取存储器)里把活干
本文系统梳理了18道大语言模型(LLM)核心面试题,涵盖Transformer架构、BERT与GPT区别、涌现能力、幻觉问题等关键技术点。重点解析了Prompt工程、RAG集成、成本控制等应用难点,提供了Temperature参数调节、缓存策略设计、长文本处理等实用解决方案。文章通过参考答案+延伸追问的形式,深入浅出地讲解了LLM技术栈的核心原理与工程实践,为开发者构建高效、稳定、安全的LLM应用
摘要:ATB(Ascend Transformer Boost)是华为昇腾NPU生态中的大模型推理加速库,位于CANN架构最上层。它通过图优化(算子融合替换)、KV Cache管理和调度执行三大功能,简化了Llama等大模型在昇腾NPU上的推理部署。ATB采用类似vLLM的PagedAttention思路管理KV Cache,支持Continuous Batching调度,并提供开箱即用的Hugg