transformer原理
🌐 Transformer 算法详解
一、举例说明:从翻译任务理解 Transformer 的思想
场景:将英文句子 “I love cats.” 翻译成中文 “我喜欢猫。”
❌ 传统方法(如 RNN)的问题
- RNN 按顺序处理:先读 “I”,再读 “love”,最后读 “cats”。
- 每一步依赖前一步的隐藏状态,形成“信息链”。
- 问题:
- 长句子中,早期信息(如 “I”)在传递到末尾时可能被稀释或遗忘。
- 无法并行计算——必须等前一个词处理完才能处理下一个,训练慢。
- “love” 和 “cats” 虽然语义紧密,但 RNN 中它们之间隔着时间步,依赖路径长。
✅ Transformer 的做法:让所有词“同时开会”
Transformer 不再逐词处理,而是:
让“I”、“love”、“cats”三个词同时参与一场“注意力会议”,互相评估彼此的相关性,并据此更新自己的含义。
具体过程如下:
- 每个词提出问题(Query):
- “love” 问:“谁是主语?谁是宾语?”
- 每个词提供身份标签(Key):
- “I” 的 Key 表示“我是主语”,“cats” 的 Key 表示“我是名词宾语”。
- 每个词携带内容(Value):
- “I” 的 Value 是“第一人称代词”,“cats” 的 Value 是“复数动物名词”。
- 计算关注度:
- “love” 与 “I” 和 “cats” 的 Key 匹配度高 → 给高注意力权重。
- 融合信息:
- “love” 的新表示 = 高权重 × “I” 的 Value + 高权重 × “cats” 的 Value
- 结果:“love” 不再是孤立的动词,而是“我对猫的喜爱”这一完整语义单元。
最终,编码器输出一个富含上下文的表示,解码器基于此逐字生成中文:“我” → “喜欢” → “猫”。
💡 关键突破:
- 所有词并行处理,训练快;
- 任意两个词直接建模依赖,无论距离多远;
- 通过“注意力”动态决定关注重点,灵活适应不同句子结构。
二、核心原理:Transformer 的工作机制
Transformer 由 编码器(Encoder) 和 解码器(Decoder) 组成(也可单独使用,如 BERT 仅用编码器,GPT 仅用解码器)。下面以完整 Encoder-Decoder 架构为例说明。
1. 输入表示:词嵌入 + 位置编码
- 词嵌入(Word Embedding):将每个词映射为固定维度的稠密向量(如 512 维),捕捉语义信息。
- 问题:Transformer 本身没有“顺序”概念(不像 RNN 有时间步),无法区分 “猫追狗” 和 “狗追猫”。
- 解决方案:位置编码(Positional Encoding)
- 为每个位置(第1个词、第2个词……)生成唯一的向量。
- 将位置向量加到词嵌入上,使模型感知顺序。
位置编码使用正弦/余弦函数,既能表示绝对位置,又能通过线性组合表示相对位置。
这样模型就知道顺序了。
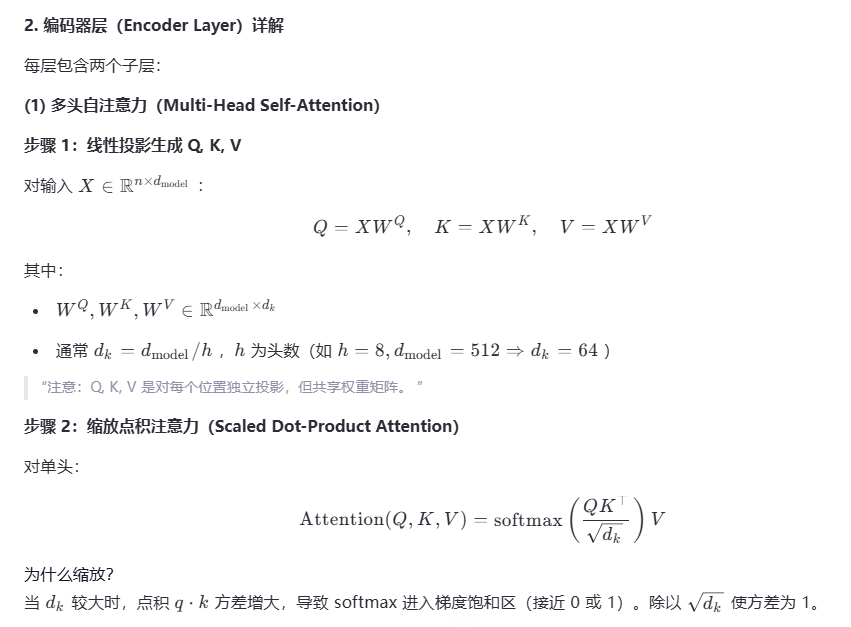
2. 自注意力机制(Self-Attention)
这是 Transformer 的核心创新。
目标:
对序列中每个位置,动态计算它应关注哪些其他位置,并融合这些位置的信息。
三要素(每个词生成):
- Query(Q):代表“我想找什么?”(主动查询)
- Key(K):代表“我能响应什么查询?”(被动响应)
- Value(V):代表“我真正包含的信息是什么?”(内容)
类比:在图书馆找书。
- Query = 你想找的书名(如“机器学习”)
- Key = 每本书的标签(如“AI”、“数学”)
- Value = 书的实际内容
你根据 Query 和 Key 的匹配度,决定读哪本书的 Value。
计算流程:
- 所有词同时计算 Q、K、V。
- 用 Q 与所有 K 做点积,得到“注意力分数”。
- 对分数做 softmax,得到注意力权重(和为1)。
- 用权重加权所有 V,得到每个词的新表示。
结果:每个词的新表示都融合了整个句子的上下文信息。
这样,“love” 就融合了“I”和“cats”的信息,不再是孤零零的“喜欢”,而是“我喜欢猫”中的“喜欢”。
3. 多头注意力(Multi-Head Attention)
单头注意力可能只捕捉一种关系(如主谓关系),但语言是复杂的。
解决方案:
- 并行运行多个自注意力“头”(如 8 个)。
- 每个头学习不同的表示子空间(如一个头关注语法,一个头关注语义,一个头关注指代)。
- 将所有头的输出拼接,再线性变换,得到最终输出。
效果:模型具备“多视角理解能力”,表达能力更强。
这叫 多头注意力 —— 就像一个人有8个大脑,从不同角度看问题。
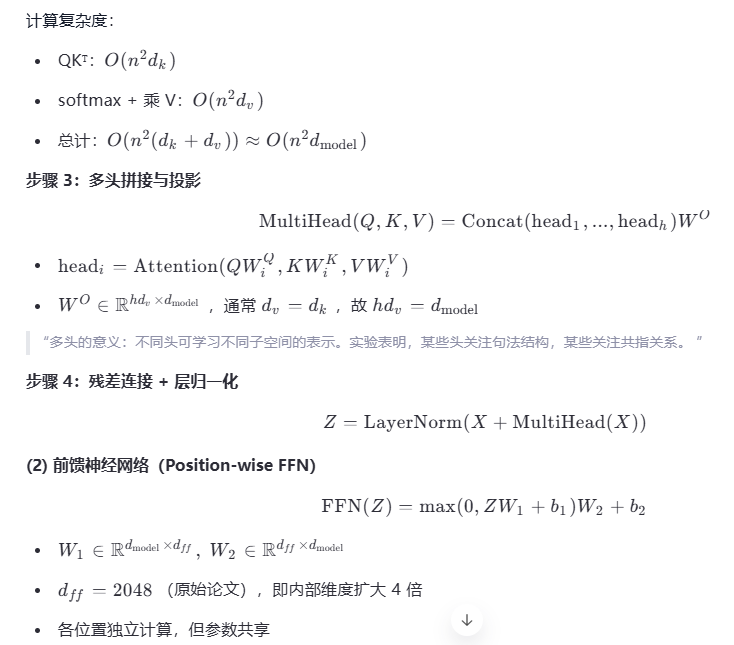
4. 前馈神经网络(Position-wise Feed-Forward Network, FFN)
- 每个位置的向量单独通过一个两层全连接网络。
- 第一层扩大维度(如 512 → 2048),引入非线性;
- 第二层压缩回原维度(2048 → 512)。
- 各位置参数共享,但计算独立。
作用:对注意力输出进行进一步非线性变换和特征提炼。
可以理解为:每个词“自己再想想”,把刚开会得到的信息消化一下。
5. 残差连接(Residual Connection)与层归一化(Layer Normalization)
- 残差连接:输出 = 输入 + 子层输出
→ 缓解深层网络梯度消失,保留原始信息。 - 层归一化:对每个样本的特征维度做归一化
→ 稳定训练,加速收敛。
每个子层(如 Multi-Head Attention、FFN)都包含:
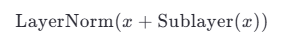
残差连接:新结果 = 原始输入 + 新计算结果(保留原始信息)
层归一化:把数值调整到合适范围,让训练更稳定
就像你学习新知识时,既吸收新内容,又不忘基础知识。
6. 编码器 vs 解码器
| 模块 | 功能 | 特点 |
|---|---|---|
| 编码器(6层堆叠) | 理解输入序列 | 可访问整个输入序列,使用标准自注意力 |
| 解码器(6层堆叠) | 生成输出序列 | 1. 使用掩码自注意力(不能看未来词) 2. 使用编码器-解码器注意力(可关注编码器输出) |
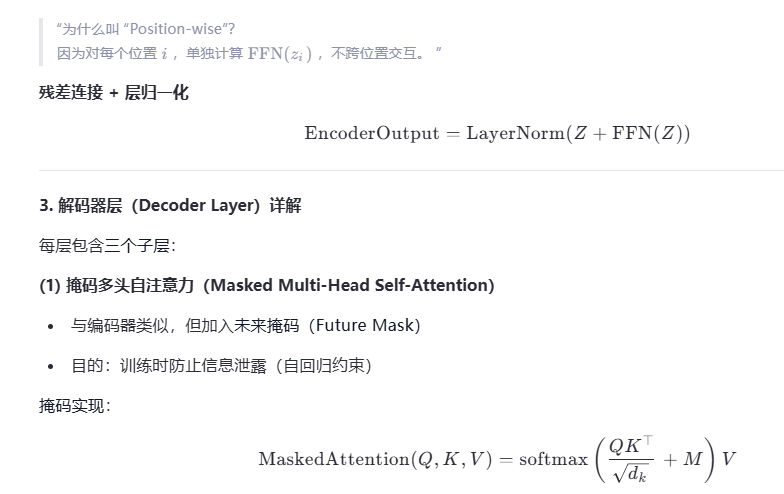
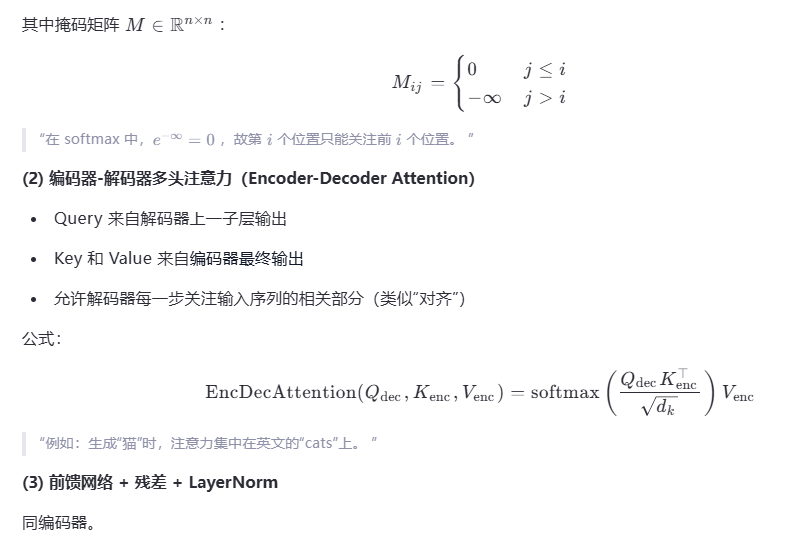
解码器的掩码机制(Masking)
- 在训练时,解码器输入是目标序列(如“我 喜欢 猫”),但生成第 t 个词时,不能利用 t 之后的信息。
- 通过在注意力分数中将未来位置设为 (-\infty),经 softmax 后权重为 0,实现“遮蔽”。
编码器(Encoder):只负责“理解”输入句子(如英文)。
它可以看整个句子,自由使用自注意力。
解码器(Decoder):负责“生成”输出句子(如中文)。
它有两个注意力:
掩码自注意力:生成“喜欢”时,只能看“我”,不能看后面的“猫”(防止作弊)。
编码器-解码器注意力:可以看编码器对英文的理解,知道“love”对应“I”和“cats”。
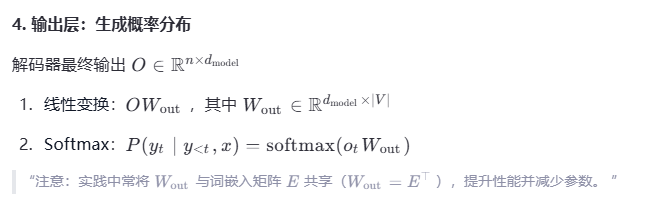
7. 训练与推理
- 训练:使用 Teacher Forcing
→ 解码器输入为真实目标序列(右移一位),并行计算所有输出位置的损失。 - 推理:自回归生成
→ 逐个预测词,将已生成词作为下一步输入。
三、关键数学公式(形式化表达)
整体架构(Encoder-Decoder)
- 编码器(Encoder):6 层堆叠,将输入序列映射为上下文表示
- 解码器(Decoder):6 层堆叠,自回归生成输出序列
- 参数共享:所有编码器层结构相同(但参数不共享),解码器同理
1. 输入表示:词嵌入 + 位置编码
(1) 词嵌入(Token Embedding)
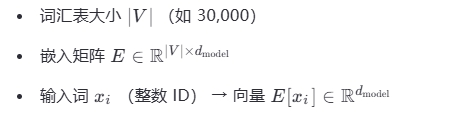
注意:嵌入层在训练中学习,捕捉语义相似性(如 “king” - “man” + “woman” ≈ “queen”)
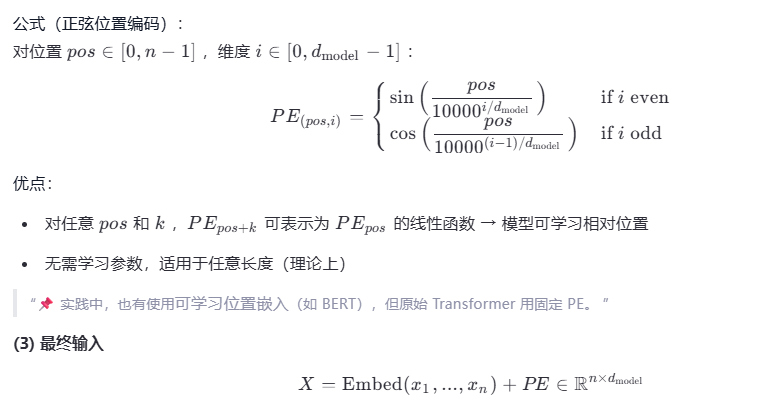
(2) 位置编码(Positional Encoding, PE)
为什么需要?
Transformer 无循环结构,对输入序列是“排列不变”的(permutation-invariant)。若不加位置信息,则 “I love cats” 与 “cats love I” 被视为相同。
设计要求:
- 能表示绝对位置
- 能表示相对位置(如 “动词在名词后”)
- 可泛化到比训练更长的序列
2. 编码器层(Encoder Layer)详解
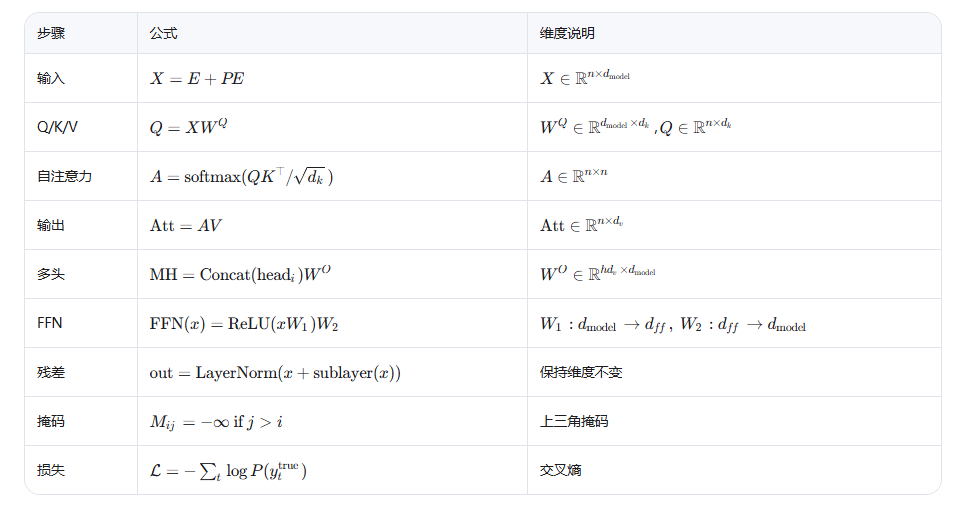
四、关键数学公式汇总(带维度说明)
五、训练细节与工程实践
1. 优化器
-
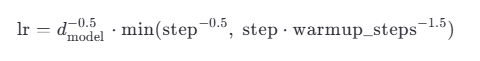
Adam 优化器,但使用学习率预热(Warmup) + 余弦衰减
-
学习率公式:
-
Warmup 步数:通常 4000 步
2. 正则化
- Dropout:在残差连接后、FFN 内部、注意力权重上应用(原始论文用 0.1)
- Label Smoothing:防止模型过度自信,提升泛化
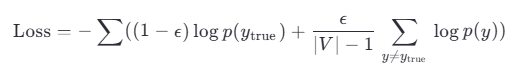
3. 批处理与填充(Padding)
- 不同长度句子组成 batch → 用
<pad>填充至相同长度 - 注意力掩码:在 softmax 前将
<pad>位置设为 (-\infty),避免无效信息干扰
4. 并行训练
- 编码器:整个输入序列并行
- 解码器训练:因 Teacher Forcing,整个目标序列并行(推理时才自回归)
六、总结:Transformer 的全景图
1. 为什么成功?
| 传统模型 | Transformer |
|---|---|
| 依赖循环/卷积 | 仅用注意力 |
| 串行计算 | 完全并行 |
| 长程依赖弱 | 全局直接连接 |
| 固定归纳偏置 | 数据驱动灵活建模 |
2. 核心贡献
- 提出 Self-Attention 作为序列建模基本单元
- 设计 Positional Encoding 解决顺序问题
- 构建 Encoder-Decoder with Multi-Head Attention 通用架构
- 证明 纯注意力模型 可超越 RNN/CNN
3. 影响与演进
| 方向 | 代表工作 | 改进点 |
|---|---|---|
| 仅编码器 | BERT, RoBERTa | 双向上下文,掩码语言建模 |
| 仅解码器 | GPT 系列 | 自回归生成,大规模预训练 |
| 编码器-解码器 | T5, BART | 统一文本到文本框架 |
| 长序列 | Longformer, BigBird | 稀疏注意力,降低 ( O(n^2) ) |
| 位置编码 | RoPE, ALiBi | 相对位置,更好外推 |
| 视觉 | ViT, Swin Transformer | 将图像分块,用 Transformer 建模 |
4. 当前地位
- NLP 事实标准架构
- 多模态基础模型核心(如 CLIP、Flamingo、PaLM-E)
- 科学 AI 关键组件(AlphaFold 2 的 Evoformer 基于 Transformer)
5. 附录:原始论文关键参数(Vaswani et al., 2017)
| 超参数 | 值 |
|---|---|
| ( d_{\text{model}} ) | 512 |
| ( d_k = d_v ) | 64 |
| 头数 ( h ) | 8 |
| FFN 维度 ( d_{ff} ) | 2048 |
| 编码器/解码器层数 | 6 |
| Dropout | 0.1 |
| Batch size | 256,000 词 |
| Optimizer | Adam (( \beta_1=0.9, \beta_2=0.98, \epsilon=10^{-9} )) |
| Warmup steps | 4000 |
七、总结:Transformer 的革命性意义与影响
1. 核心创新
- 完全摒弃循环和卷积,仅依赖注意力机制建模序列。
- 自注意力实现全局依赖建模,解决长距离依赖问题。
- 并行计算极大提升训练效率,支持大规模模型训练。
2. 架构优势
| 特性 | 说明 |
|---|---|
| 并行性 | 所有位置同时计算,训练速度比 RNN 快数十倍 |
| 长程依赖 | 任意两个词直接交互,路径长度恒为 1 |
| 可扩展性 | 易堆叠层数、增加参数,支撑千亿级大模型 |
| 通用性 | 适用于文本、图像(ViT)、音频、蛋白质序列等 |
3. 历史影响
- 2017 年:Google 提出 Transformer(《Attention is All You Need》)
- 2018 年:BERT(仅编码器)刷新 NLP 任务记录
- 2018–2020 年:GPT 系列(仅解码器)开启大语言模型时代
- 2020 年后:Transformer 成为 AI 基础架构,应用于:
- 自然语言处理(ChatGPT、LLaMA)
- 计算机视觉(Vision Transformer)
- 多模态(CLIP、Flamingo)
- 科学计算(AlphaFold 2 使用 Evoformer,基于 Transformer)
4. 局限与改进
- 计算复杂度高:自注意力为 ( O(n^2) ),对长序列不友好
→ 改进:Longformer、Performer、Linformer - 缺乏归纳偏置:需大量数据训练
→ 改进:结合 CNN/RNN 结构,或引入结构先验 - 位置编码外推性差:原始 PE 难以处理比训练更长的序列
→ 改进:相对位置编码(如 T5、RoPE)
📌 终极总结一句话:
Transformer 通过自注意力机制实现序列元素间的全局、动态、并行交互,彻底颠覆了传统序列建模范式,成为现代人工智能大模型的通用基础架构。
📚 原始论文:Ashish Vaswani et al., Attention is All You Need, NeurIPS 2017.

中国智能体开发者社区,聚焦智能体与大模型开发,提供前沿资讯、实用工具链、开源项目及行业案例。通过技术沙龙、开发者大赛等活动,促进经验交流与协作,助力开发者快速构建创新智能应用。
更多推荐



 21
 0
- 0


 已为社区贡献1条内容

所有评论(0)