企业级 AI 智能体架构拆解:大模型 + 知识库 + 工作流的完整搭建指南
企业级 AI 智能体架构拆解:大模型 + 知识库 + 工作流的完整搭建指南
关键词:AI Agent、大模型应用、企业知识库、工作流编排、多渠道接入
适合人群:企业技术负责人、产品经理、运营同学,以及所有想把 AI 真正落到业务里的人。
一、为什么通用大模型"不够用"?
很多团队一上来就接一个通用大模型(LLM),写几句提示词就当客服、当助手用了。跑两天就发现 三个绕不开的坑:
- 不懂企业私货:公司产品手册、内部制度、历史工单它全不知道,答非所问。
- 动不了业务系统:用户问"我的订单到哪了",它只能说"建议您联系客服"。
- 接不进业务渠道:官网、公众号、企微、钉钉里没有一个能直接用起来的入口。
说白了,通用大模型是"通才",而企业要的是 "懂自家业务、能干活、能上线"的专属智能体(Agent)。
要解决这个问题,业界普遍的思路是:把"大模型 + 知识库(RAG)+ 数据库 + 插件/工具 + 工作流 + 多渠道"打包成一套可配置、可发布、可运营的系统。本文以 硅基边界(一个企业级 AI 智能体搭建平台)为例,拆解这套架构的搭建过程。
二、对话式智能体:系统的核心模块
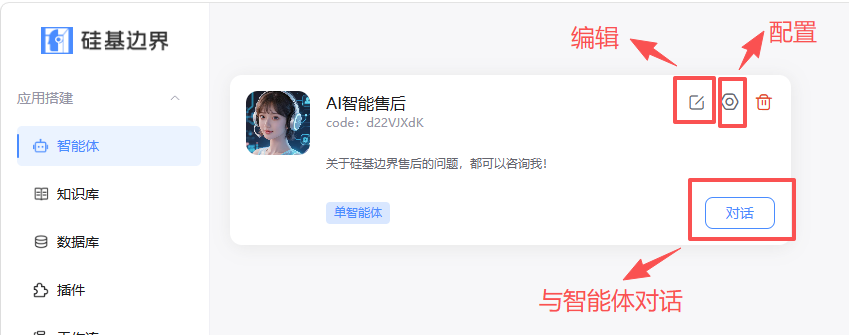
在硅基边界中,对话式智能体(Agent) 是核心基础模块。它能基于你的业务场景,用大模型灵活调用「知识库 / 数据库 / 插件」等能力,配置完成后就是一个专属 AI 智能体。
一个智能体本质上 = 人设设定 + 大模型 + 知识库 + 数据库 + 插件 + 记忆。这几块都可以在可视化界面里完成,基本不需要写代码。
三、5 分钟创建一个专属智能体(实操)
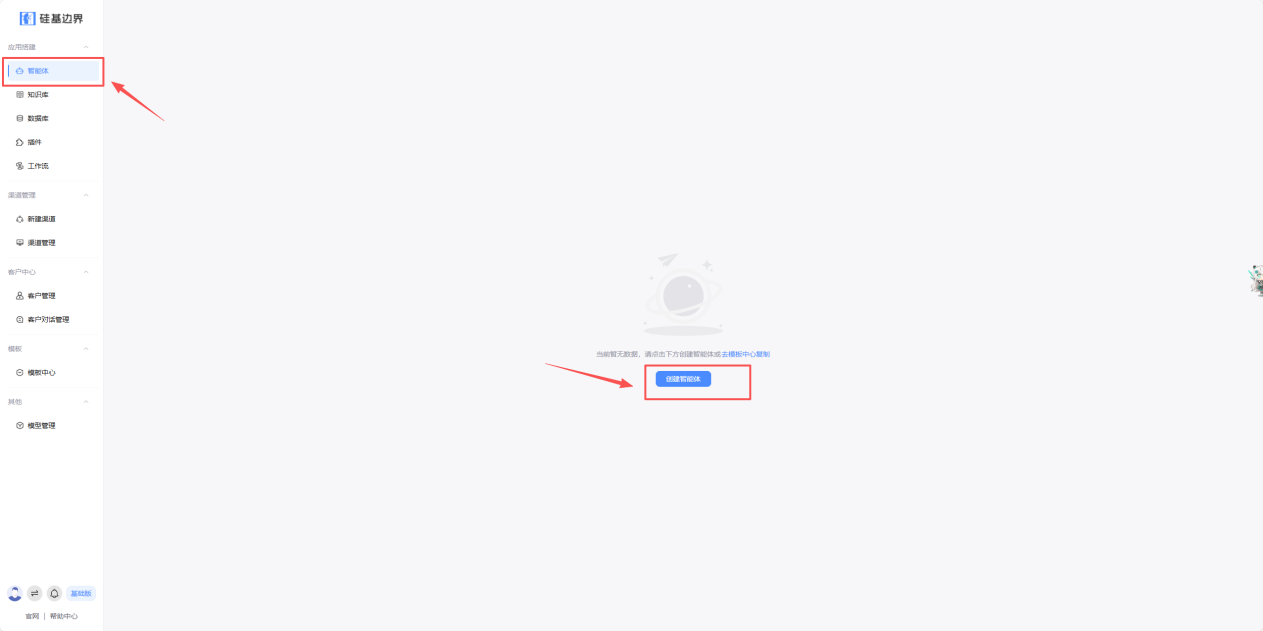
1. 创建
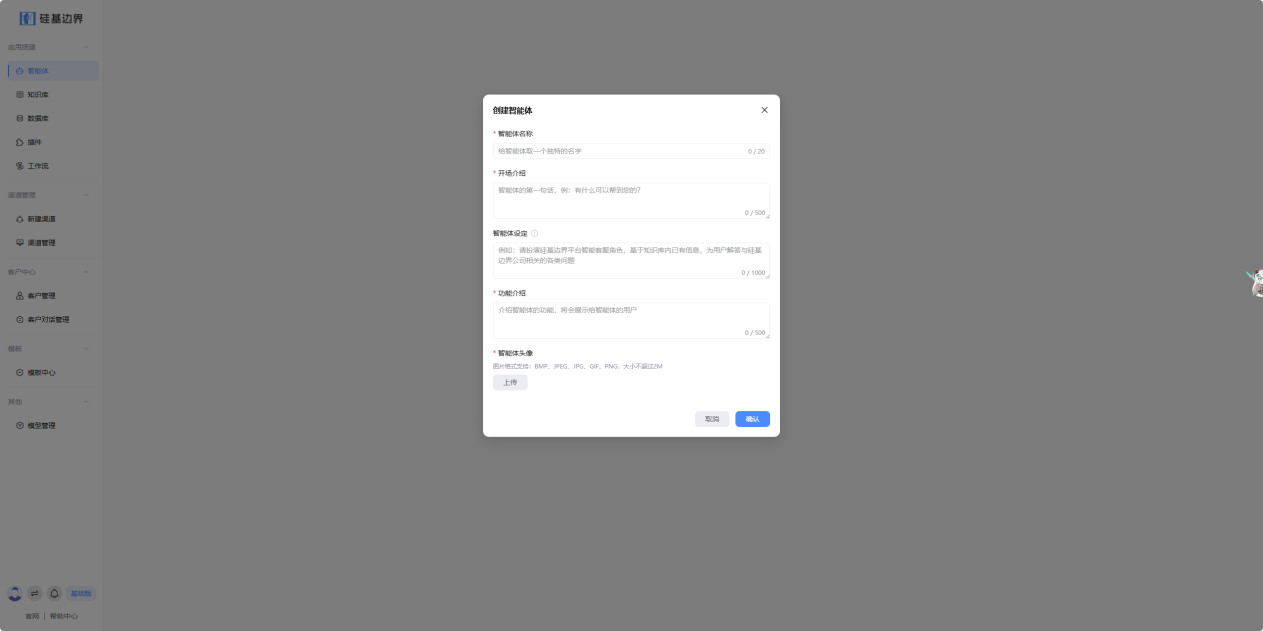
进入「智能体」板块 → 点击 创建智能体 → 按弹窗填写即可。
2. 六大配置模块
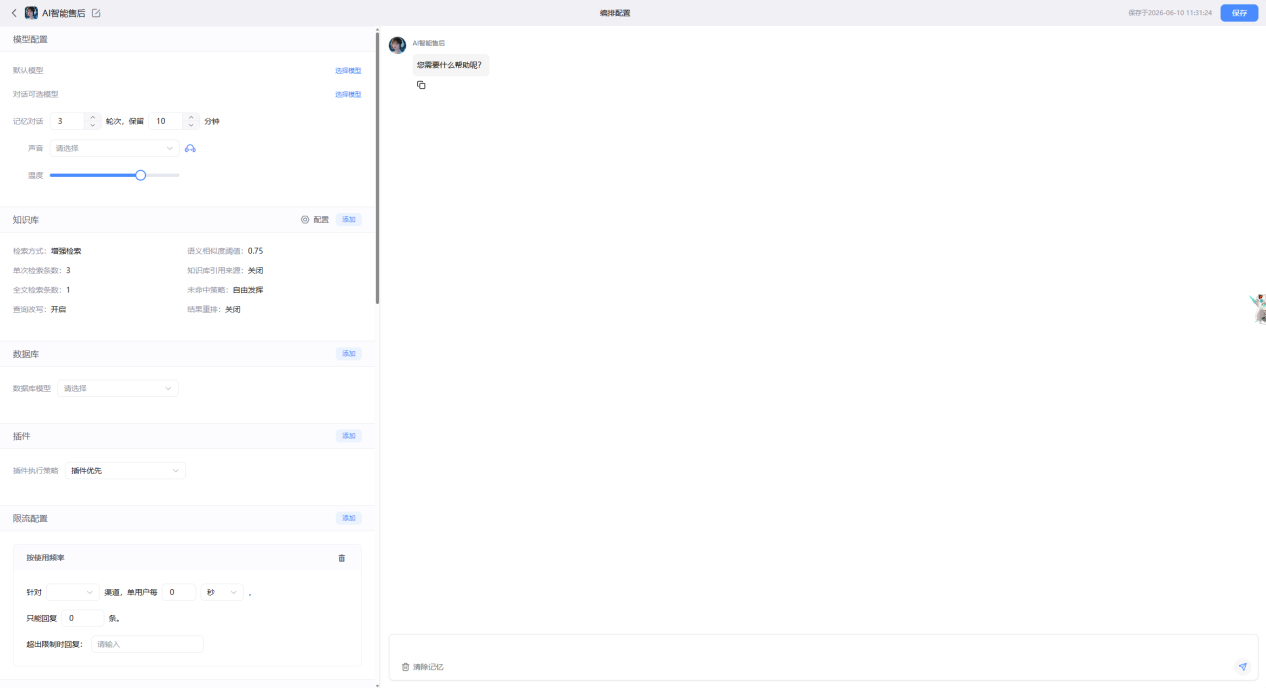
创建完成后进入配置与调试界面,右侧可实时对话调试效果(注意:每次修改需保存才生效)。
2.1 智能体设定(提示词)
这是决定智能体"像不像样"的关键,即大模型的系统提示词。好的设定要结构化表达四件事:
- 人设、对话风格、语气
- 目标 / 要完成的任务
- 禁止或限制的事项
- 回复的输出格式
2.2 模型配置
| 配置项 | 说明 |
|---|---|
| 默认模型 | 网页端对话、接入渠道时默认使用的模型 |
| 对话可选模型 | 调试 / 对话时可切换的模型列表 |
| 模型选择 | 支持多种通用大模型与行业大模型,一键切换 |
| 声音配置 | 选择音色,网页端可语音播报回复(支持企微/微信/钉钉/飞书/公众号等渠道) |
| 温度 | 越大越有创意,越小越严谨(知识库问答场景建议 ≤ 0.3) |
| 记忆 | 对话上下文保留轮次(0~50 轮) |
平台模型能力是"算力底座":预置多种通用 / 行业大模型,一处配置全局复用;同时支持接入企业自有模型(仅要求兼容 OpenAI 协议,深度求索、通义千问、智谱 AI、Kimi、以及 vLLM / Ollama / Xinference 私有化部署均可接入)。
2.3 知识库绑定
把私有文档、手册、FAQ 上传成知识库,智能体对话时自动检索命中内容来生成回答。可分别设置:
- 检索策略:决定知识如何被召回
- 未命中策略:知识库没找到时怎么兜底
2.4 数据库接入
把结构化数据关联到智能体,直接赋予大模型"访问数据库"的能力:
- 数据查询:用自然语言查数据
- 数据操作:新增 / 编辑 / 删除
- AI 数据分析:基于数据库智能分析
可单独指定用于生成 SQL 的模型,精准度更可控。
2.5 插件 / 工具
插件是给智能体"加手脚"的核心载体,类型分 SYSTEM / HTTP / MCP 三种:
- 内置插件:地图、搜索、计算、时间、网页访问,开箱即用
- HTTP 插件:接入任意 RESTful API(企业自有系统、第三方开放接口)
- MCP 插件:接入 Model Context Protocol 规范工具集
当智能体同时绑了知识库和插件,还能配置工具执行策略:
| 策略 | 说明 |
|---|---|
| 知识库优先 | 先检索知识库,未命中再调插件 |
| 插件优先 | 先调插件,不行再查知识库 |
| 知识库与插件同时执行 | 两者并行执行,综合结果作答 |
2.6 拟人化 / 转人工 / 限流 / 总结
- 拟人化(专业及以上版本):提示词优化、分段回复、合并回复、延迟回复——让对话更像真人,提升体验与转化。
- 智能转人工:按意图或关键词自动转接人工,支持通知与智能总结。
- 限流配置:按渠道(微信 / 企微 / 钉钉…)设置调用频率,防资源滥用。
- 消息总结:自动生成对话摘要,帮人工客服快速了解背景(默认 3 轮触发、最多 300 Token)。
四、记忆机制:让智能体"记住"用户
智能体的"记忆"控制对话历史上下文,配置项很细:
| 配置项 | 范围 | 说明 |
|---|---|---|
| 记忆轮次 | 0 ~ 50 轮 | 保留的对话轮数 |
| 记忆保留时间 | 0 ~ 43200 分钟 | 最长 30 天 |
配置建议速查:
| 场景 | 轮次 | 保留时间 |
|---|---|---|
| 快递 / 天气查询(一次性) | 0~2 轮 | 0~30 分钟 |
| 电商客服 / 产品咨询 | 3~5 轮 | 1~6 小时 |
| IT 排障 / 医疗问诊 | 7~10 轮 | 1~3 天 |
| 长期项目辅导 / 教学 | 11~50 轮 | 4~30 天 |
提示:轮次越多 Token 消耗越高,保留时间越长存储成本越高,需结合成本与隐私合规综合评估。
五、一次构建,多渠道 & API 可达
智能体配置调试好后,发布渠道非常灵活:
| 渠道类型 | 支持平台 |
|---|---|
| 网站 | 网页端集成(嵌入官网 / 落地页) |
| 微信生态 | 公众号、企业微信、微信客服 |
| 办公协同 | 钉钉、飞书 |
此外还提供开放 API,可把智能体 / 工作流 / 知识库能力集成进自有系统,做个性化 AI 场景开发。
六、从单智能体到多智能体协作(工作流)
单个智能体解决单点问题,复杂业务要靠工作流把多个智能体编排起来。硅基边界的工作流支持可视化拖拽,无需编码即可组合智能体、知识库、插件、意图识别、定时任务、渠道发送等十余种节点。
其中一个关键节点就是智能体节点:直接调用已创建的智能体,复用它完整的知识库 / 插件 / 数据库能力,不用重复配置。
典型玩法:
① 多智能体协作(按意图分流)
开始节点 → 意图分支
  ├── 售前咨询 → 智能体 A(产品知识库)
  ├── 售后问题 → 智能体 B(工单系统 + 售后知识库)
  └── 默认分支 → 智能体 C(通用客服)
→ 结束节点
② 智能体 + 数据库:先查结构化数据,再交给智能体做自然语言分析回复。
③ 智能体 + 大模型润色:智能体产出初稿,大模型节点格式化 / 润色后输出。
七、架构设计亮点
从技术架构角度,这套方案有几个值得关注的点:
- 一体化链路:智能体、知识库、数据库、插件、工作流、多渠道发布在同一个平台内完成,减少多系统拼接的集成成本和维护成本。
- 运营能力内置:记忆管理、限流、转人工、消息总结这些"生产级"能力是内置的,而非只停留在 Demo 阶段——这是很多自建方案容易忽略的环节。
- 模型层解耦:兼容 OpenAI API 协议,不锁定模型供应商。企业可以选择内置模型开箱即用,也可以接入自有或私有化部署的模型(DeepSeek、Qwen、GLM、Kimi、vLLM / Ollama / Xinference),按成本和合规需求灵活切换。
- 开放可集成:开放 API 可把智能体 / 工作流 / 知识库能力嵌进自有系统,适合有研发团队的企业做深度定制。
- 数据合规:支持私有化部署(Private Deployment),配合记忆轮次与保留时间的精细控制,可以满足数据不出域的合规要求。
八、总结
企业级 AI 智能体的搭建,核心不是"选哪个大模型",而是 如何把大模型、知识库、工具调用、工作流编排、多渠道发布组合成一个能扛住真实业务的系统。
技术要点回顾:
| 层级 | 关键能力 | 核心问题 |
|---|---|---|
| 模型层 | 多模型支持、协议兼容 | 不锁定供应商,按需切换 |
| 知识层 | RAG 检索、未命中兜底 | 让 AI 懂企业私货 |
| 数据层 | Text-to-SQL、安全执行 | 让 AI 动得了业务系统 |
| 工具层 | HTTP / MCP 插件 | 让 AI 长出手脚 |
| 编排层 | 可视化工作流 | 多智能体协作 |
| 渠道层 | 微信/企微/钉钉/飞书/API | 让 AI 接入业务入口 |
| 运营层 | 记忆/限流/转人工/总结 | 能扛真实业务 |
后续会继续拆解 知识库检索策略(向量检索 vs 全文检索 vs 混合检索)、工作流节点详解、私有化部署方案 等技术细节,欢迎关注后续更新。
参考文档:本文基于硅基边界技术文档整理,更多产品细节可查阅官方技术文档中心。
如果这篇对你有帮助,欢迎 点赞 / 收藏 / 关注,也欢迎在评论区聊聊你最想用智能体解决的业务场景。

中国智能体开发者社区,聚焦智能体与大模型开发,提供前沿资讯、实用工具链、开源项目及行业案例。通过技术沙龙、开发者大赛等活动,促进经验交流与协作,助力开发者快速构建创新智能应用。
更多推荐



 15
 0
- 0


 已为社区贡献1条内容

所有评论(0)