聊聊AI智能体的评估体系:怎么知道你的Agent到底行不行?
有个朋友做客服Agent,上线之前跑了50条测试用例,全对。结果上线后第一周用户反馈就炸了。Agent经常答非所问,有时候用户问退换货政策,它给人背了一段产品介绍。更离谱的是,同一个问题问两次,给出的答案不一样,用户截图发到小红书上吐槽。
问题出在哪?50条测试用例是他自己手写的,都是他熟悉的标准问法。但真实用户的问法千奇百怪,他根本没覆盖到。而且他只测了「答案对不对」,没测「效率怎么样」「安全不安全」「面对非标准输入能不能稳住」。

「答案对不对」远远不够
传统软件测试,你写单元测试、集成测试,覆盖各种分支就行了。输出是确定性的,同样的输入一定得到同样的输出。但Agent不是这样。它的输出是概率性的,同样的输入可能给你不同的回答。它的执行路径是动态生成的,你不知道它中间走了多少步、调了哪些工具。它的失败模式也不是简单的「报错了」或者「结果不对」,而是「看起来对了但实际上过程错了」或者「大部分对了但关键信息错了」。所以Agent的评估必须从单一维度变成多维度。

现在大家比较认可的评估方式大致包含这么几个维度:
1、正确性——最终输出是否准确、是否满足用户意图。这是最基础的,但也是最不够的。
2、效率——完成任务用了多少步、消耗了多少Token、花了多少时间。一个Agent能用3步完成的任务,你的Agent用了15步,那它即使答案对了也不合格,因为成本是别人的5倍。
3、安全性——有没有越权操作、有没有泄露敏感信息、有没有产生有害内容。客服Agent把用户手机号输出给其他用户,这就是安全事故。
4、过程合理性——不光看结果,还要看中间步骤。Agent走了对的路还是歪打正着?它调用的工具是否合理?它的推理链是否自洽?
5、鲁棒性——面对非标准输入、对抗性输入、边界情况,Agent能不能稳住。你把「退款」说成「把钱退回来」,它还认不认?
清华大学和微软研究院联合提出的AgentEval框架,把这些维度进一步细化为任务完成度、决策质量、工具使用效率、上下文保持能力等更细的指标。而企业级评估的新标准CLEAR框架,则更偏向实战,强调可复现性、可量化、可追踪。
AgentEval框架思路是:不能只看结果对不对,要把整个过程拆开打分,像考试不只看总分,还要看每道题的步骤分。
| 指标 | 含义 | 举例 |
|---|---|---|
| 任务完成度 | Agent 最终有没有把用户交给它的任务做成功 | 让 Agent 订一张机票,它到底订没订成 |
| 决策质量 | Agent 在执行过程中做的每一步选择是否合理 | 搜索航班时,选了最优航线还是绕了远路 |
| 工具使用效率 | Agent 调用外部工具(搜索、API、计算器等)是否精准、不浪费 | 该调一次 API 就拿到结果,而不是反复重试 |
| 上下文保持能力 | 多轮交互中,Agent 能否记住并正确利用之前的信息 | 用户第 3 轮说的约束条件,第 7 轮执行时是否还记得 |
CLEAR 则是确保这些评估结果在企业场景中可靠、可复现、可追踪。
| 指标 | 核心要求 | 举例 |
|---|---|---|
| 可复现性 | 同样的测试条件,换时间、换环境重跑,结果一致 | 今天评估 Agent 得 85 分,一周后同样输入再跑,结果不应大幅波动 |
| 可量化 | 每个维度都有具体数值,而非主观感受 | 不是 “这个 Agent 工具用得还行”,而是 “工具调用成功率 92%,冗余调用率 8%” |
| 可追踪 | 评估结果能追溯到具体环节,定位问题根源 | 发现 “决策质量” 扣分,能查到是第 5 步选错了搜索关键词导致的 |
怎么评估?从人肉到自动化
评估方法有三层,从低到高。

第一层:人工评估。人来看Agent的输出,打分或者排序。最准但最慢,而且标准会飘——同一个人看多了之后,后面的判断会受到前面看的内容影响,心理学上叫锚定效应。
第二层:自动评估,用LLM-as-a-Judge。让一个更强的模型来评估你的Agent输出质量。比如你用GPT-4做的Agent,用Claude Opus来当裁判。这是目前最主流的方案。
LLM-as-a-Judge的核心是写好Rubric(评分标准)。一个模糊的「好/不好」会让Agent在「重试→还是不好→再重试」里无限循环,好的Rubric要具体到可执行,比如:「回答是否直接回应了用户问题,没有跑题」「是否包含了必要的免责声明」「是否有事实性错误」。
OpenEvals这个开源框架提供了一整套预置的评估提示词,覆盖简洁度、正确性、幻觉度、相关性、计划遵循度等指标,直接拿来用就行。
第三层:Agent-as-a-Judge。用AI Agent来评估AI Agent,不只是打分,还能给出诊断和改进建议。这是2026年最前沿的方向,但还不够成熟,裁判Agent本身也可能有偏差。
实践中的做法是三层结合:自动评估做初筛,覆盖量大面广;人工评估做抽检复核,保证质量底线;Agent-as-a-Judge做深度诊断,找出系统性问题。
光有指标还不够,还要有基准
有了评估维度和方法,你还需要一套基准(Benchmark)来对标。2026年主流的Agent基准有这么几个:
SWE-bench——代码Agent的高考。给Agent一个真实的GitHub issue,看它能不能自己定位bug、写代码、跑测试、提交PR。目前最强的Agent能通过约70%的issue,去年这个数字还在40%左右。
WebArena——测试Agent在网页上完成任务的能力。比如「帮我订一张下周二北京到上海的高铁票」,Agent要能自己浏览网页、填表单、点击按钮。
Tau-bench——模拟真实工作场景,测试Agent在客服、销售等角色下的表现。
工具调用基准——专门测Agent调用工具的准确性,包括工具选择是否正确、参数是否准确、错误处理是否合理。
但基准也有坑,最大的坑叫古德哈特定律:当一个指标变成目标时,它就不再是一个好的指标。如果你针对SWE-bench做专门优化,你的Agent可能在SWE-bench上分数很高,但实际能力没提升多少。这叫基准污染。
还有一个坑:单Agent的基准不适用于多Agent系统。5个Agent协作完成任务,失败模式完全不同——消息传递丢失、角色冲突、死循环——这些在单Agent基准里根本测不出来。
怎么搭你自己的评估流水线
如果你要从零搭一套Agent评估体系,建议按这个路径走:

第一步,明确评估目标。你是要评估Agent能不能上线?还是评估这次prompt改动有没有让Agent变好?还是评估两个模型谁更适合你的场景?目标不同,评估方案不同。
第二步,搭分层评估管线。离线评估用标准数据集跑,开发阶段用回归测试集跑,线上用生产追踪采样跑。三层各管各的,互不干扰。
第三步,构建评估数据集。别只用标准问法,一定要包含非标准输入、边界情况、对抗性输入。最好从真实用户日志里采样,不要自己拍脑袋编。
第四步,建立持续改进闭环。评估发现问题→定位根因→修复→再评估。这个闭环要自动化,不能靠人盯着。
LangSmith和Langfuse都支持在生产环境追踪上直接跑评估,能及早发现问题。比如设置规则:每次Agent的Token消耗超过5000就自动触发评估,检查是不是陷入了冗余推理。OpenJudge是2026年值得关注的新选手,开源的AI评估和可观测平台,专为Agent设计。
说实话,Agent评估这件事,做得好的团队不多。大部分团队还停留在「跑几个case看看结果对不对」的阶段。但2026年行业共识已经很清晰了:你能量化Agent的能力,你才能改进它;你能持续评估,你才能持续迭代。
评估不是目的,是手段。但没有评估,你就不知道自己在前进还是在倒退。
学AI大模型的正确顺序,千万不要搞错了
🤔2026年AI风口已来!各行各业的AI渗透肉眼可见,超多公司要么转型做AI相关产品,要么高薪挖AI技术人才,机遇直接摆在眼前!
有往AI方向发展,或者本身有后端编程基础的朋友,直接冲AI大模型应用开发转岗超合适!
就算暂时不打算转岗,了解大模型、RAG、Prompt、Agent这些热门概念,能上手做简单项目,也绝对是求职加分王🔋
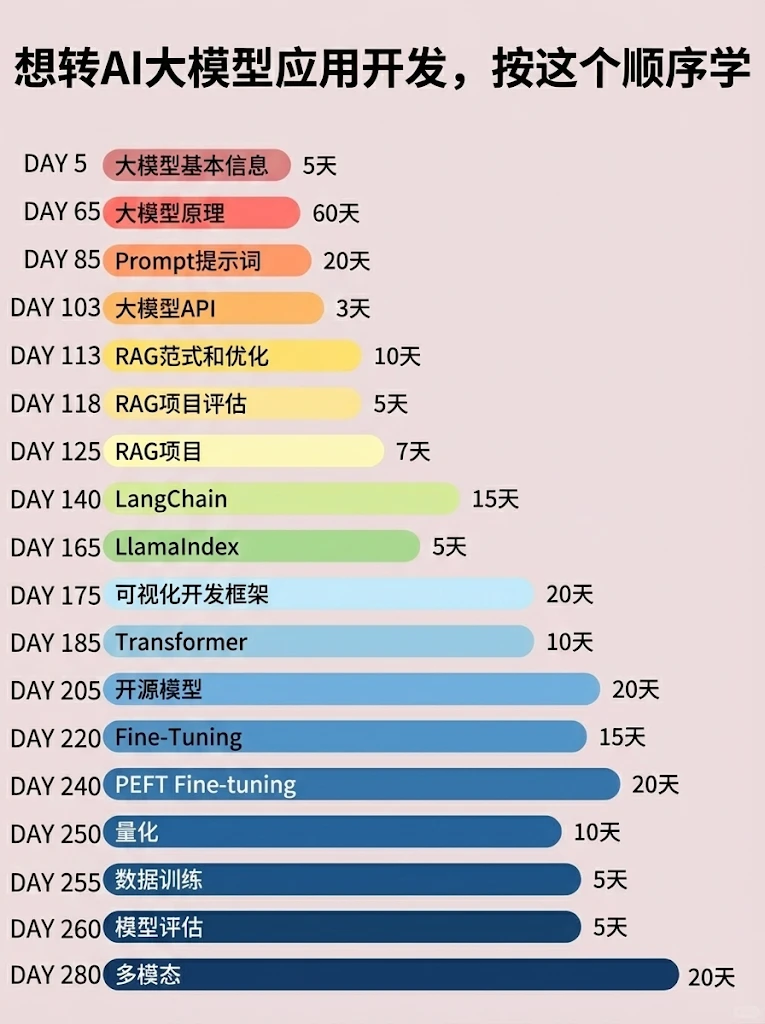
📝给大家整理了超全最新的AI大模型应用开发学习清单和资料,手把手帮你快速入门!👇👇
学习路线:
✅大模型基础认知—大模型核心原理、发展历程、主流模型(GPT、文心一言等)特点解析
✅核心技术模块—RAG检索增强生成、Prompt工程实战、Agent智能体开发逻辑
✅开发基础能力—Python进阶、API接口调用、大模型开发框架(LangChain等)实操
✅应用场景开发—智能问答系统、企业知识库、AIGC内容生成工具、行业定制化大模型应用
✅项目落地流程—需求拆解、技术选型、模型调优、测试上线、运维迭代
✅面试求职冲刺—岗位JD解析、简历AI项目包装、高频面试题汇总、模拟面经
以上6大模块,看似清晰好上手,实则每个部分都有扎实的核心内容需要吃透!
我把大模型的学习全流程已经整理📚好了!抓住AI时代风口,轻松解锁职业新可能,希望大家都能把握机遇,实现薪资/职业跃迁~
这份完整版的大模型 AI 学习资料已经上传CSDN,朋友们如果需要可以微信扫描下方CSDN官方认证二维码免费领取【保证100%免费】

中国智能体开发者社区,聚焦智能体与大模型开发,提供前沿资讯、实用工具链、开源项目及行业案例。通过技术沙龙、开发者大赛等活动,促进经验交流与协作,助力开发者快速构建创新智能应用。
更多推荐
 4
 0
- 0


 已为社区贡献422条内容

所有评论(0)