RAG 本地化部署全记录(win11) : 测试案例 台湾民法小助手
RAGFlow 是一款基于深度文档理解构建的开源 RAG(检索增强生成)引擎,能够处理复杂格式的非结构化数据并提供可靠的问答服务。以下是详细的安装过程:
目标
解决网页版大模型(如 DeepSeek)在专业领域(如台湾民法)的误答问题,通过纯本地部署实现隐私保护与精准知识库问答。
测试案例:需要一个能够解释台湾民法典的小助手,目前大模型的训练知识询问台湾民法时会错误引用大陆的民法典,因此不能直接使用网页版DeepSeek,回答也是错误的。因为这是一个小众的专业知识,类似公司内部的企业的规章制度。
根据这个需求展开
以下是基于链接博文整理的RAGFlow 本地化部署全记录(Win11)摘要,核心内容已结构化呈现:
一、核心痛点
- 数据隐私风险
- 云端模型上传文件可能导致敏感数据泄露(如企业内部规章、法律条文)。
- 文件处理限制
- 网页版限制上传文件数量/大小,无法支撑百级文件的知识库。
- 操作繁琐
- 每次提问需重复上传附件,无法动态管理知识库。
二、技术方案
| 组件 | 作用 |
|---|---|
| RAGFlow | 开源 RAG 引擎,解析复杂格式文件(PDF/Word/Excel),构建本地知识库。 |
| DeepSeek-R1 | 本地运行的生成模型(通过 Ollama 部署),输出最终答案。 |
| Embedding 模型 | 将文本转为向量(如 "凤梨"≈"菠萝"),实现语义匹配(RAGFlow 自带或配置)。 |
摘要说明
利用 DeepSeek-R1 大模型和 RAGFlow 框架,在个人电脑上完全本地化地构建一个安全、私有的个性化知识库问答系统。
-
核心目标与动机 (为什么不直接使用网页版DeepSeek?)
- 解决使用网页版 DeepSeek 的三大痛点:
- 数据隐私泄露风险: 上传文件到云端服务器处理,无法保证敏感数据(如企业制度、个人资料)的绝对安全。
- 文件上传限制: 网页版通常限制上传文件的数量和大小,无法处理庞大的专业领域知识库(几百个文件)。
- 使用繁琐: 每次提问都需要重新上传附件,无法动态管理(增删改)知识库内容,难以实现持久化的知识库。
- 解决使用网页版 DeepSeek 的三大痛点:
-
解决方案 (如何实现网页版DeepSeek不能实现的需求?)
- 隐私保护: 通过本地部署 DeepSeek-R1 模型实现,数据不出本地。
- 个性化知识库构建: 使用 RAG (检索增强生成) 技术。
- 所需核心工具/框架:
- DeepSeek-R1 (32B): 负责最终答案的生成(“说人话”)。
- RAGFlow: 开源框架,负责知识库的管理、文档的解析、检索增强流程的控制。
- Embedding 模型: 负责将文本(用户问题和知识库文档)转换为向量(“指纹”),用于相似度计算(RAGFlow 通常自带或可配置)。
-
技术核心:RAG 与 Embedding (为什么要使用RAG技术? & 什么是Embedding?)
- RAG 是什么?
- 目标: 让大模型能回答其训练数据之外(私有)的知识,减少“幻觉”。
- 原理 (开卷考试):
- 检索 (Retrieval): 当用户提问时,系统从本地知识库中查找与问题相关的文档片段。
- 增强 (Augmentation): 将检索到的相关文档片段和用户问题一起作为上下文输入给生成模型。
- 生成 (Generation): 生成模型 (DeepSeek) 结合问题和上下文片段,生成最终答案。
- 与微调 (Fine-tuning) 的区别:
- 微调 (考前复习): 修改模型参数,让模型“记住”新知识,成本高,灵活性差(知识更新需重新训练)。
- RAG (开卷考试): 不修改模型本身,通过实时检索外部知识库来补充信息,成本低,知识更新灵活(只需更新知识库文件)。
- Embedding 是什么?为什么需要它?
- 核心功能: 将自然语言文本(单词、句子、段落)转换为高维向量(一串数字)。这些向量能捕捉文本的语义信息。
- 为什么需要它 (构建“指纹库”):
- 知识库处理: 使用 Embedding 模型将知识库中的所有文档片段转换为向量(生成“指纹”)。
- 用户问题处理: 将用户提问也转换为一个向量(生成提问的“指纹”)。
- 相似度匹配: 计算用户问题向量与知识库中所有文档片段向量的相似度(如余弦相似度)。找出最相似的几个片段。
- 检索结果: 这些最相似的文档片段就是“检索”阶段的结果,被送入生成模型用于回答。
- 类比: “凤梨”和“菠萝”的向量很接近,“深度学习”的向量则离它们较远。机器通过向量距离理解语义相似性。
- RAG 是什么?
-
本地部署全流程 (核心操作步骤)
- 第一步:部署 DeepSeek-R1 , 后来我用Qwen3 和 Embedding 模型 (使用 Ollama)
- 下载并安装 Ollama (本地模型管理工具)。
- 重要配置: 设置环境变量
OLLAMA_HOST=0.0.0.0:11434(允许虚拟机访问本机 Ollama)。可能需要配置防火墙放行端口或使用 SSH 端口转发。 - (可选) 配置
OLLAMA_MODELS环境变量更改模型默认下载位置 (避免占满 C 盘)。 - 重启电脑确保配置生效。
- 使用 Ollama 下载并运行模型:
ollama run deepseek-r1:1.5b。
- 第二步:部署 RAGFlow (使用 Docker)
- 下载 RAGFlow 源代码。
- 下载并安装 Docker。
- 使用 Docker 运行 RAGFlow。
- 第三步:在 RAGFlow 中配置和使用
- 登录 RAGFlow Web 界面。
- 在“模型提供商”中添加本地运行的 DeepSeek-R1 模型 (通常是配置其 API 地址,如
http://host.docker.internal:11434,)。 - 在“系统模型设置”中选择配置好的 Chat 模型 (DeepSeek-R1) 和 Embedding 模型 (可使用 RAGFlow 自带或配置其他本地 Embedding 模型)。
- 创建知识库: 上传文件 (如 PDF, Word, Excel, txt 等)。RAGFlow 会调用 Embedding 模型自动解析文件内容并构建向量数据库(指纹库)。
- 创建聊天助手: 关联创建好的知识库,配置 Prompt (提示词) 和上下文长度 (Tokens)。
- 开始对话: 用户提问 → RAGFlow 检索相关知识片段 → 将片段+问题发送给本地 DeepSeek-R1 → 生成并返回答案。
- 第一步:部署 DeepSeek-R1 , 后来我用Qwen3 和 Embedding 模型 (使用 Ollama)
一、环境准备
-
安装 Docker Desktop:
- 从 Docker 官网下载 Windows 版安装包:https://www.docker.com/products/docker-desktop
- 安装完成后重启计算机
-
配置 Docker 镜像加速(可选,国内用户建议配置):
- 打开 Docker Desktop → Settings → Docker Engine
- 进入 Docker Engine 选项卡,修改 daemon.json 文件, 在配置文件中添加国内镜像源,例如:
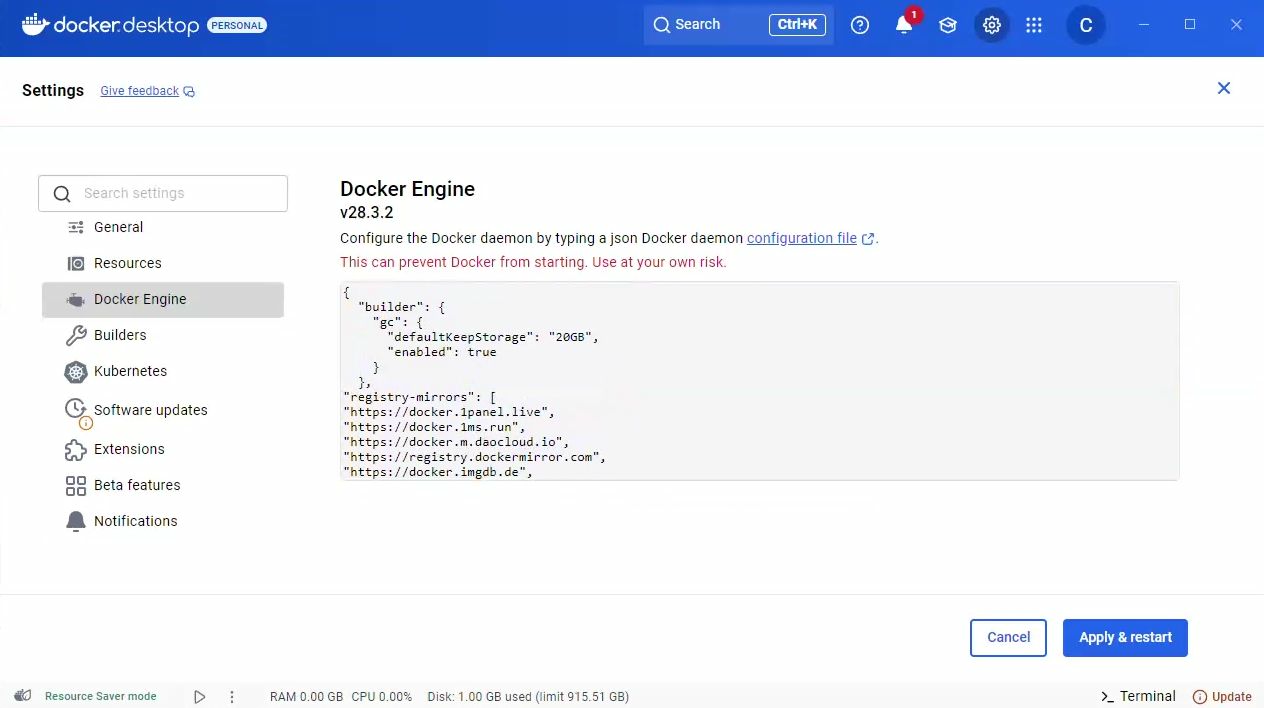
{
"registry-mirrors": [
"https://docker.1panel.live",
"https://docker.1ms.run",
"https://docker.m.daocloud.io",
"https://registry.dockermirror.com",
"https://docker.imgdb.de",
"https://hub.fast360.xyz"
]
}
点击"Apply & Restart"保存并重启
-
启动服务
根据系统选择命令:
PS C:\AI\ragflow\ragflow-main\docker> docker compose -f docker-compose.yml up -d
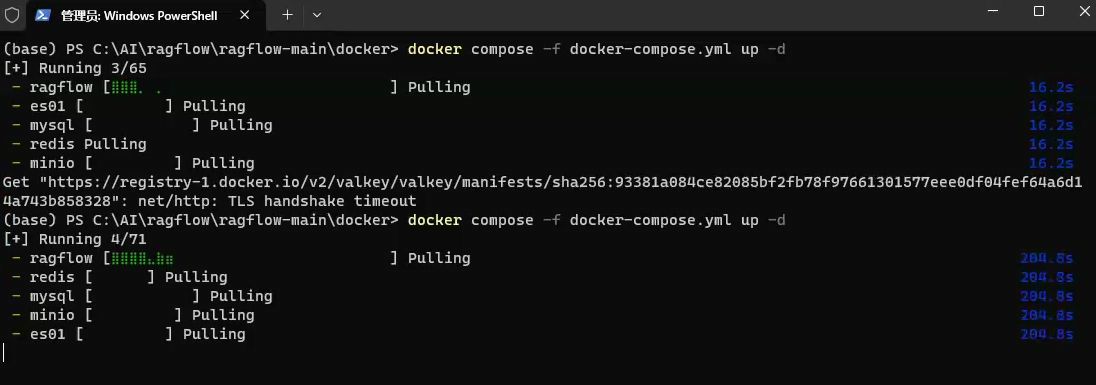
# Linux/Windows(默认CPU模式)
docker compose -f docker-compose.yml up -d

# macOS专用命令(优化兼容性)
docker compose -f docker-compose-macos.yml up -d
3.1 启动容器时报错处理
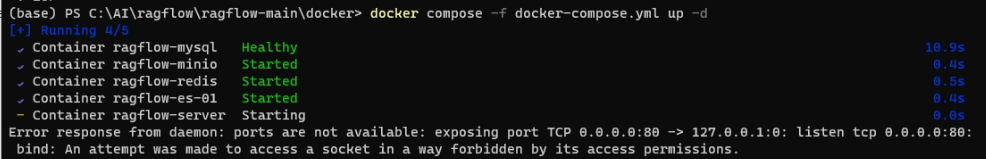
这个错误提示表明,Docker 在尝试绑定端口 80 时失败了,因为当前用户没有权限访问这个端口。在大多数操作系统中,低于 1024 的端口(如 80、443)被视为特权端口,需要管理员权限才能绑定。
解决方案
使用非特权端口
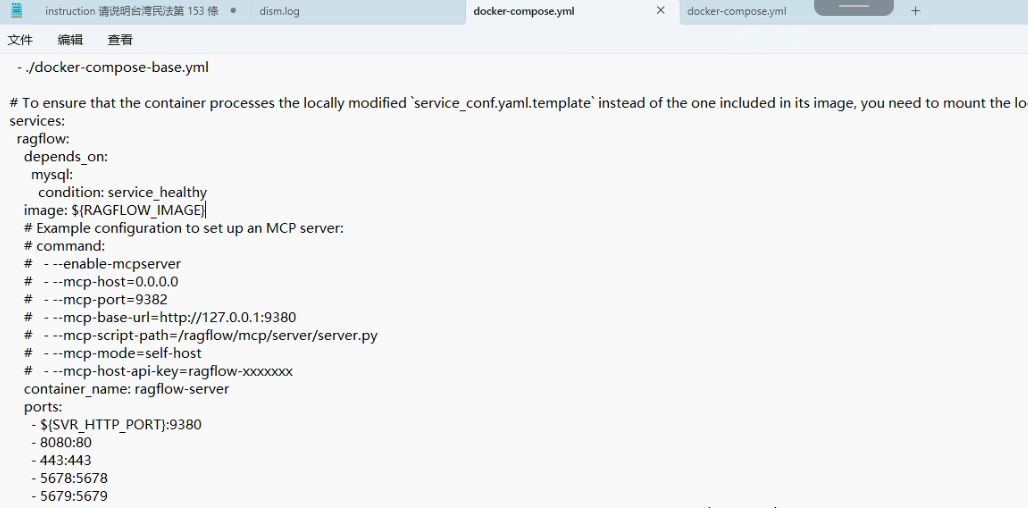
最直接的解决方案是修改 Docker Compose 文件,使用一个高于 1024 的端口(如 8080),这类端口不需要特殊权限。
编辑 docker-compose.yml 文件,将 ragflow-server 服务的端口映射从 80:80 修改为 8080:80 或其他非特权端口:
重新启动
Container ragflow-mysql Healthy
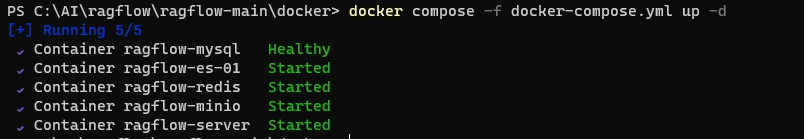
ragflow 正常启动
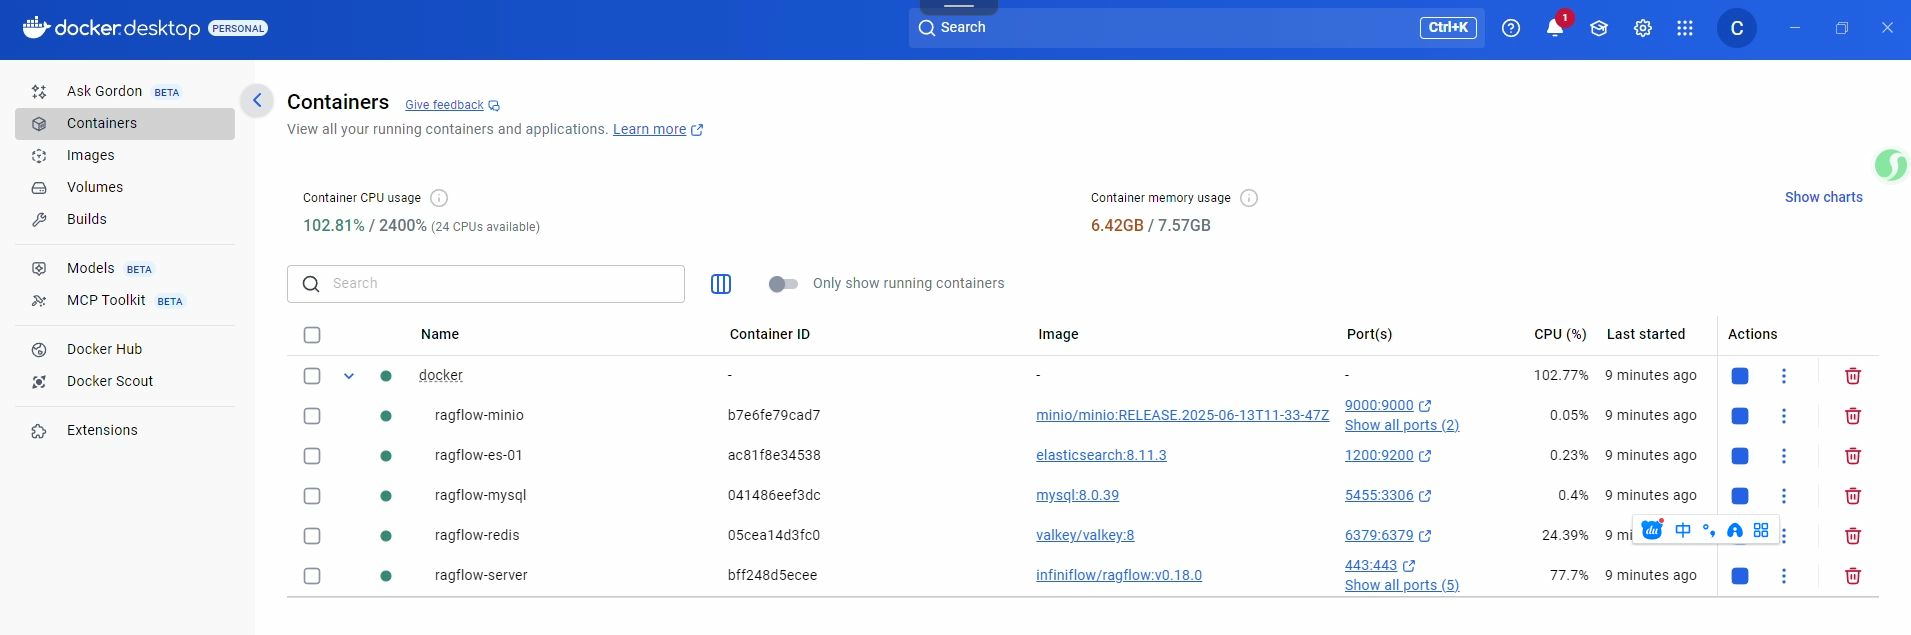
Ragflow 配置
一,服务器启动成功后再次确认服务器状态:
出现 RAGFlow 代码运行成功
docker logs -f ragflow-server
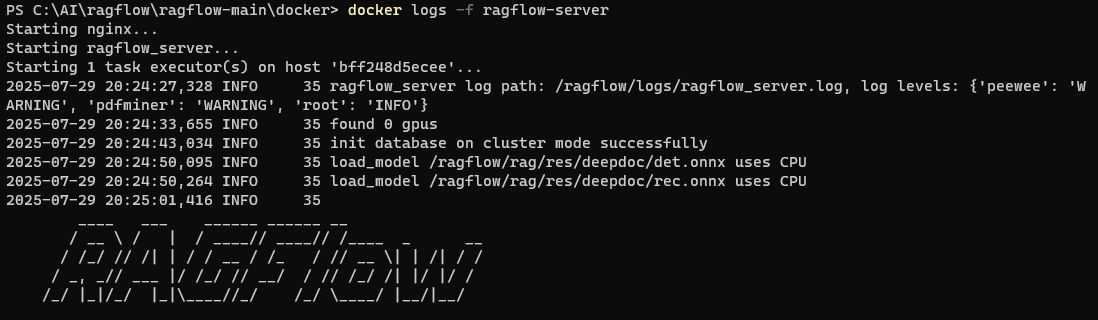
这里注意,安装完成后
要进入:http://localhost:8080 先注册账号,是下面这个页面 之前修正过 端口了

点击注册
邮箱,名称,密码 自己填写
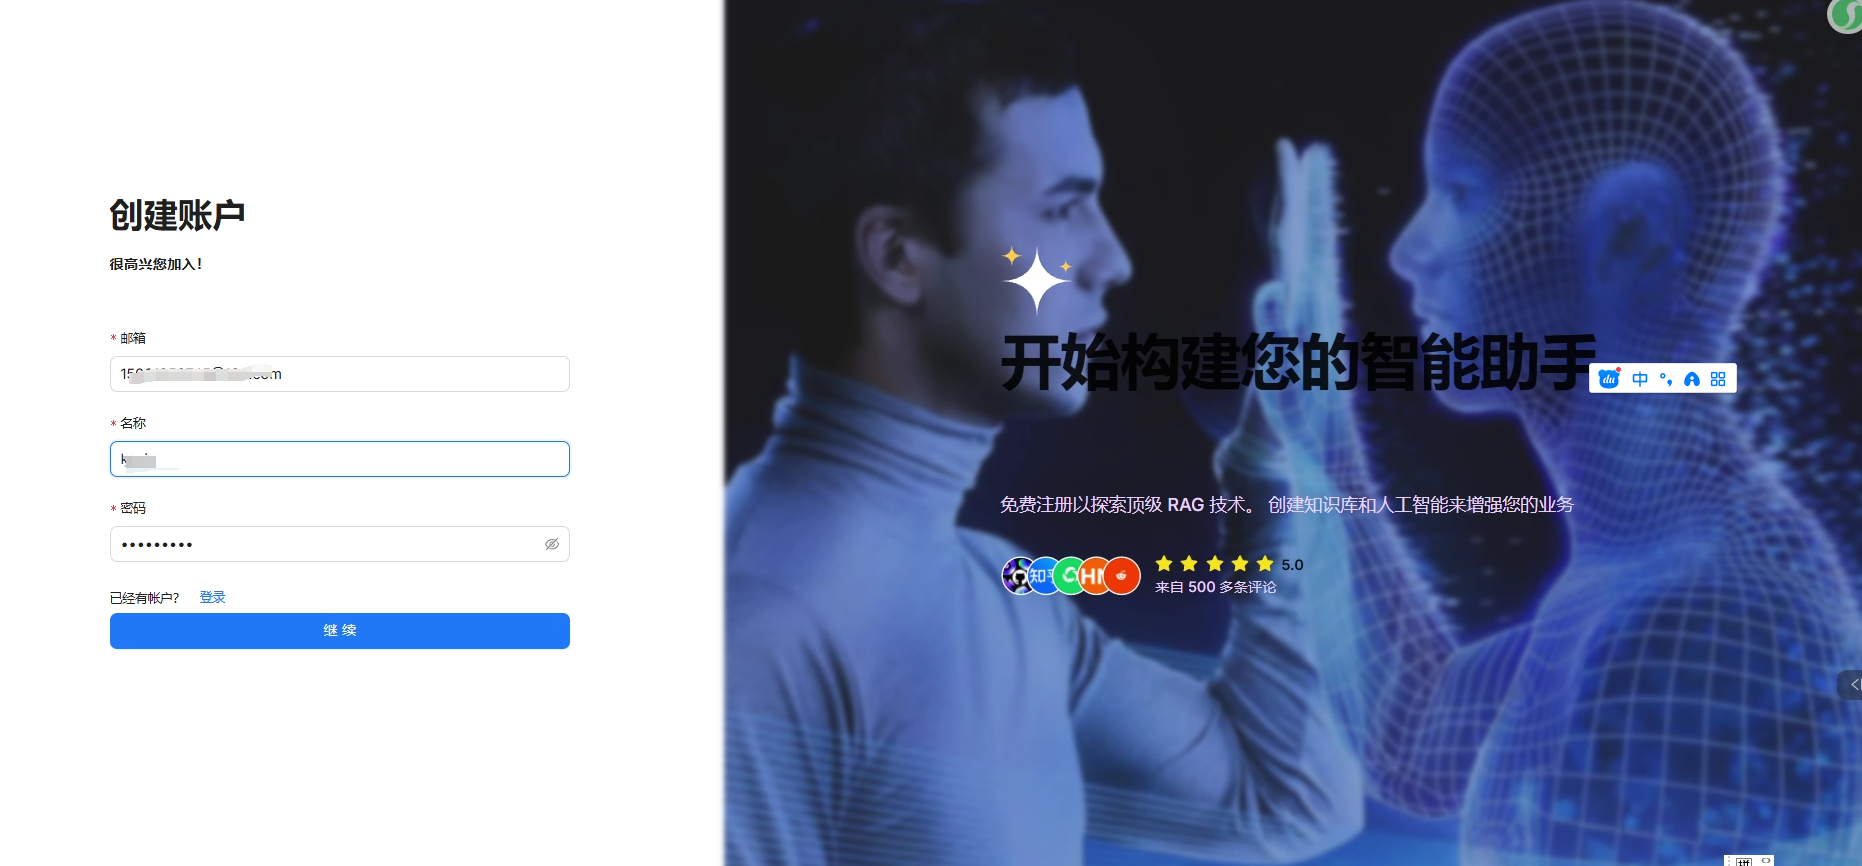
注册后页面如下
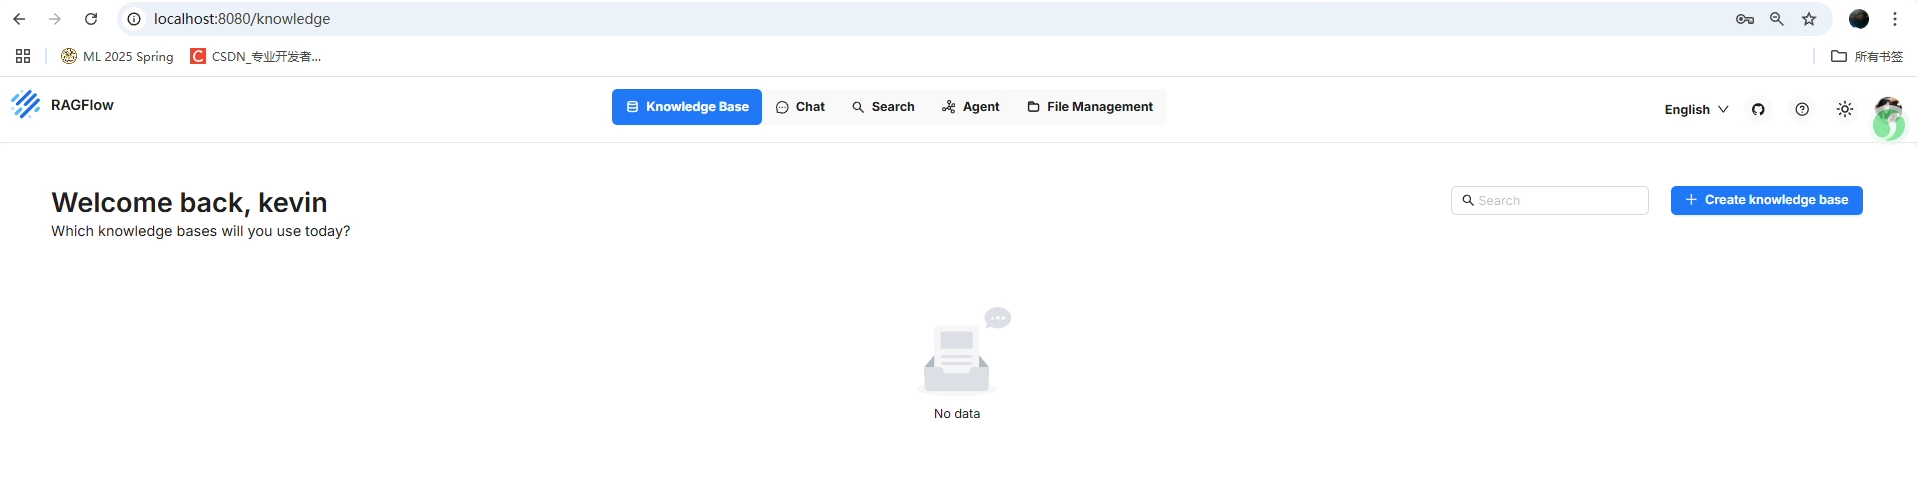 可以修改语言为 中文
二、添加模型
1.配置 Ollama 连接大模型
如下图我们先配置模型,点击右上角头像,再点击模型提供商

使用 qwen3:1.7b 时报错Fail to access model(qwen3:1.7b).**ERROR**: model "qwen3:1.7b" not found, try pulling it first
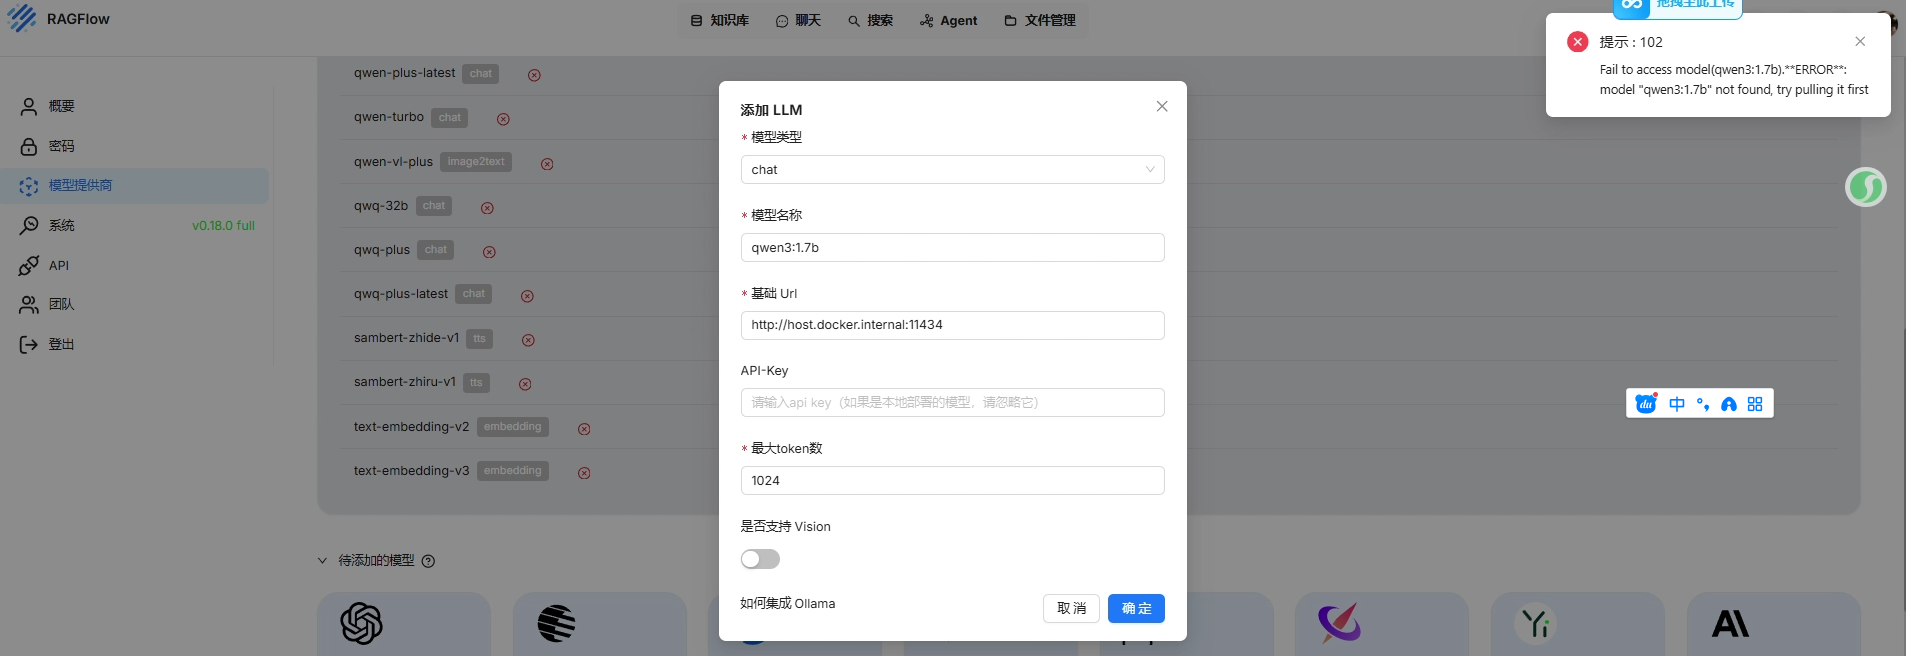
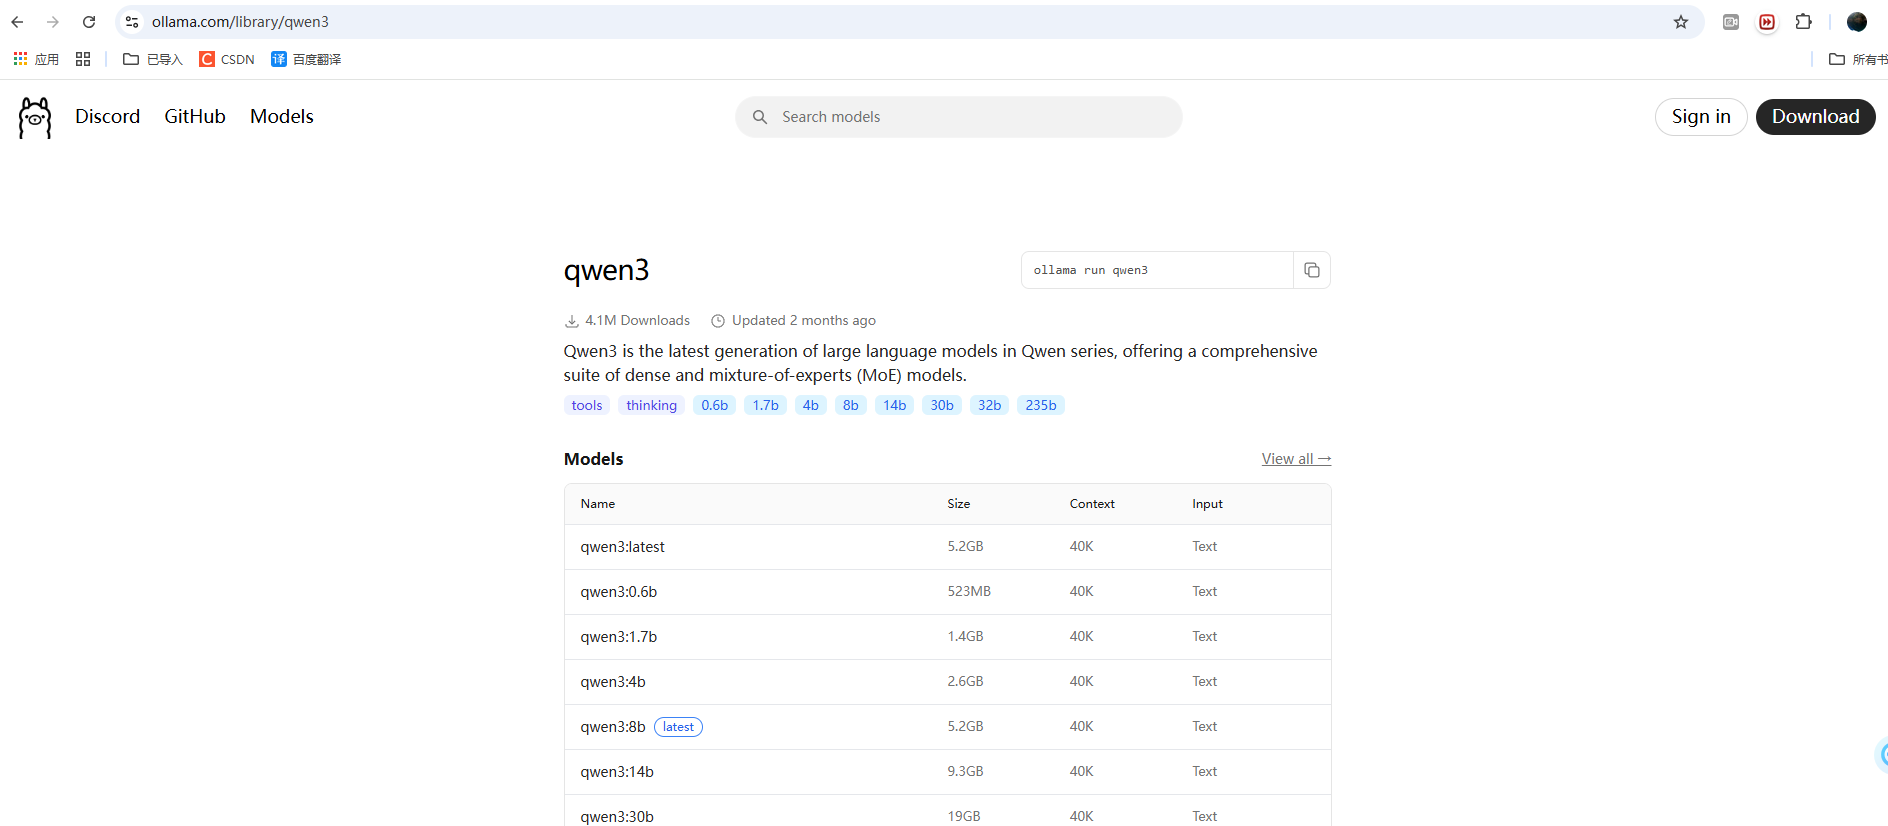
先执行pull指令,之前下过 deepseek 1.5B 所以没有报错
ollama pull qwen3:1.7b

2. 设置默认模型
嵌入模型
所有新创建的知识库使用的默认嵌入模型。如未显示可选模型,请检查你是否在使用 RAGFlow slim 版(不含嵌入模型);或根据 https://ragflow.io/docs/dev/supported_models 确认你的模型供应商是否提供该模型。

3. 建立知识库
以台湾民法为例,输入民法的法条,检查是否查询到结果是否正确。
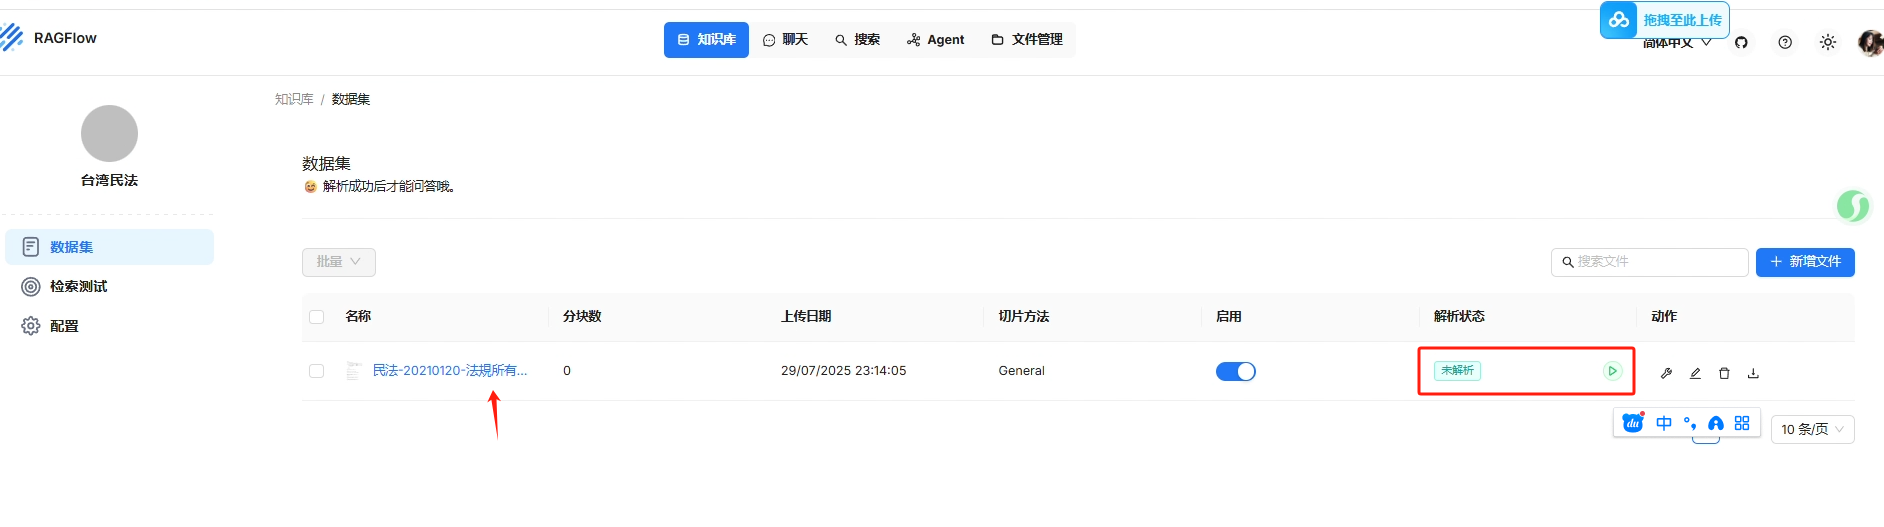
一开始是未启动状态
进行解析
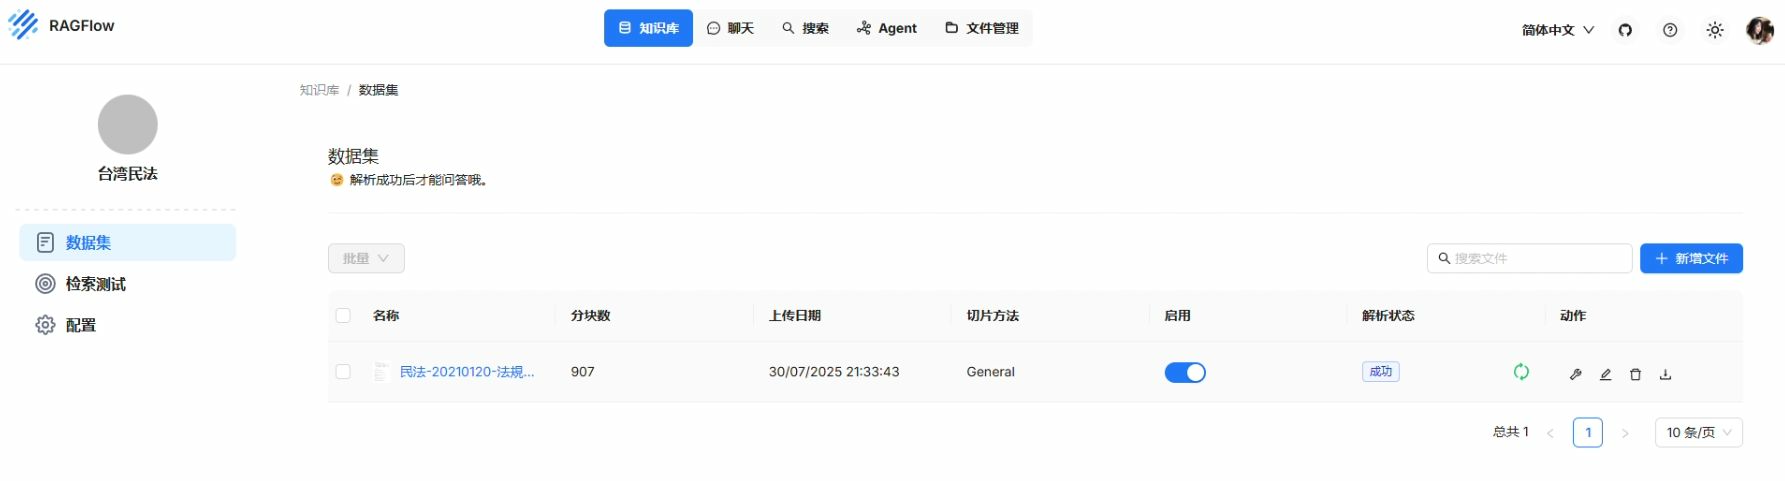
解析成功后进行测试
4.创建助理 引用知识库
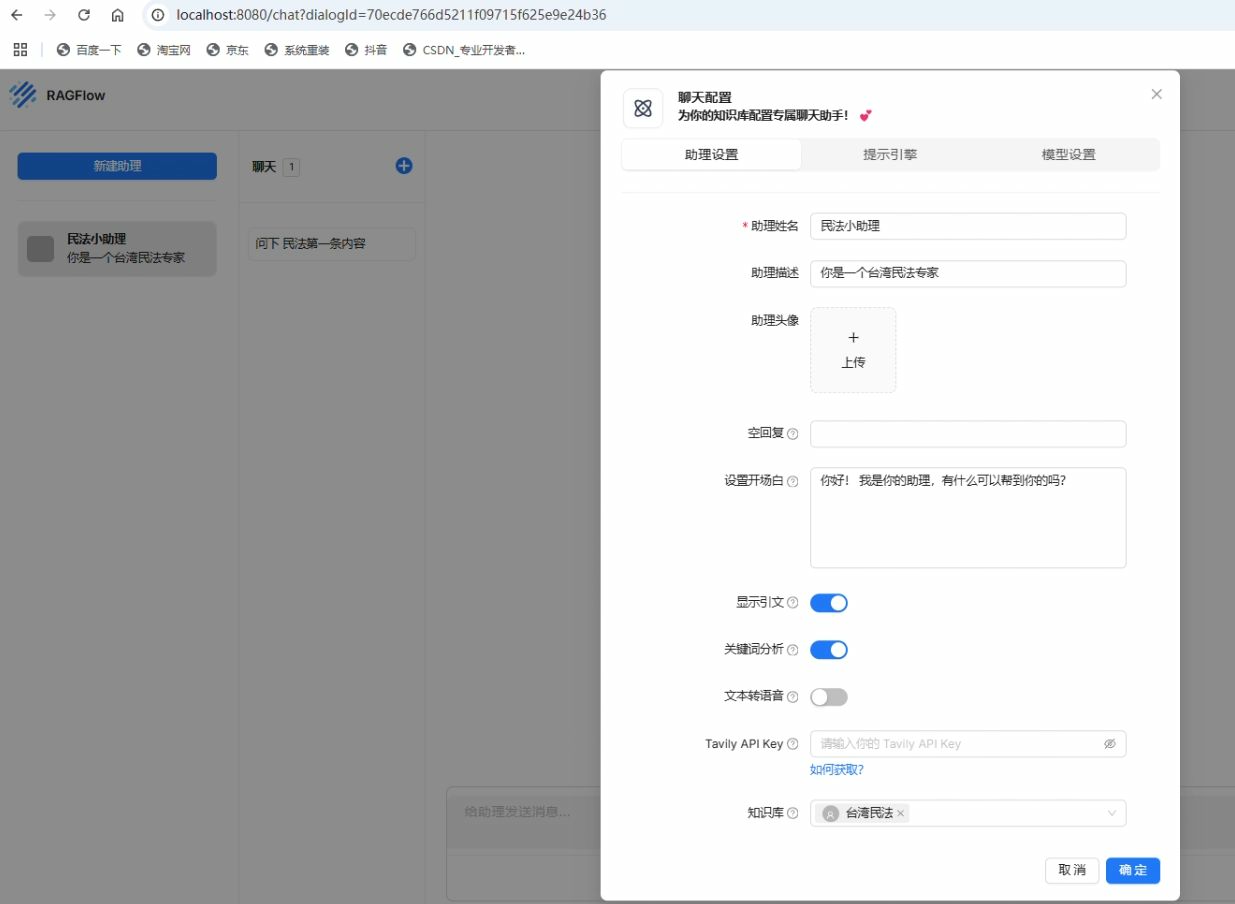
5. 验证结果
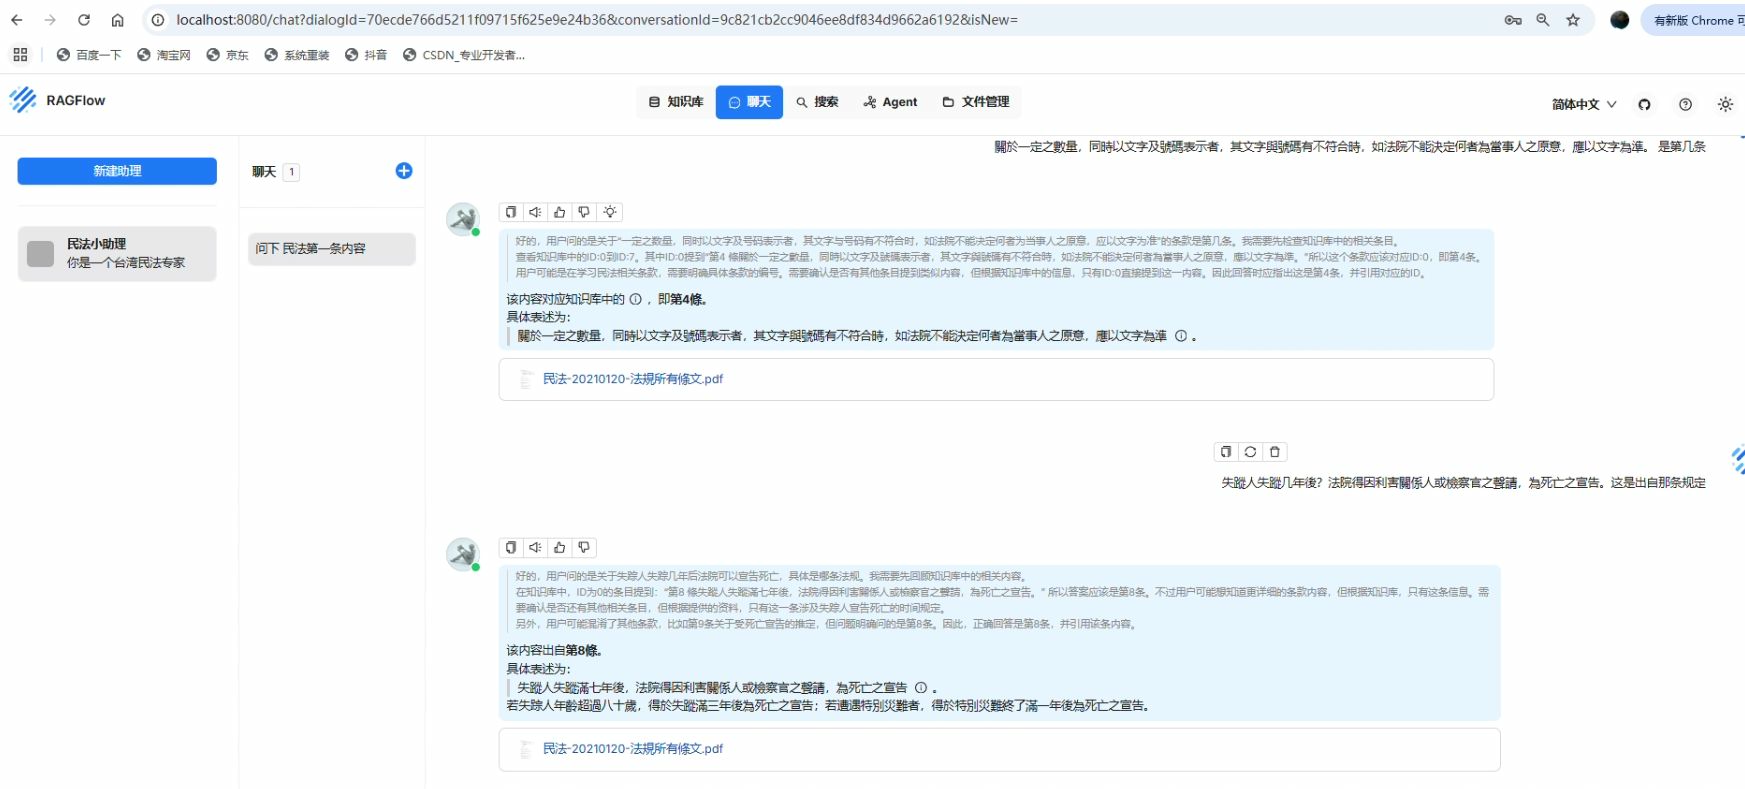
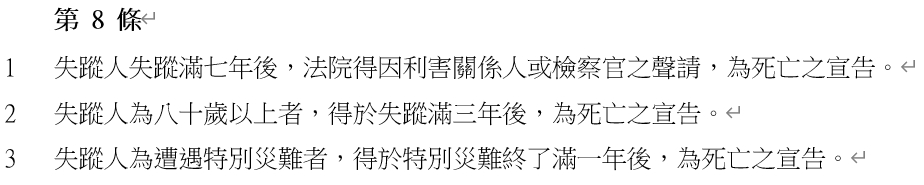
回答是正确的能够准确回答

中国智能体开发者社区,聚焦智能体与大模型开发,提供前沿资讯、实用工具链、开源项目及行业案例。通过技术沙龙、开发者大赛等活动,促进经验交流与协作,助力开发者快速构建创新智能应用。
更多推荐



 26
 0
- 0


 已为社区贡献18条内容

所有评论(0)