【文献阅读||2025|下】Controlling diverse robots by inferring Jacobian fields with deep networks
论文来源:https://doi.org/10.1038/s41586-025-09170-0 (nature)
方法论
数据收集
在数据收集阶段,作者的方法是完全自监督的,不需要任何手动的标注。采用12个相机从不同角度观察机器人,以下是数据收集的流程工作。
同时直接获取相机的内部参数:这些参数,模型才能准确地知道图像上的一个点对应到真实3D空间中的哪一条“视线”,这是后续进行3D重建的基础。
确定12个相机彼此的相对位置和朝向:作者采用3-cm April tags来校准相机的 “位姿”。April tag是一种特殊标记。当所有相机都能从各自的角度看到同一个标记时,系统就能通过三角测量原理,精确计算出每个相机在空间中的具体位置(X, Y, Z)和朝向(偏转、俯仰、翻滚)。
定义指令集:机器人是由多个“关节”或“执行器”(比如电机、气阀)控制的。我们把在某一时刻给所有这些执行器的 “指令组合” 定义为一个叫
的指令集。例如对于一个机械臂,
可能是一个包含6个数字的列表
[10, 45, -5, 0, 90, 0],分别代表6个关节的目标角度。
为每个电机通道手动设定了一个安全范围:在让机器人随机动之前,需要先手动测试,确定每个关节的活动范围是安全的,不会过度扭曲或者碰撞而损坏,确保自动化数据收集过程不会出事。
执行随机命令 :在设定的安全范围内输出一个随机指令
,等待机器人执行这个命令,因为机器人在运动的时候会有晃动和逐渐停止的过程,所以要等待其完全停止。
收集图像样本:当机器人执行完命令保持稳定之后,12个相机会同时拍照手机该时刻
的图像样本。
施加一个动作变量:作者并不是接着给出一个新的命令,而是给出一个增量指令(变化量)
,它是从一个均匀分布中随机采样的。这样的操作让AI学习的内容变得非常简单和直接,当机器处于当前状态时,施加
这个动作,会导致什么样的运动,同时通过组合不同的
,模型能预测出从任何状态出发的各种运动,提高了其泛化能力。
执行新指令:新指令
,随后机器人执行这个新指令保持稳定后再让12个相机进行拍摄图像
,此时我们就有了前后对比的图像和连接它们的桥梁-增量指令
。
提取运动信息“光流”:对于每台相机,作者使用RAFT这类算法,输入和
,算法会输出一个光流图
,这张图上的每个像素都是一个向量,指明了“这个像素从t时刻到t+1时刻移动了多少距离和方向”。
建立数据训练集:
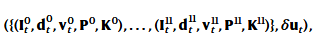
:RGB图像。
:深度图。深度图就是一张“距离照片”,它用不同的颜色告诉电脑,照片里的每一个物体离相机“有多远”。获得立体视觉,方便建立机器人3D模型,文中提到使用RGB-D相机(能捕获深度)可以加速训练。
:光流。
:第i个相机的位姿。
:相机内部参数
:增量命令。
总结:在机器人摆好一个姿势后(t时刻),我们轻轻地‘推’它一下(施加δu_t),然后看它变成了什么新姿势(t+1时刻),并用相机记录下这个‘推’的过程(光流)。我们把‘推’的力道和记录下来的运动视频打包在一起,作为一条教学视频给AI学习。
神经三维重建和神经场表示
这部分解释了如何从一张单一的图片中,重建出能够控制机器人的三维模型(神经辐射场)和运动响应模型(雅可比场)。
核心目标:输入一张来自单个摄像头的RGB图片,输出雅可比场和神经辐射场,作者使用pixeNeRF来重建这两种表示。具体流程如下:
图像特征提取:给定一个高为H,宽为W的图像的图像,将其送入一个卷积神经网络,提取一个2D特征体积
,其中p表示步长大于1的卷积产生的下采样,它存放着一张每个像素点都存储着
n维丰富信息(如形状、纹理、语义等)的“特征图”。而这个特征体积是我们后续一切3D预测的信息来源和基础。
查询空间中的某一个点:现在我们想了解机器人前方某个特定3D坐标点 的信息(雅可比、辐射度、密度)。首先利用已知的相机参数,将这个3D点
投影回2D图片上,找到它对应在图片上的哪个像素位置
。然后根据这个像素位置
,去第一步得到的特征体积
中,用双线性插值的方法,“捞”出该位置存储的n维特征向量
。
融合信息并做出预测:将来自图片的特征(告诉我们这个点看起来像什么)和点的空间位置编码
(以高频方式编码点的精确3D坐标,帮助网络理解精细的几何结构)输入到一个全连接的神经网络FC,输出这个点的所有信息(雅可比、辐射度、密度,构成雅可比场和神经辐射场)。具体公式如下:
使用可微渲染进行训练
核心目标:通过可微分渲染将3D场的预测与2D的监督信号连接起来,因此,我们可以通过梯度下降,根据2D渲染结果上的损失,反向传播误差,一路更新到最开始重建3D场的那个神经网络。使模型学习一个精确的3D辐射场(以正确渲染新视角图像)和一个精确的3D雅可比场(以正确渲染新视角下的运动),从而实现了仅从2D视觉观察中学习3D结构和运动规律的目标。
在每一次训练迭代中,我们会随机选择两个相机:源相机和目标相机。源相机提供输入图像,目标相机提供监督信号,我们将模型的预测结果与这个相机实际拍到的图像和计算出的光流进行对比。
整个训练过程可以概括为以下部分:
定义一条视线:对于目标相机图像上的每一个像素,我们定义一条从相机原点出发,穿过该像素的射线
:
。其中
表示相机在3D空间中的位置。
表示从相机指向该像素方向的单位向量。
表示沿着射线的距离。
体积渲染-预测深度和颜色:为了预测这条射线对应的像素应该是什么颜色,我们需要沿着这条射线,在 和密度
,然后我们通过体积渲染积分(体绘制)来合成最终的RGB
和深度
图像:
预测颜色公式:。
预测深度公式:。
其中:,
通过alpha合成表示遮挡。这代表射线从起点
传播到当前点
而没有被阻挡的概率。它就像一个累乘的透明度。如果射线前方已经有一个密度很高的点(很可能是物体表面),那么
就会变得很小,意味着后面的点对最终颜色的贡献就很微弱。这自然地处理了遮挡关系。
体积渲染-预测光流:这是本文的创新核心,用雅可比场预测运动。对于同一条射线
上的每个3D样本点
,我们有其雅可比矩阵
和其导致运动的指令
,根据雅可比场的定义
。
于是,这个点运动后的新位置是:(代表原始射线所对应的3D质心)和
(代表运动后射线所对应的3D质心)
:
原始射线对应的3D质心公式:。
运动后射线对应的3D质心公式:。
最后,我们将这两个3D质心投影到目标相机的2D图像平面上,并计算它们的像素坐标之差。这个差值就是模型预测的光流。
预测光流公式:。
现在,我们有了
-
预测的目标图像
和 真实的目标图像
。
-
预测的目标光流
接下来我们就可以构造损失函数来对模型进行优化了,因为我们使用可微渲染,整个从3D场到2D渲染结果
的流水线都是可微分的。这意味着我们可以从2D的损失函数出发,通过反向传播,计算梯度并一路更新到最开始重建3D场的神经网络。
监督机器人的几何形状(使用RGB-D渲染)
这一部分的目标是让模型重建的3D机器人形状和外观尽可能准确。
监督信号来源
-
RGB图像:目标相机实际拍到的彩色图片。
-
深度图:目标相机同时捕获的深度信息(来自RGB-D相机)。
损失函数
RGB损失:
-
:模型通过体积渲染(公式3)预测出的目标视角图像。
-
:目标相机实际拍摄到的真实图像。
-
作用:这个损失迫使模型学习到正确的颜色(c) 和密度(σ) 场。如果预测的颜色不对,说明模型的3D几何或外观理解有误。这是学习神经辐射场的核心驱动力。
深度损失:
-
:模型通过体积渲染(公式4)预测出的目标视角深度图。
-
:目标相机实际测量到的真实深度图。
-
作用:这个损失提供了强大且直接的3D几何监督。它明确地告诉模型:“你预测的这个点的3D位置应该是离相机这么远,而不是那么远。” 这极大地加速和稳定了3D几何的学习。
传统的NeRF通常只靠RGB损失来学习几何,但这过程可能很慢且不稳定。由于作者使用了消费级RGB-D相机,深度信息是现成的,所以加入这个可选的但极其有效的深度损失,相当于给模型请了一位“几何大师”,让学习效率大增。
监督雅可比场(通过预测2D运动)
监督信号来源
-
真实2D光流:使用现成的光流算法(如RAFT)计算出的、目标相机视角下真实的像素运动
引起的。
光流损失:
-
:模型预测的光流。它是通过雅可比场和体积渲染计算出来的。
-
:从视频中计算得到的真实光流。
-
作用:这是学习雅可比场的唯一驱动力。如果预测的光流和真实光流不一致,说明模型对“哪个指令控制哪个3D点运动”的理解是错误的。通过最小化这个损失,模型被逼着去调整雅可比场
,直到它能通过渲染出的光流准确匹配真实观测到的运动。
雅可比场的细节
这里作者说明为什么要提出雅可比场这个概念,以及它如何革命性地解决了传统机器人控制中的根本性难题。
传统的机器人控制系统被建模为一个动力系统:。
-
:系统的状态向量。对于传统刚性机器人,这就是所有关节角度的集合。例如,一个6轴机械臂的状态
q就是一个6维向量。 -
-
后,机器人会进入什么新状态
因为模型通常是非线性的,为了控制方便,我们会在一个工作点
。这里
称为系统雅可比,一个
m x n 的矩阵,它描述了在特定状态 下,指令的微小变化
作者论述了这种方法的瓶颈,即对于软体或混合刚柔机器人,其状态是无限维的,因为它每一个点都可能连续变形,你无法用有限的几个关节角度来定义它的全部形状。难以设计一个完全定义机器人状态的状态向量,同时需要用传感器去测量状态
。对于软体机器人,给每一个点都嵌入传感器来测量其变形是不现实且不通用的。
因此基于传统方法的困局,作者提出了一个新的雅可比场。:一个存在于3D空间中的场。对于空间中的任何一点
x,变化。这和依赖于抽象状态
首先,作者将神经辐射场和视觉动态雅可比场结合起来表达机器人完整状态,它编码了机器人的3D形状和运动学(在任何的可能动作中每个3D点的运动),这使得直接跳过设计状态向量。
其次作者发现仅从视觉上就能发现机器人的3D配置,即使部分被遮挡也可以正确判断它们的3D位置。这位后续通过单摄像头就能建模3D形状奠定基础。
作者推导出雅克比场与我们用于监督的每个相机2D光流之间的联系:
-
是模型预测的、在执行指令
u后应该达到的状态。在我们的设定中,这就是时间t的状态。 -
是执行了新指令
后,在时间
t+1测量到的实际新状态。
等式左边的物理意义是:系统的实际终结状态与模型预测的起始状态之间的差距,所以,公式描述的是:“状态的变化量” = “雅可比矩阵” × “指令的变化量”。此时,这个“状态的变化量”还是一个包含了模型误差的、比较“粗糙”的量。
机器人执行完一个指令 u 后,我们等待它所有的惯性、振动、阻尼都消失,完全静止下来。在这个状态下,机器人的状态 q 不再变化。因此:u 下,动力学模型预测机器人的状态将保持为
所以我们把条件带入上面的公式:,由此公式变为下式子:
由于我们将机器人的稠密3D位置点定义为机器人的状态,状态变化
我们无法直接测量3D运动场
给定一个训练数据样本,将视觉运动雅可比场
通过公式
将两个信号
关联起来,其中
表示来自神经场的三维坐标样本。这个公式描述了一个 “前向预测” 的过程:给定一个学习到的雅可比场和一个机器人指令,预测出从第
i 个相机视角将会观测到的2D光流场。
render(...) (函数):可微分体积渲染函数。这是一个高级函数封装,代表了从输入(雅可比场、指令、相机参数)到输出(完整的光流图)的整个复杂流程。它不关心内部具体如何实现,只定义输入输出关系。像是编程中的一个高级函数调用,隐藏了内部复杂的实现细节。其内部核心公式为。
视觉运动雅可比场的目标是输入一个指令
,输出一个精确的运动场
,我们将模型预测的
的预测不准确,需要调整其参数。
整个循环中,动作(
轨迹跟踪
这一部分阐述了如何利用训练好的视觉运动雅可比场 来完成实际的机器人控制任务。
核心思想是:将高级任务(如“模仿一段视频”)转化为优化问题,并用雅可比场来求解。
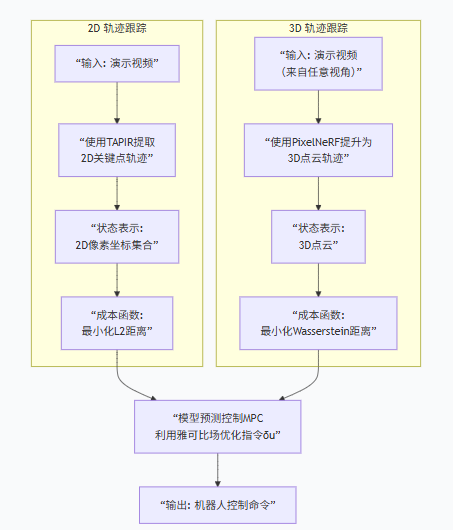
无论是2D还是3D跟踪,都采用了一个叫做模型预测控制 的框架。它的工作原理可以概括为:
-
观察当前状态。
-
使用一个模型(在这里就是雅可比场),预测在未来一小段时间内,不同的指令
-
选择一个能使预测状态最接近目标的指令 来执行。
-
移动到下一个时间步,重复上述过程。
这是一种闭环控制,因为每一步都根据最新的观察重新规划,能不断修正误差。
2D轨迹跟踪
目标:让机器人在当前的相机视角下,其表面的关键点严格遵循一条在2D图像平面上定义好的轨迹。
关键步骤:
-
轨迹获取:
-
来源:来自一段演示视频。
-
方法:使用TAPIR(一个先进的点追踪算法)在视频中跟踪机器人表面的关键点。为了更精准,会先用一个基础模型(如SAM)生成机器人的分割掩码,确保TAPIR只跟踪机器人本身的点,而不是背景。
-
结果:得到一系列2D点坐标,构成了目标轨迹。
-
-
状态表示:
-
状态就是这些被跟踪关键点在当前图像中的2D像素坐标。
-
-
优化与控制:
-
任务:找到指令
-
工具:雅可比场。对于图像中的每个像素(关键点),雅可比场可以预测出在执行
后,该像素会移动多少(即2D光流)。
-
成本函数:L2距离(即两点之间的直线距离)。优化器的工作就是最小化所有关键点的预测位置与目标位置之间的L2距离之和。
-
处理遮挡:系统会使用“可见性掩码”,如果某个关键点被遮挡了,就在优化时忽略它,避免产生错误信号。
-
适用场景:非常适合模仿学习。例如,你用手拿着机器人的手做一次动作,录下来,它就能在同样的相机视角下模仿这个动作。
3D轨迹跟踪
目标:让机器人的整体3D形状在三维空间中遵循一条定义好的轨迹。这种方法与视角无关。
关键步骤:
-
轨迹获取:
-
来源:同样来自演示视频,但该视频的视角可以在部署时不可用。
-
方法:使用 PixelNeRF 将演示视频的每一帧都提升为一个3D点云。这些点云是从重建出的高密度区域采样得到的,代表了机器人在每个时刻的完整3D形态。
-
结果:得到一系列3D点云,构成了在3D空间中的目标轨迹。
-
-
状态表示:
-
状态是机器人当前的3D点云,由单目相机图像通过PixelNeRF实时重建得到。
-
-
优化与控制:
-
任务:找到指令
-
工具:雅可比场。对于当前点云中的每一个3D点,查询其雅可比矩阵
,计算
-
成本函数:Wasserstein-1距离(也称推土机距离)。
-
为什么不用L2? 在3D中,两个点云之间没有一一对应的点。Wasserstein距离衡量的是将一种分布(当前点云)的形状“移动”成另一种分布(目标点云)的形状所需的最小工作量。它更关注整体形状的匹配,而不是单个点的位置,因此更鲁棒。
-
-
适用场景:视角迁移。例如,你从正面录了一段演示视频,但部署时只有一个侧面相机,3D跟踪依然能工作。它也适用于需要精确控制末端执行器在3D空间中运动的任务(如书写、绘制)。
这一节揭示了雅可比场的最终价值:它作为一个可微分的动力学模型,使得我们能够通过梯度优化的方式,将复杂的机器人控制问题(轨迹跟踪)转化为数学上的优化问题,从而实现了强大而灵活的控制能力。
实验评估
这一节是论文的实验验证部分,它通过一系列严谨的、多角度的实验,有力地证明了所提出的“视觉运动雅可比场”方法的有效性、优越性和鲁棒性。
消融实验
消融实验的核心目的是:通过移除或替换方法中的关键组件,来证明这些组件为何是必要且有效的。
1. 雅可比参数化消融
-
对比对象:一个“直接预测光流”的基线模型。这个基线模型不预测雅可比场
J(x, I),而是直接从一个输入图像和指令δu,预测出最终的光流图。 -
科学问题:为什么我们的方法(先预测
J,再通过δx = J δu计算光流)比直接预测光流更好? -
关键发现:我们的方法注入了三种对机械系统至关重要的归纳偏置:
-
线性:在小的指令变化
δu下,点的运动响应δx是近似线性的。我们的公式δx = J δu直接编码了这一特性,而黑箱网络需要从数据中艰难地学习它。 -
空间局部性:一个执行器通常只影响机器人的某个局部区域。我们的雅可比场自然地学习这种局部响应。
-
组合性:一个复杂的运动是由多个执行器的效果组合而成的。我们的线性公式
J δu本质上是可组合的。
-
-
结论:正是这些内置的物理直觉,使得我们的方法比纯粹的“黑箱”网络具有更好的泛化能力和样本效率,尤其是在面对训练时未见过的机器人配置和指令时。
2. 神经渲染消融
-
对比对象:一个“以深度图为输入”的模型。这个模型跳过了从单张RGB图像进行神经3D重建的步骤,直接使用深度图作为输入来预测雅可比场。
-
科学问题:从单张图像进行神经3D重建是否是必要的?直接给模型深度图会不会更简单、更好?
-
关键发现:直接输入深度图的模型失败了。它无法解耦不同表面对不同执行器的敏感性,预测出了错误的雅可比。
-
原因分析:这是因为缺乏多视角监督。神经渲染训练要求模型从多个视角一致地解释同一个3D结构,这个过程迫使模型学习一个真正3D的、几何一致的表示。而直接输入深度图,模型只是一个2.5D的处理器,无法理解被遮挡部分的几何和运动关系。
-
结论:从单张图像进行神经3D重建是整个系统成功的关键,它提供了理解机器人完整3D形态和运动所必需的多视角几何一致性。
解析基线对比
这部分旨在将我们数据驱动学到的模型,与基于物理定律的黄金标准进行对比。
1. Allegro 手
-
对比对象:在Drake物理仿真器中,使用Allegro手的精确URDF模型计算出的解析雅可比矩阵。这是传统机器人学的“真理”。
-
对比方法:通过普氏分析将我们预测的雅可比场与解析雅可比场进行对齐,然后计算对应向量之间的角度偏差。
-
结果:平均误差仅为 7°。这表明,我们的方法仅从视觉观察中,就学习到了与第一性原理推导出的物理模型高度一致的动力学规律,这是一个非常强有力的证据。
2. HSA 平台
-
对比对象:一个来自前人工作的2D解析动力学模型。该模型无法处理平台的3D扭转变形。
-
结果:我们的方法不仅能稳健地处理3D运动,而且其泛化能力超出了这个简化解析模型的限制。
-
结论:对于难以精确建模的软体或复合结构系统,我们的视觉学习方法反而能捕获到比简化解析模型更复杂、更真实的物理行为。
鲁棒性分析
检验方法在非理想、充满干扰的真实世界中的表现。
1. 对抗视觉遮挡
-
方法:在训练时使用了领域随机化。具体来说,他们将分割出来的机器人前景,粘贴到随机的背景和自然场景图片上。
-
技术:使用Segment Anything模型自动生成高质量的分割掩码。
-
效果:这种数据增强技术让模型的神经3D重建模块对视觉杂波和部分遮挡产生了韧性。即使部分被遮挡,模型也能根据可见部分推断出被遮挡部分的几何形状和运动特性。
2. 对抗场景扰动
-
测试:在测试时引入巨大的视觉干扰物(如纸板围栏),改变了环境的几何和外观。
-
结果:即使在如此极端的干扰下,使用Allegro手进行3D轨迹跟踪,依然达到了 2.89° 的中位数关节误差。
-
结论:证明了系统不仅仅是在“温室”环境下工作,而是能够应对真实世界中的复杂和动态变化。
机器人系统
从四个机器人覆盖了从刚性到柔性,从传统电机到气动,从高精度到低成本的整个谱系,充分证明了该方法的广泛适用性。

中国智能体开发者社区,聚焦智能体与大模型开发,提供前沿资讯、实用工具链、开源项目及行业案例。通过技术沙龙、开发者大赛等活动,促进经验交流与协作,助力开发者快速构建创新智能应用。
更多推荐



 4
 0
- 0


 已为社区贡献3条内容

所有评论(0)