揭秘国产Lerwee运维智能体的场景,它是如何让小白也能快速上手?
目录
Lerwee监控
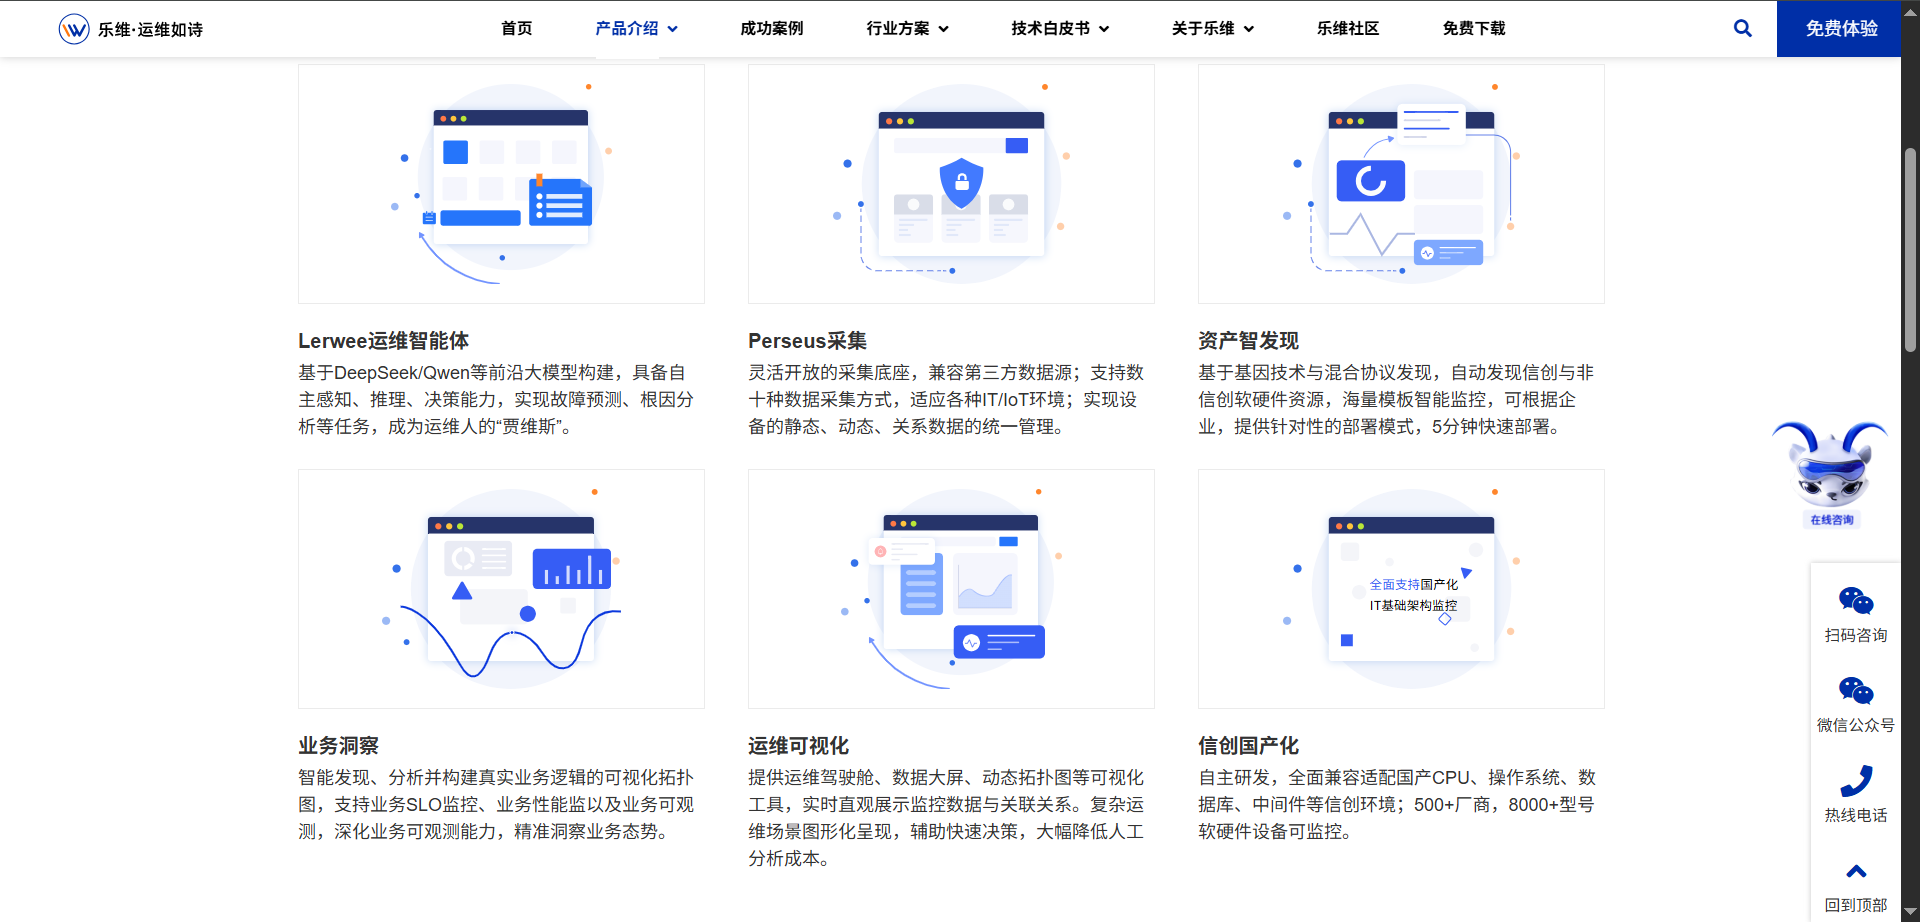
首先,我先介绍下乐维的官网,可以看到官网上,监控支持大模型构建、数十种数据采集方式、自动发现资产、可视化的拓扑图、集成可视化大屏、兼容国产系统等。另外还有丰富的社区内容、在各大城市都有线上线下活动(可以在微信公众号关注“乐维社区”)。
Lerwee安装和部署
Lerwee的安装和部署,简单明了,傻瓜式部署和安装。
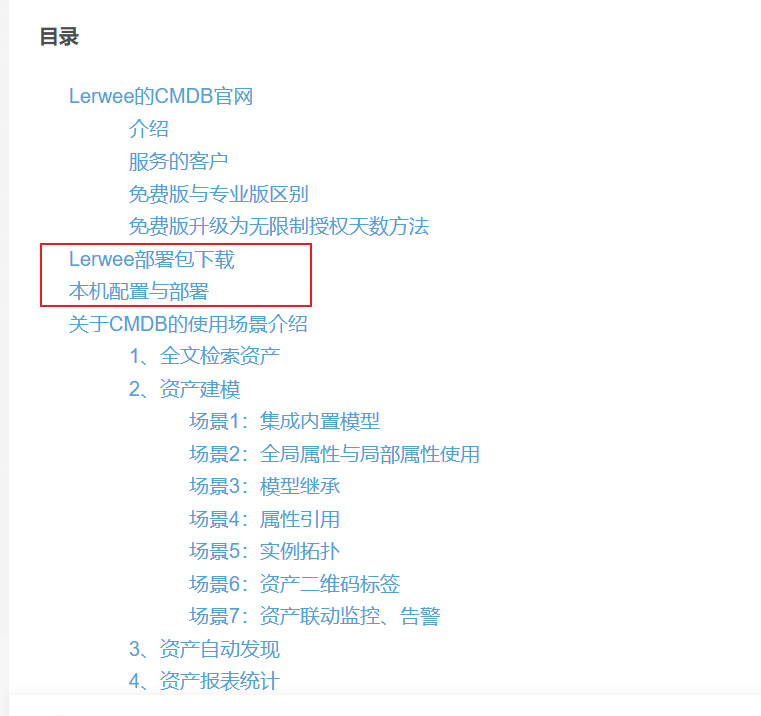
安装部署这里就不多说了,可以参考我上一篇的博客《【深度实测】Lerwee的CMDB真的好用吗?-从部署到使用实战验证(免费版)》这两个章节来部署:
Anolisos7.9系统下载:Anolisos7.9系统下载渠道
部署包下载:快速访问下载渠道
社区申请免费版永久授权:申请指引
Lerwee免费版与商业版区别
我们对比下免费版和商业版有什么区别:
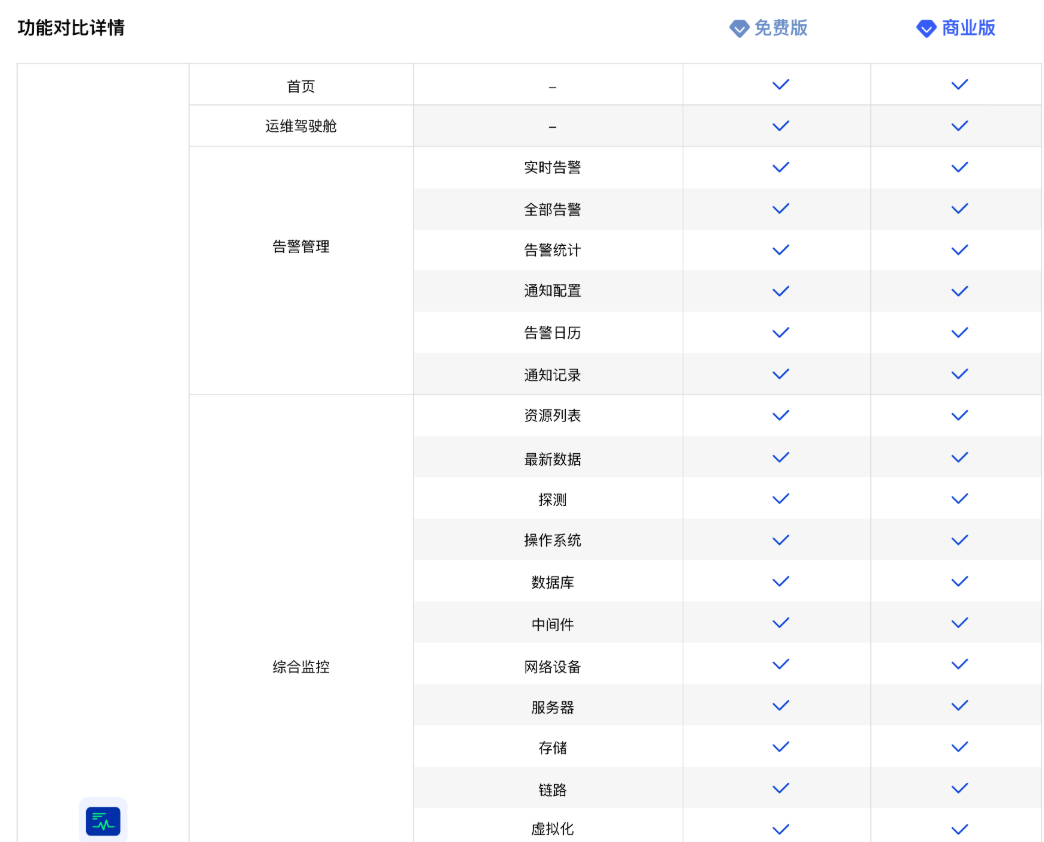
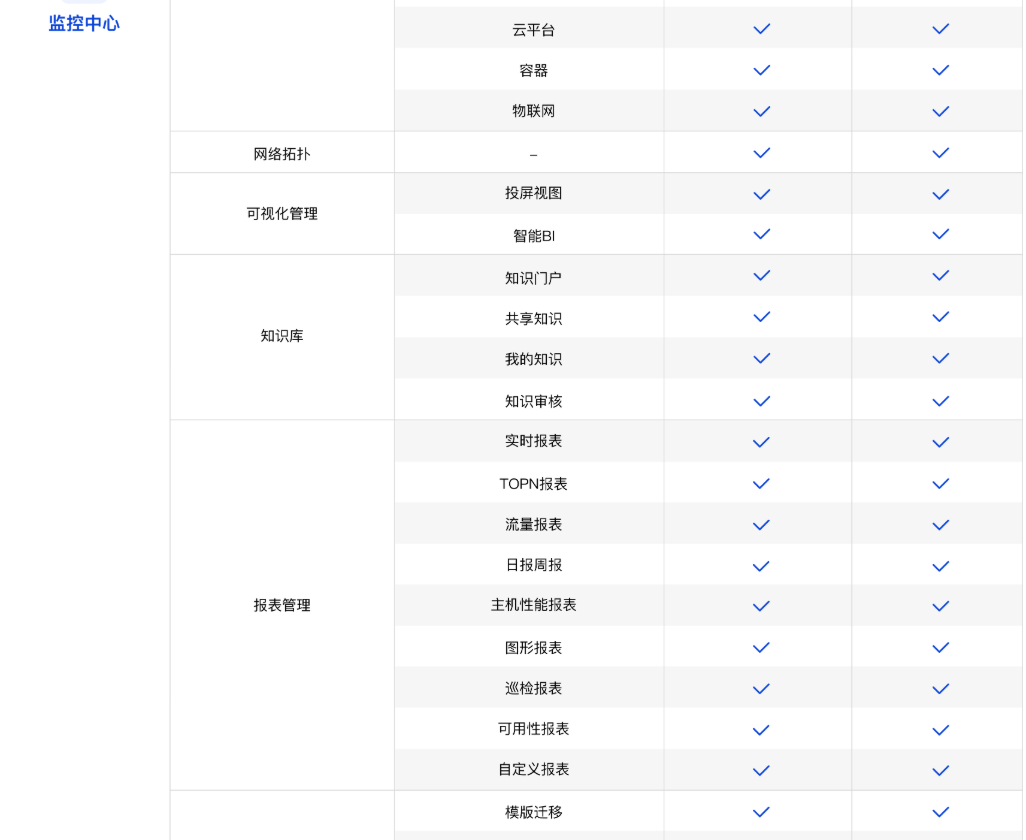
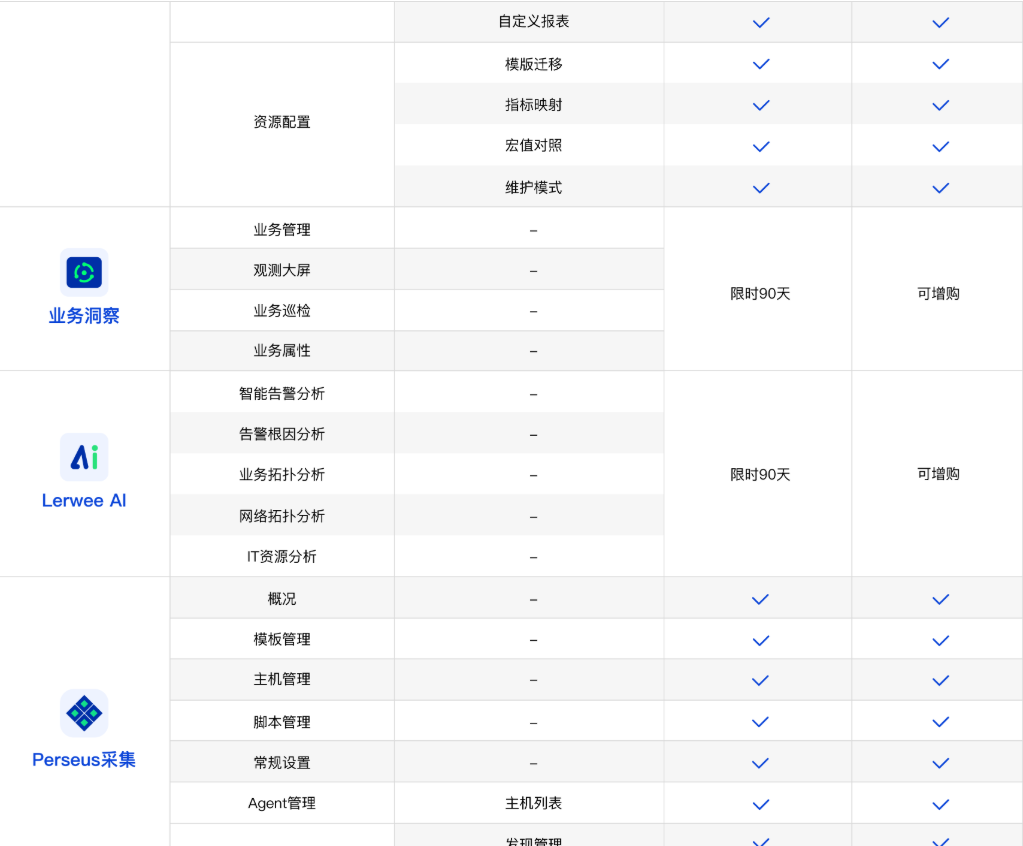
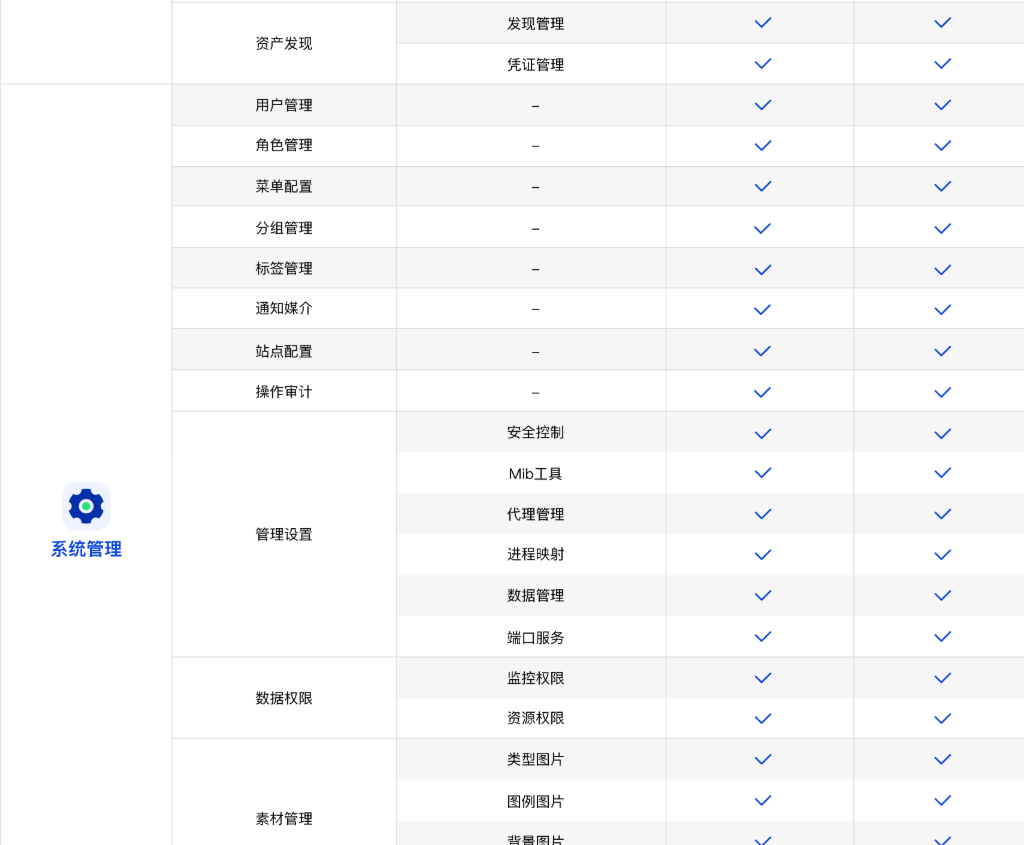
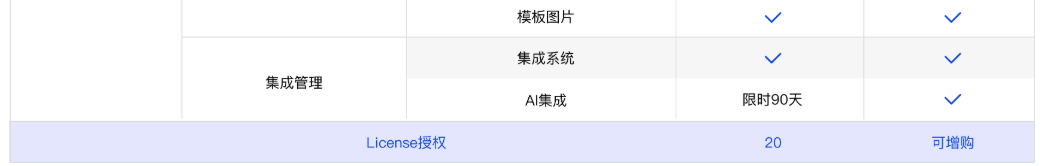
足足截了几大图片,看到这里,Lerwee监控的功能足够多,已经够一个小型企业使用,而且社区还定期提供补丁升级,解决社区中遇到的各种各样的问题。
废话就不多说,上各个模块的场景!
Lerwee运维智能体场景
首页
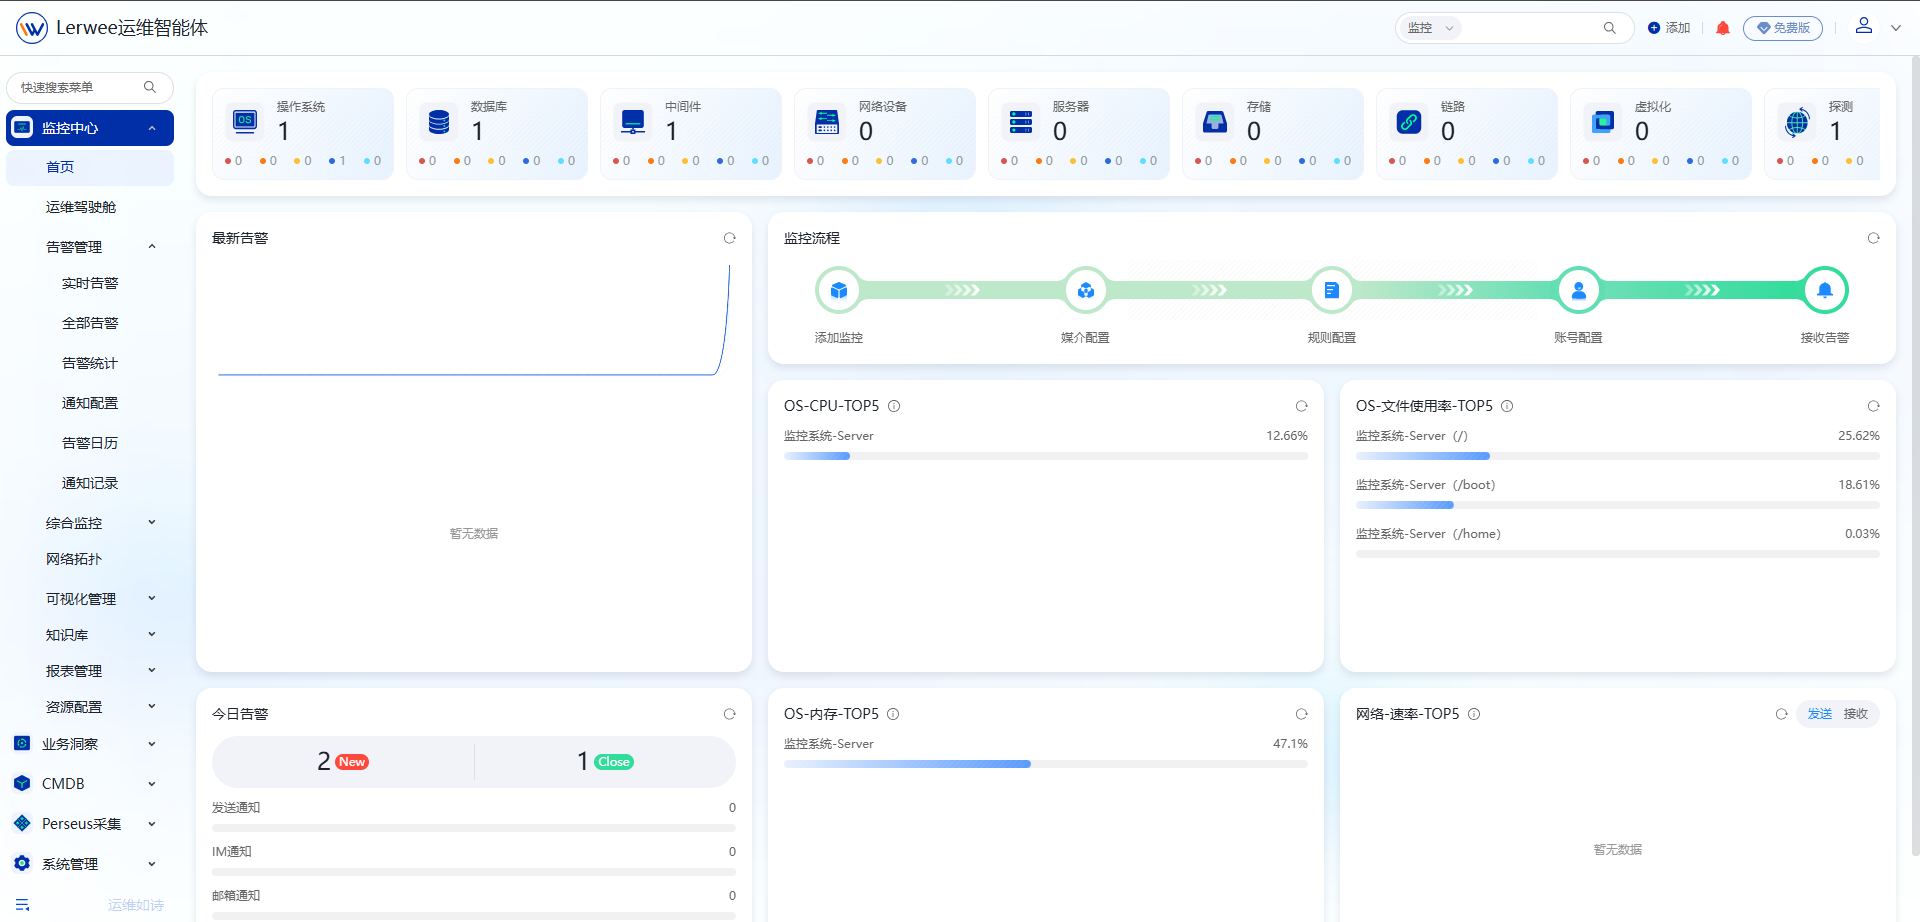
首页是每个网站的敲门石(好看而又实用),可以看到:
顶部是每个监控类型的资产统计、告警级别数量统计。
最新告警:趋势图表数据统计近30天严重以上告警变化趋势。
监控流程:从监控到接收告警的配置。
TOP5排行:纳管操作系统、网络设备常用指标的TOP5排行。
今日告警:统计今日告警数、通知数。
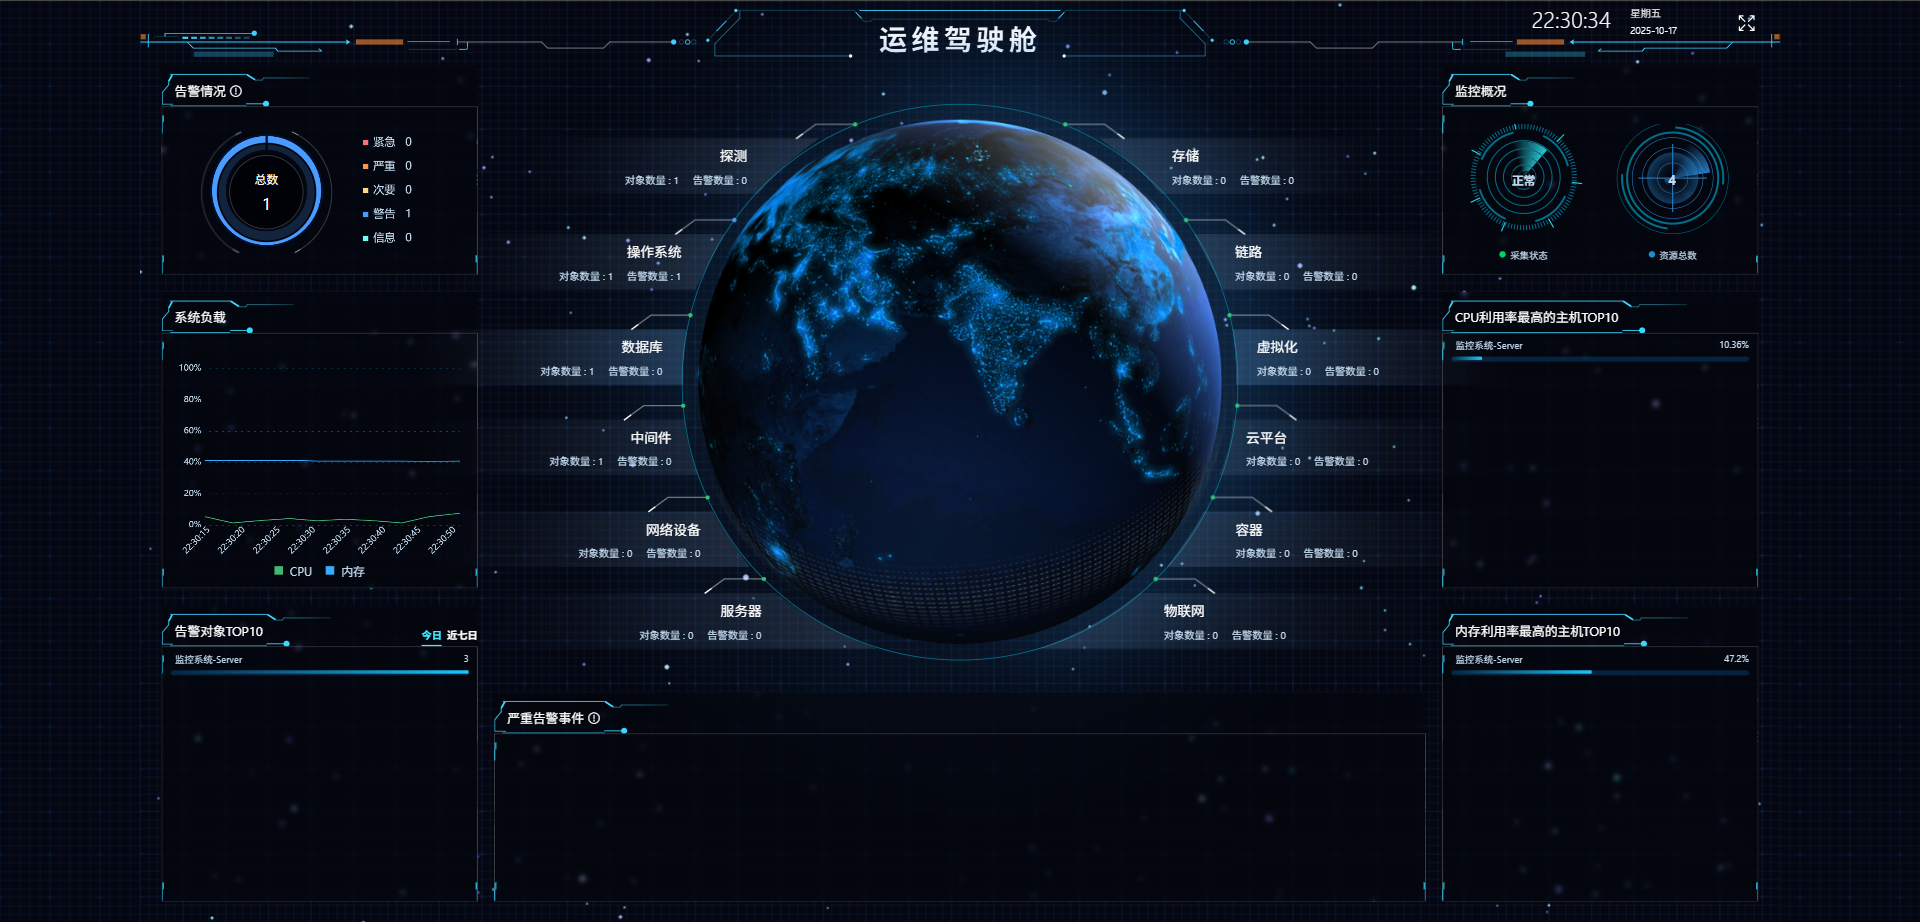
运维驾驶舱
Lerwee运维智能体是一名剑客,那么运维驾驶舱就是一把剑,直指资产核心,快速的了解了整个系统的运行情况。
告警管理
告警管理,是Lerwee运维智能体的第一个核心(决策层,识别与通知)
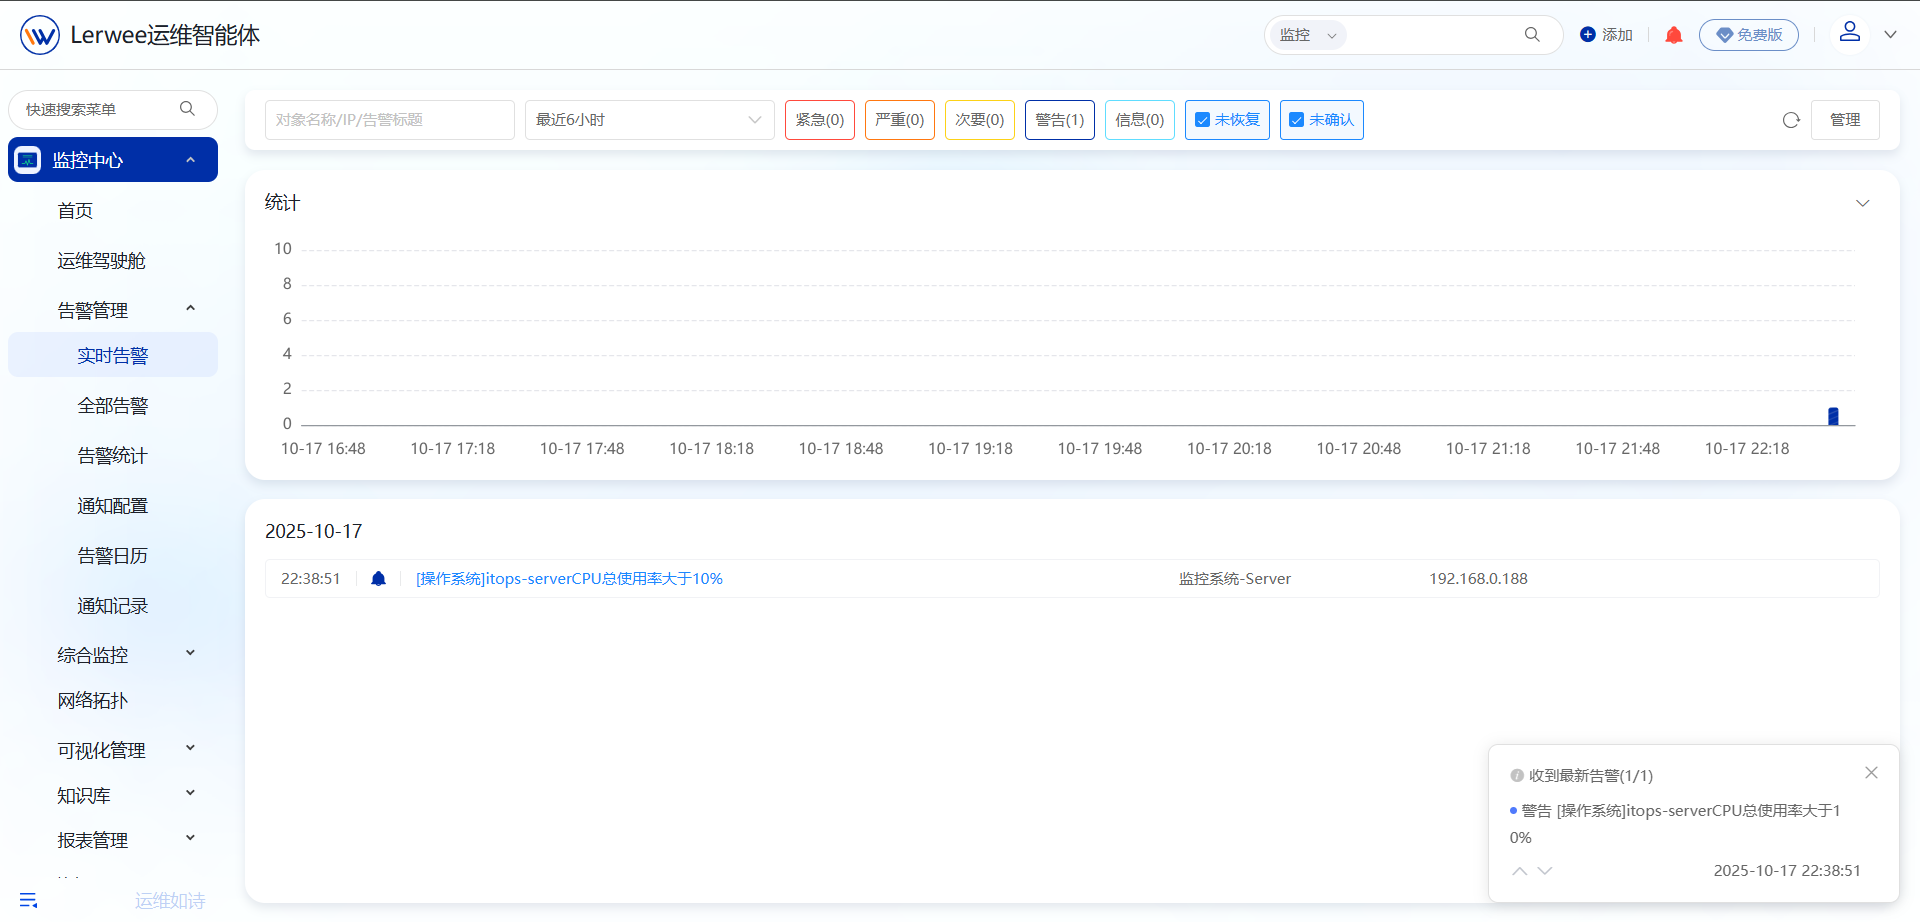
一个既能看又能听的实时告警
我们大部分企业,都会有一群运维人员加班加点去关注每个系统产生的告警,浪费了大部分人力、时间和金钱。我常想,有没有一个可看可听的实时告警呢,这里确实又一个:
1、系统弹窗提醒(催命牛马)
2、声音提醒(醒脑神器)
3、实时刷新(解放双手)
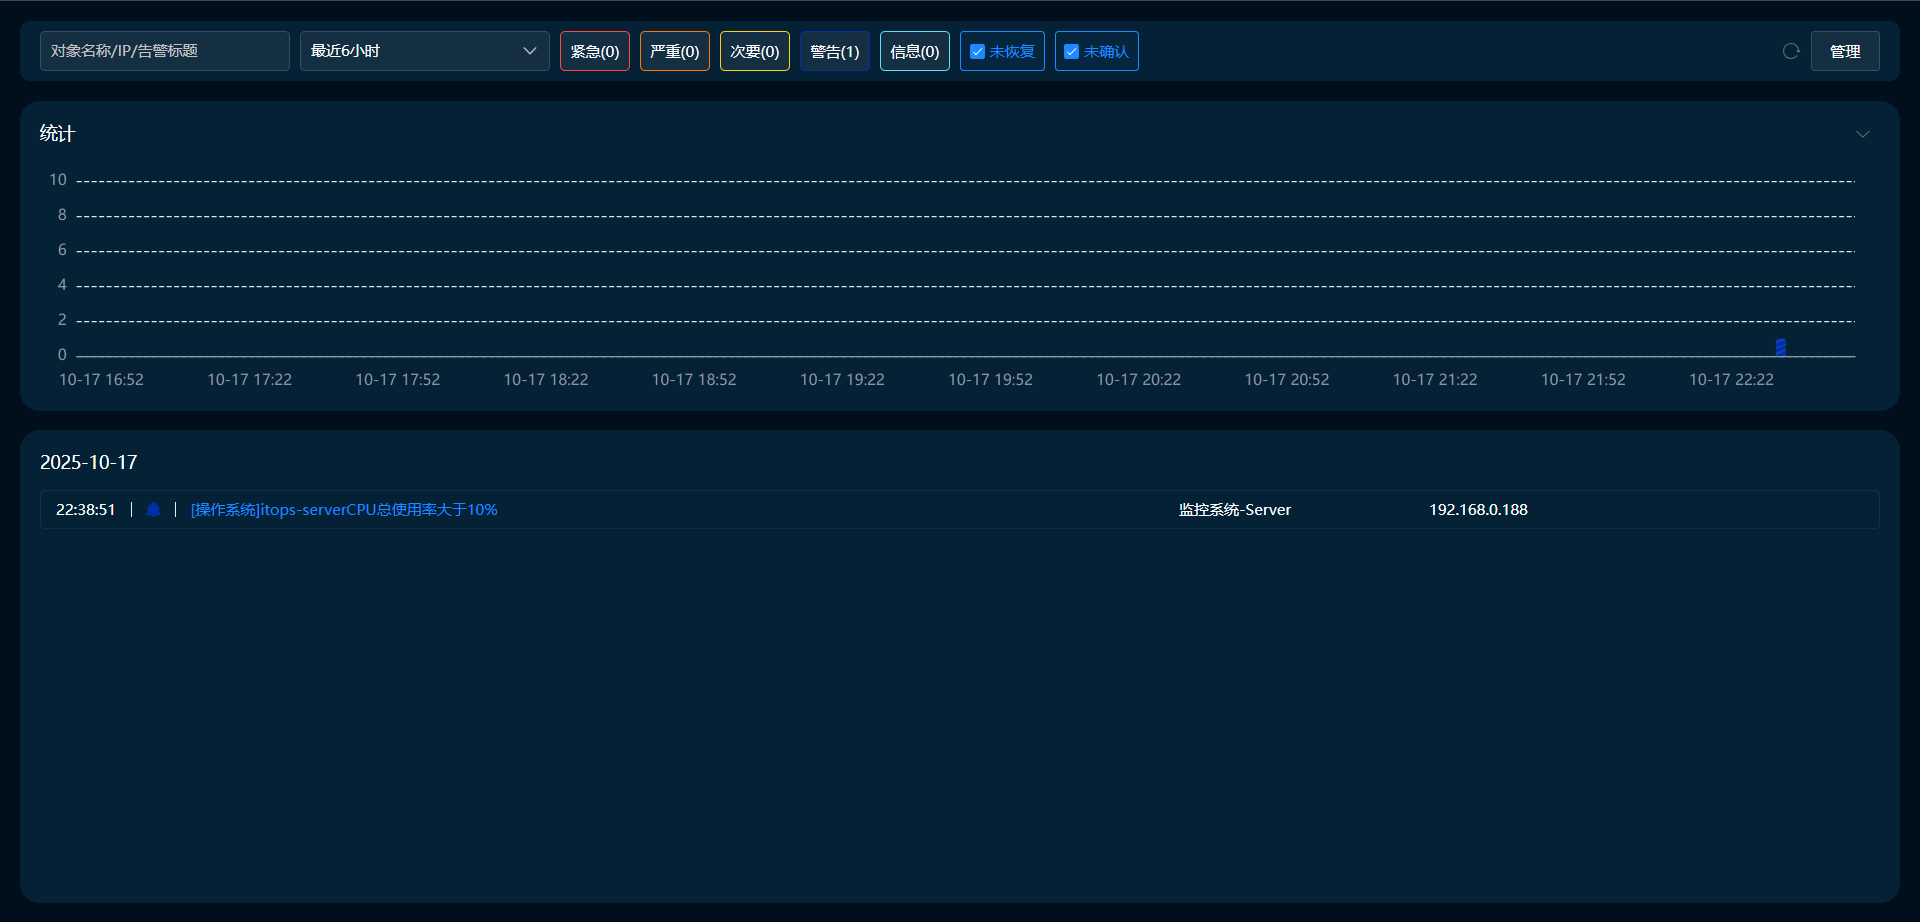
4、夜览投屏(通宵利器)
一个可以提供解决方案的全部告警
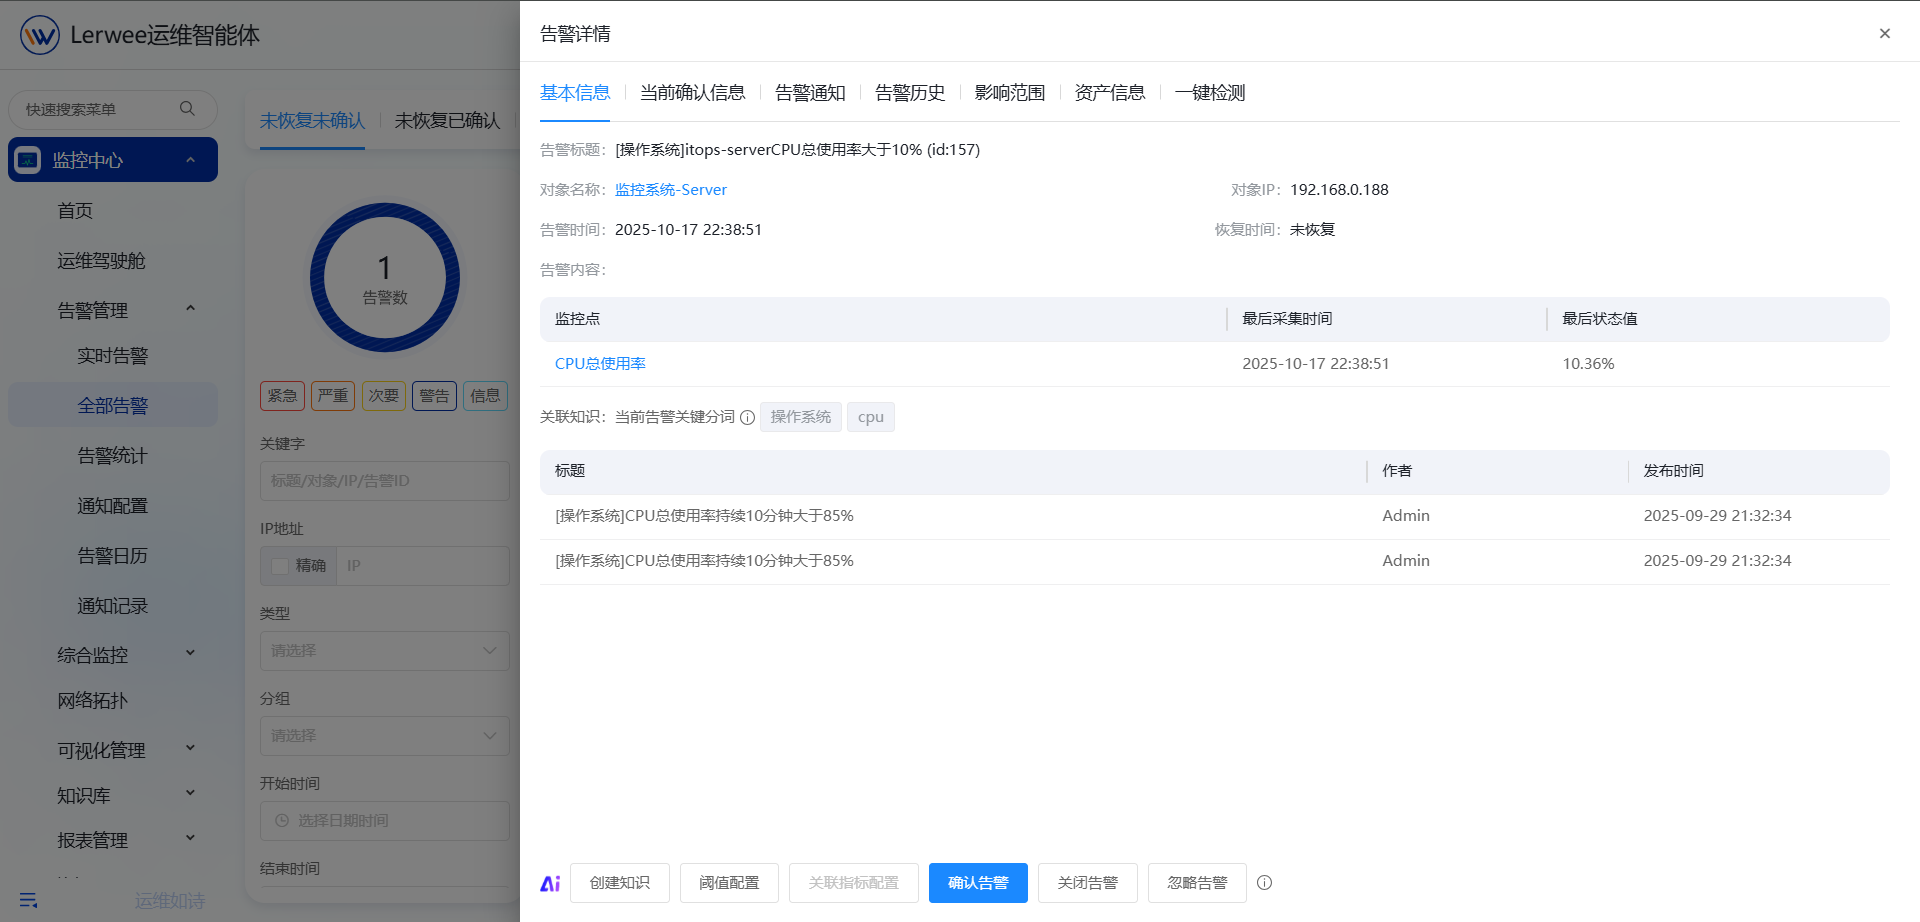
从这个告警可以看到,这个告警的基本信息、产生告警的故障点以及解决方案的知识。
再看看底部各个操作:AI、创建知识、阈值配置、关联指标配置、确认关闭告警、忽略告警。那我就一一解析下:
AI--创建知识--阈值配置--确认关闭告警--忽略告警(可能场景多样化):
1、系统突然产生一个告警
2、小明看了这个告警,查看了这个告警的所有解决方案,目前还没找到一个有用的知识,这时,突然想起一个用AI试下,一问AI,果然提供的比较全,原来是其他原因导致。
3、这时,小明就先确定告警,然后在这个告警里面创建一个从AI获取的解决方案的知识,
4、根据解决方案的知识,在阈值配置创建一个更低的触发阈值,提前预警。
5、完事后,小明根据解决方案解决这个告警,最后松了口气,然后信心满满的关闭告警。
6、但是,还没等小明再次松口气,这个告警需要一定的时间将故障自动恢复,后面又会持续不断发这个重复告警,那咋办呢,只能在一定时间内“忽略告警”了。
关联指标配置:一个CPU使用率突然狂飙,往往伴随的响应延迟或负载升高,这就需要使用到关联指标配置,在原来CPU使用率的指标上,增加一个系统负载或响应延迟指标,以便后面再次产生告警时,会自动带上系统负载或响应延迟指标的最后采集状态值。
当前确认信息:确认告警和关闭告警操作记录
告警通知:这条告警发送给哪些人了
告警历史:可以查看以前发送了有多少条类似的告警
影响范围:与网络拓扑、业务拓扑关联,可以清楚知道这条告警的影响范围
资产信息:这台设备详细资产信息,与CMDB关联。
一键检测:需要商业版购买增值。
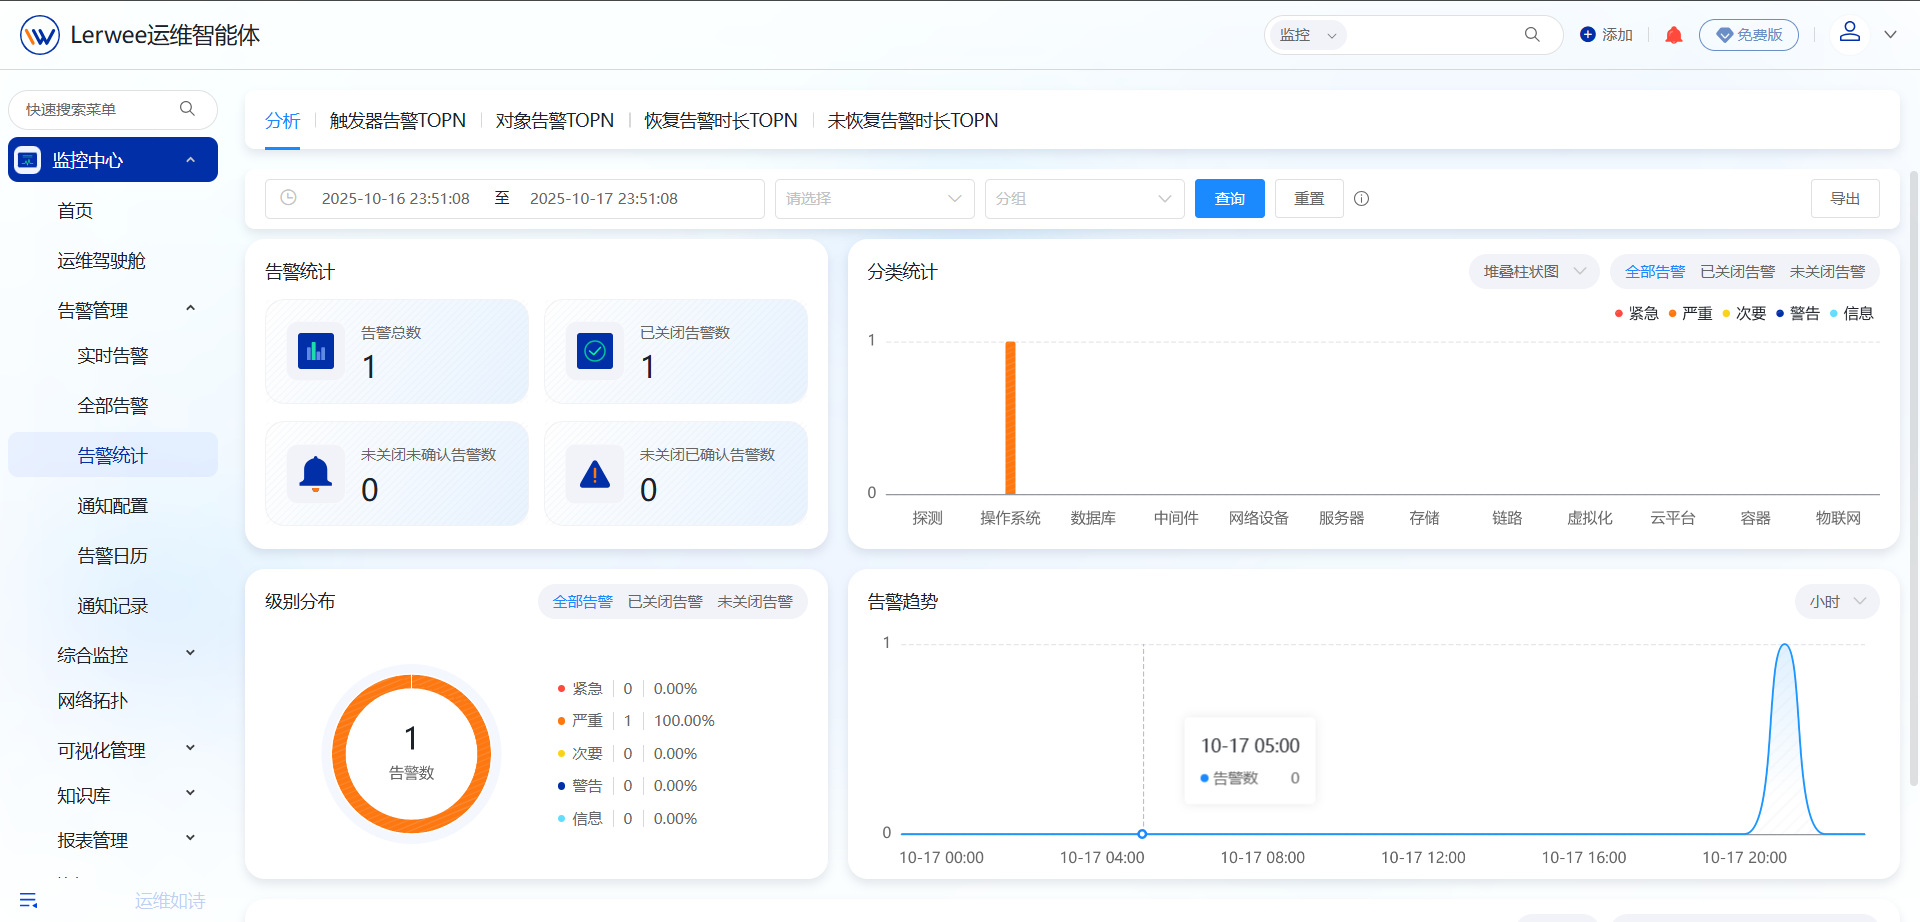
从不同维度统计告警
这里就不多说了,这里的告警统计可以从各种维度去统计。
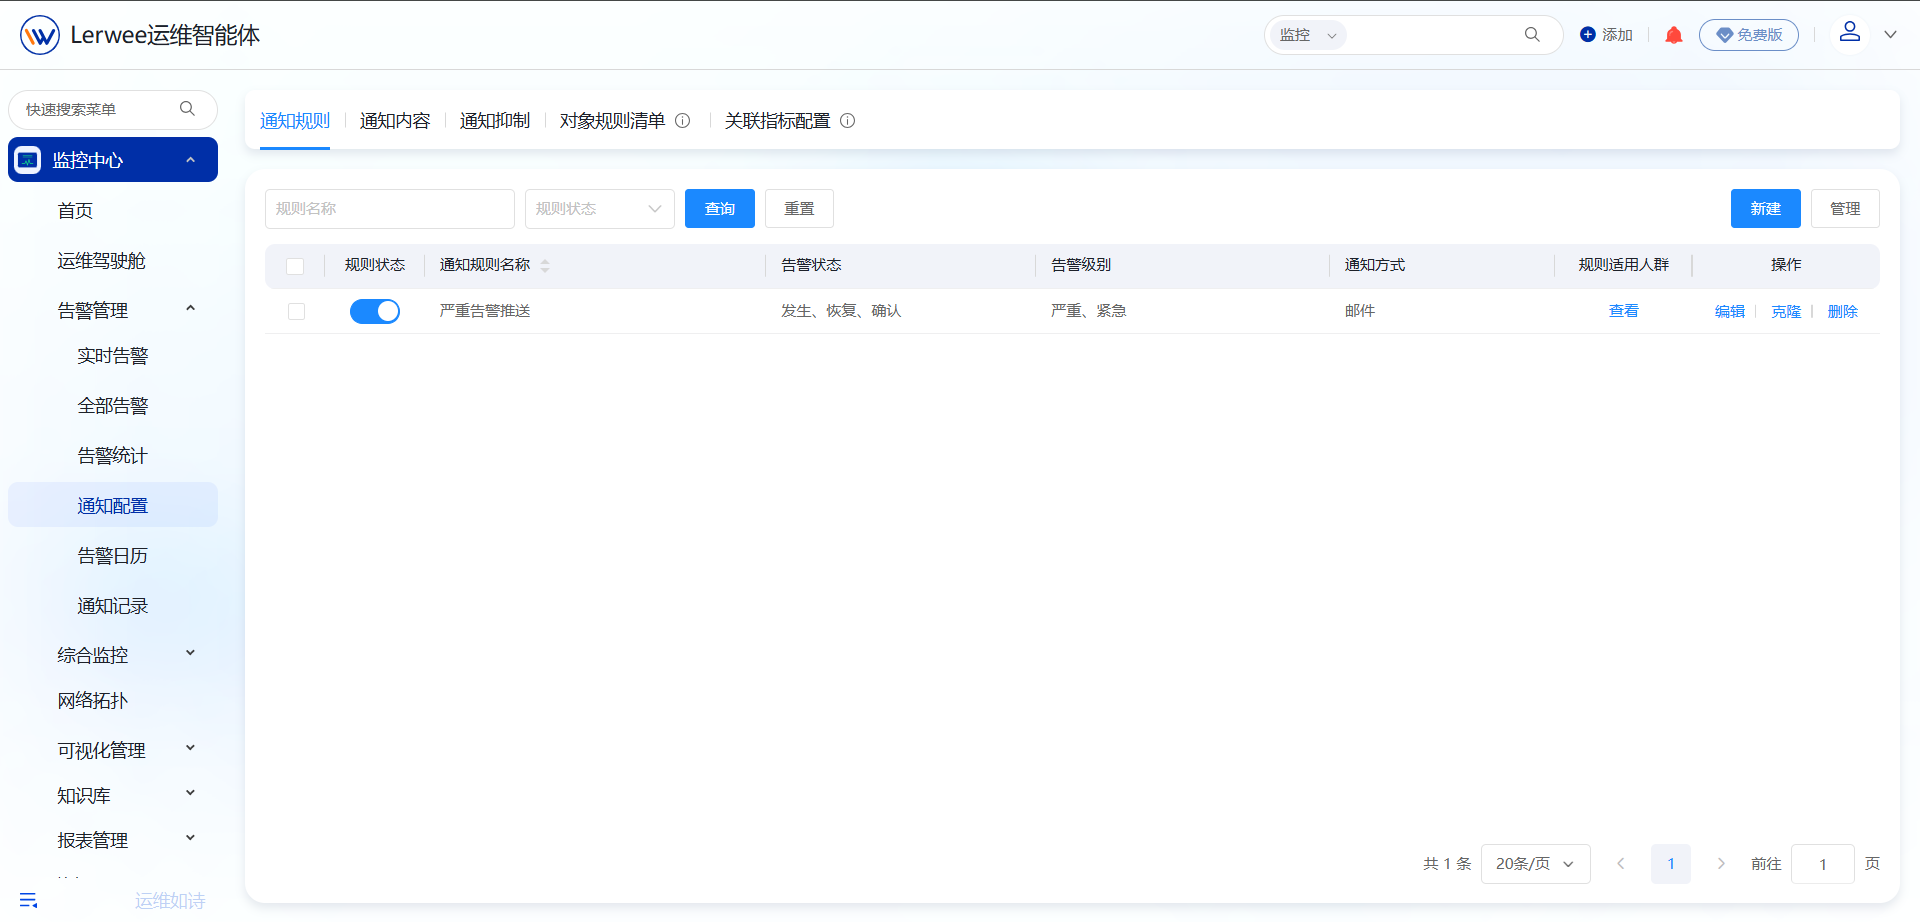
集通知模板、规则、抑制的通知配置
通知规则:就是将什么样的告警发送通知给谁的一个配置。
通知内容:配置通知内容模板。
通知抑制:产生通知风暴(一瞬间突然发送几十条告警),需要用到通知抑制功能,来抑制通知风暴产生。(因为这往往都是一个业务故障引起了这个业务下所有子业务都发送故障)
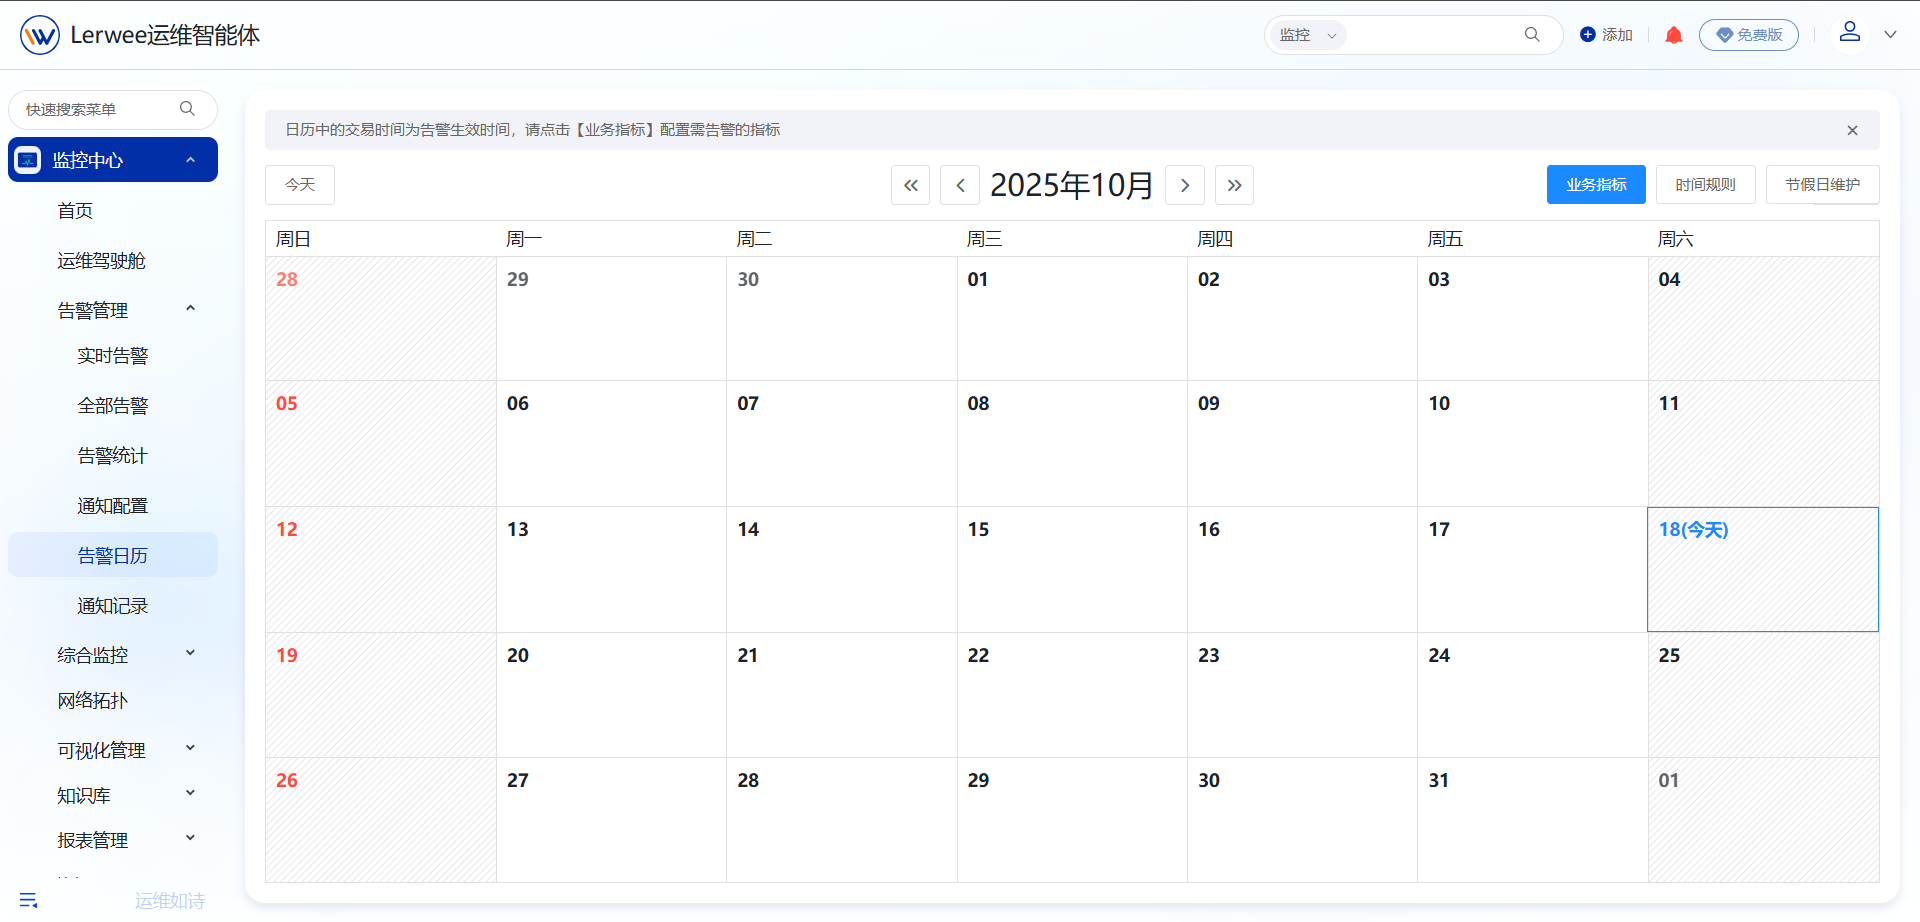
打造金融圈使用的告警日历
我们都知道金融圈包括银行、保险、基金等这些金融机构,这些都是有交易期和非交易期的概念,这就需要使用告警日历,在交易期间产生告警,非交易期间不产生告警,因为非交易期间都没有多少人使用。(6,黄金大涨了)
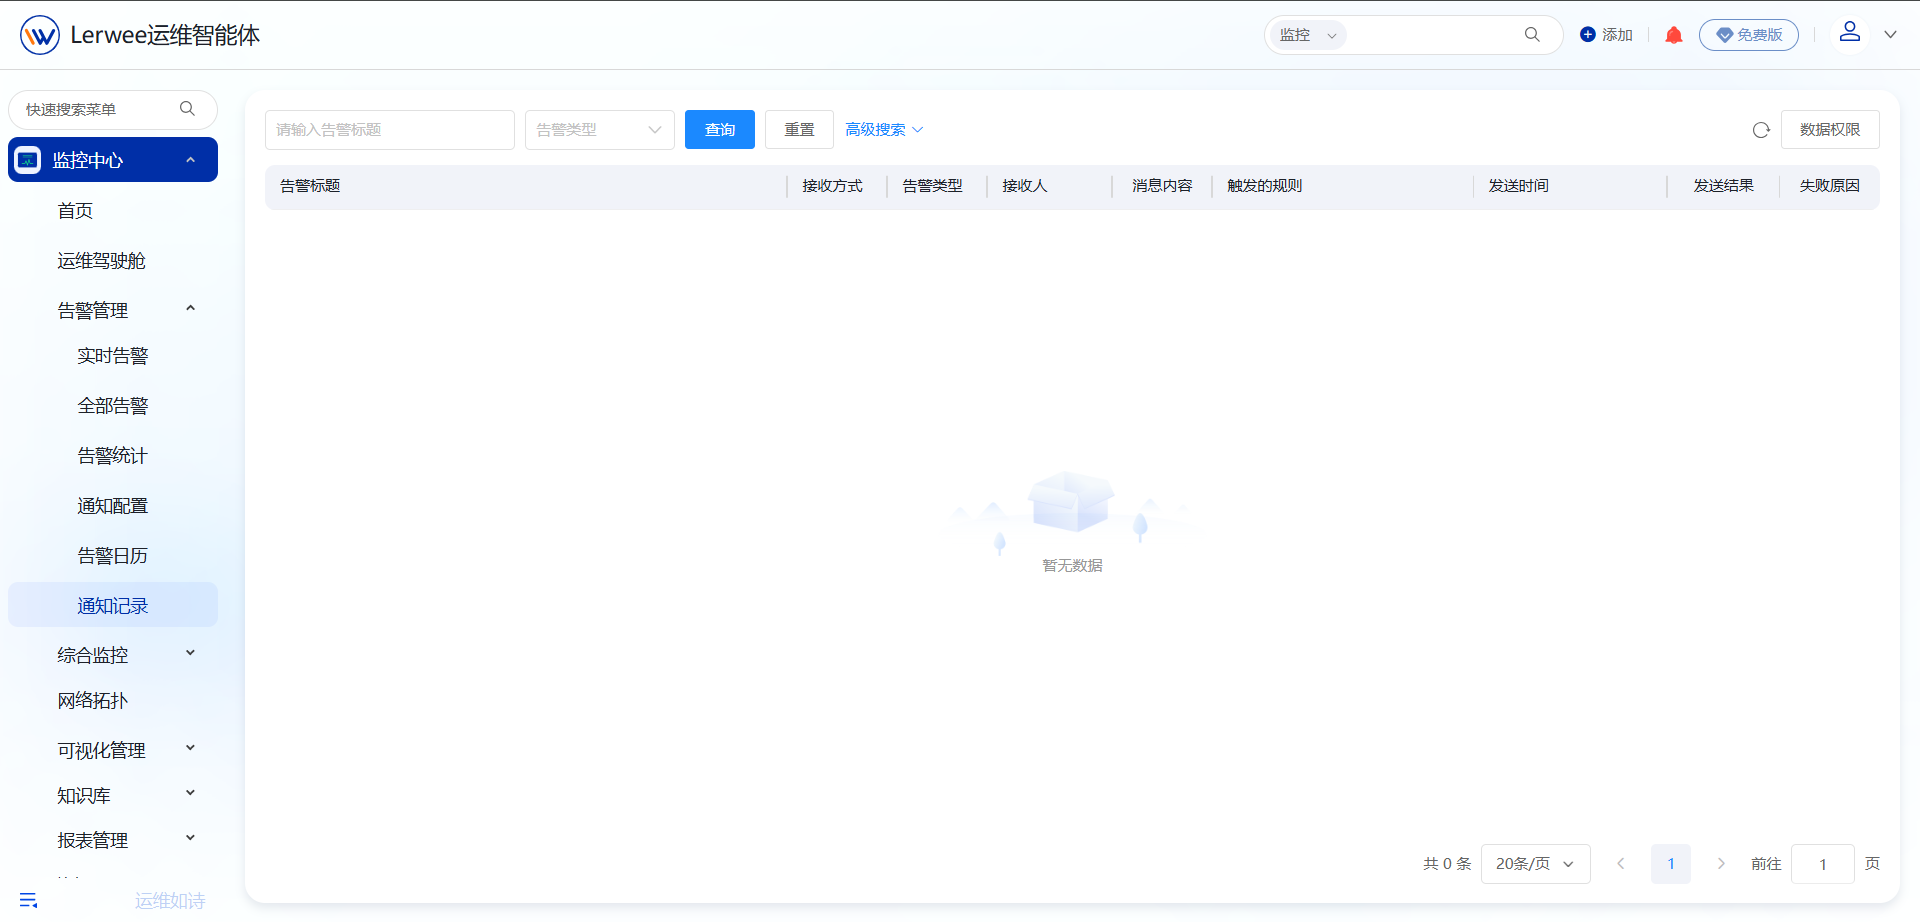
通知记录审计
这里没什么好说,都是一些告警产生的通知记录。(最初是确定有没有发送成功,直到最后才发现,这个是确定邮件服务器有没有出现故障)
综合监控
综合监控是Lerwee运维智能体的第二个核心(感知层,数据采集与感知)
一款纳管所有监控设备的资源列表
所有所需要感知的数据集合入口,这里可以对需要监控的设备进行纳管和采集。当然这里功能还不只你眼前看到的这些,还有其他常用的功能,例如: 快捷维护、自定义属性、视图等。
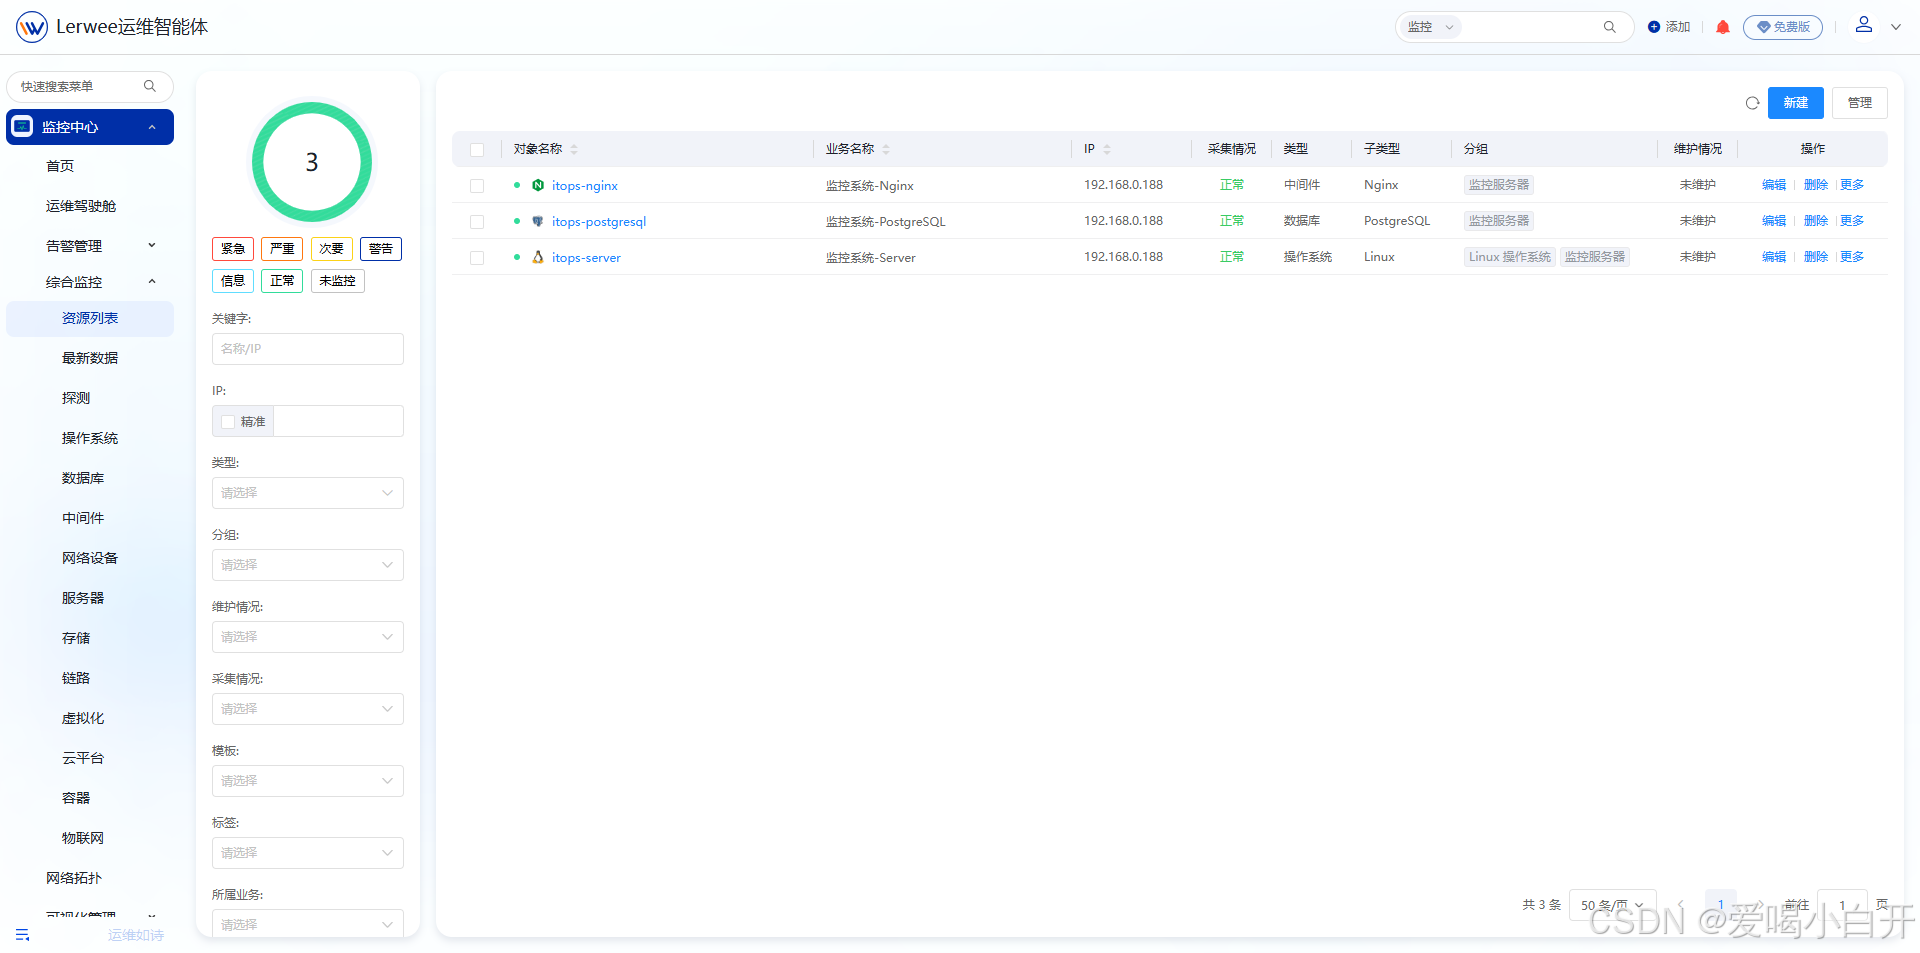
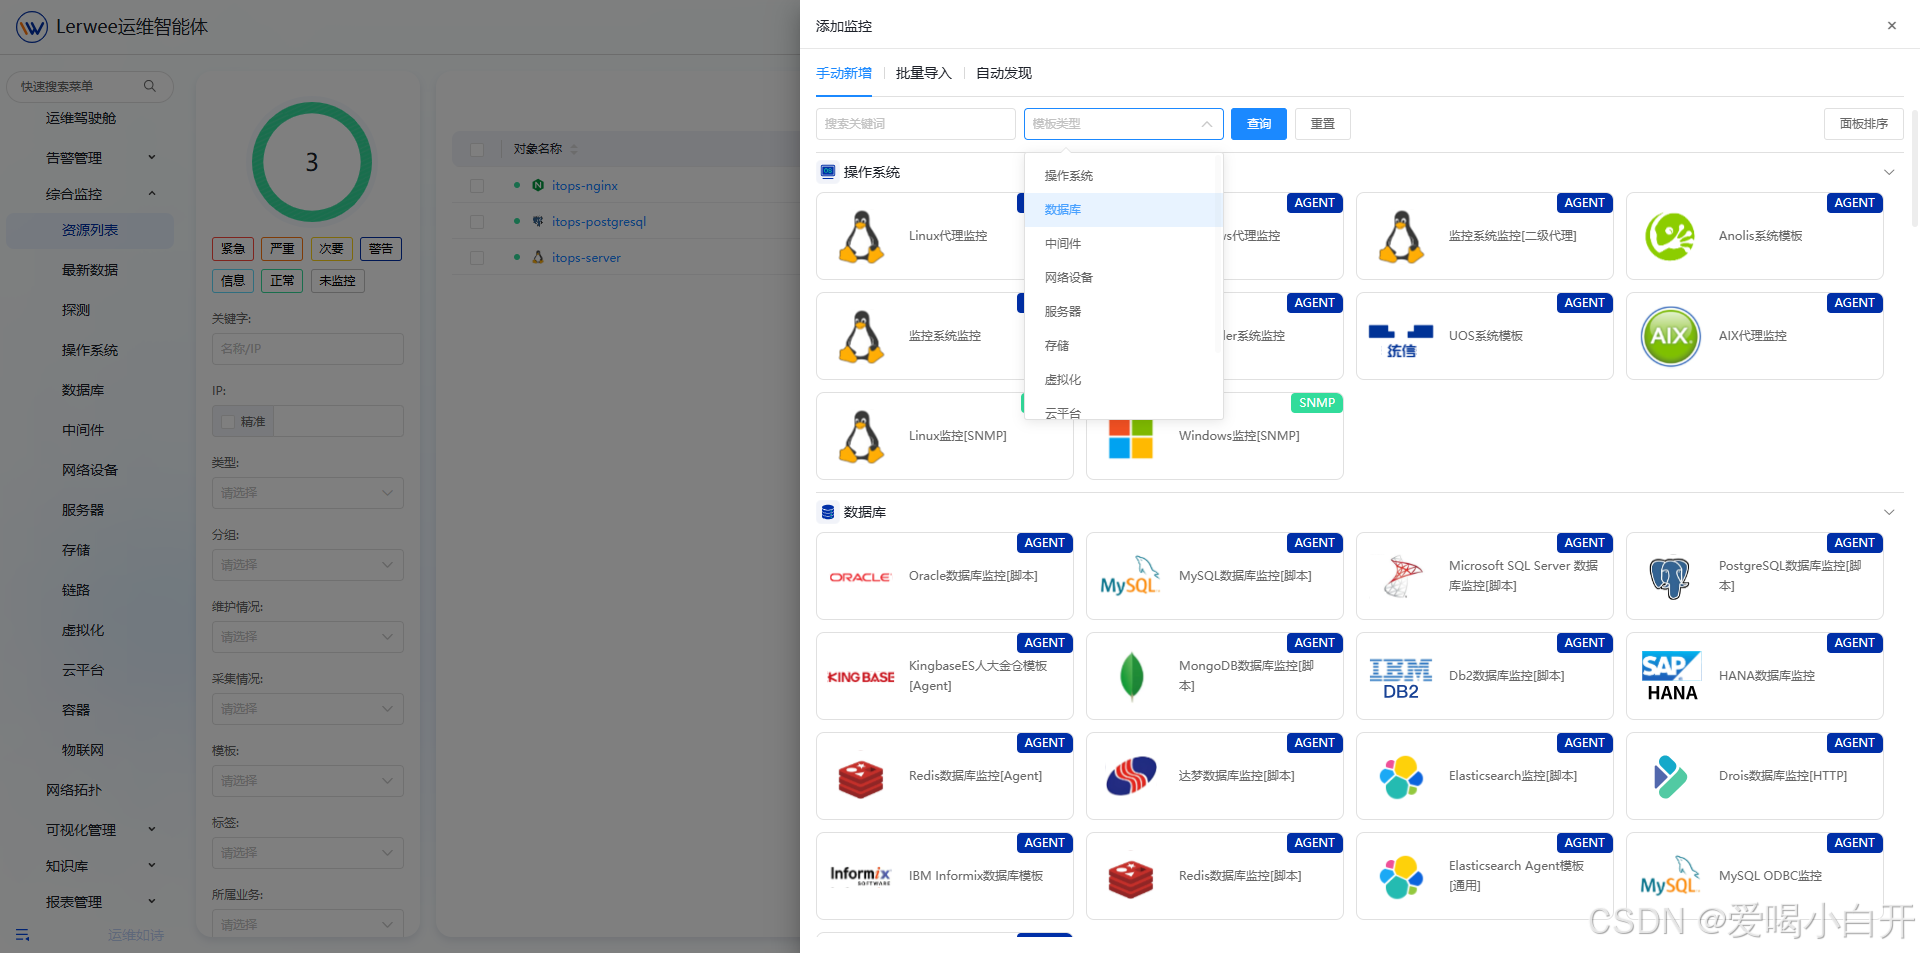
这里支持操作系统、数据库、服务器、中间件、存储、链路、虚拟化、云平台、容器、物联网等类型的设备,当然这些设备的纳管不需要你去关心采集什么指标、触发告警阈值等配置,因为这里已经帮你内置好所有常用的厂商。
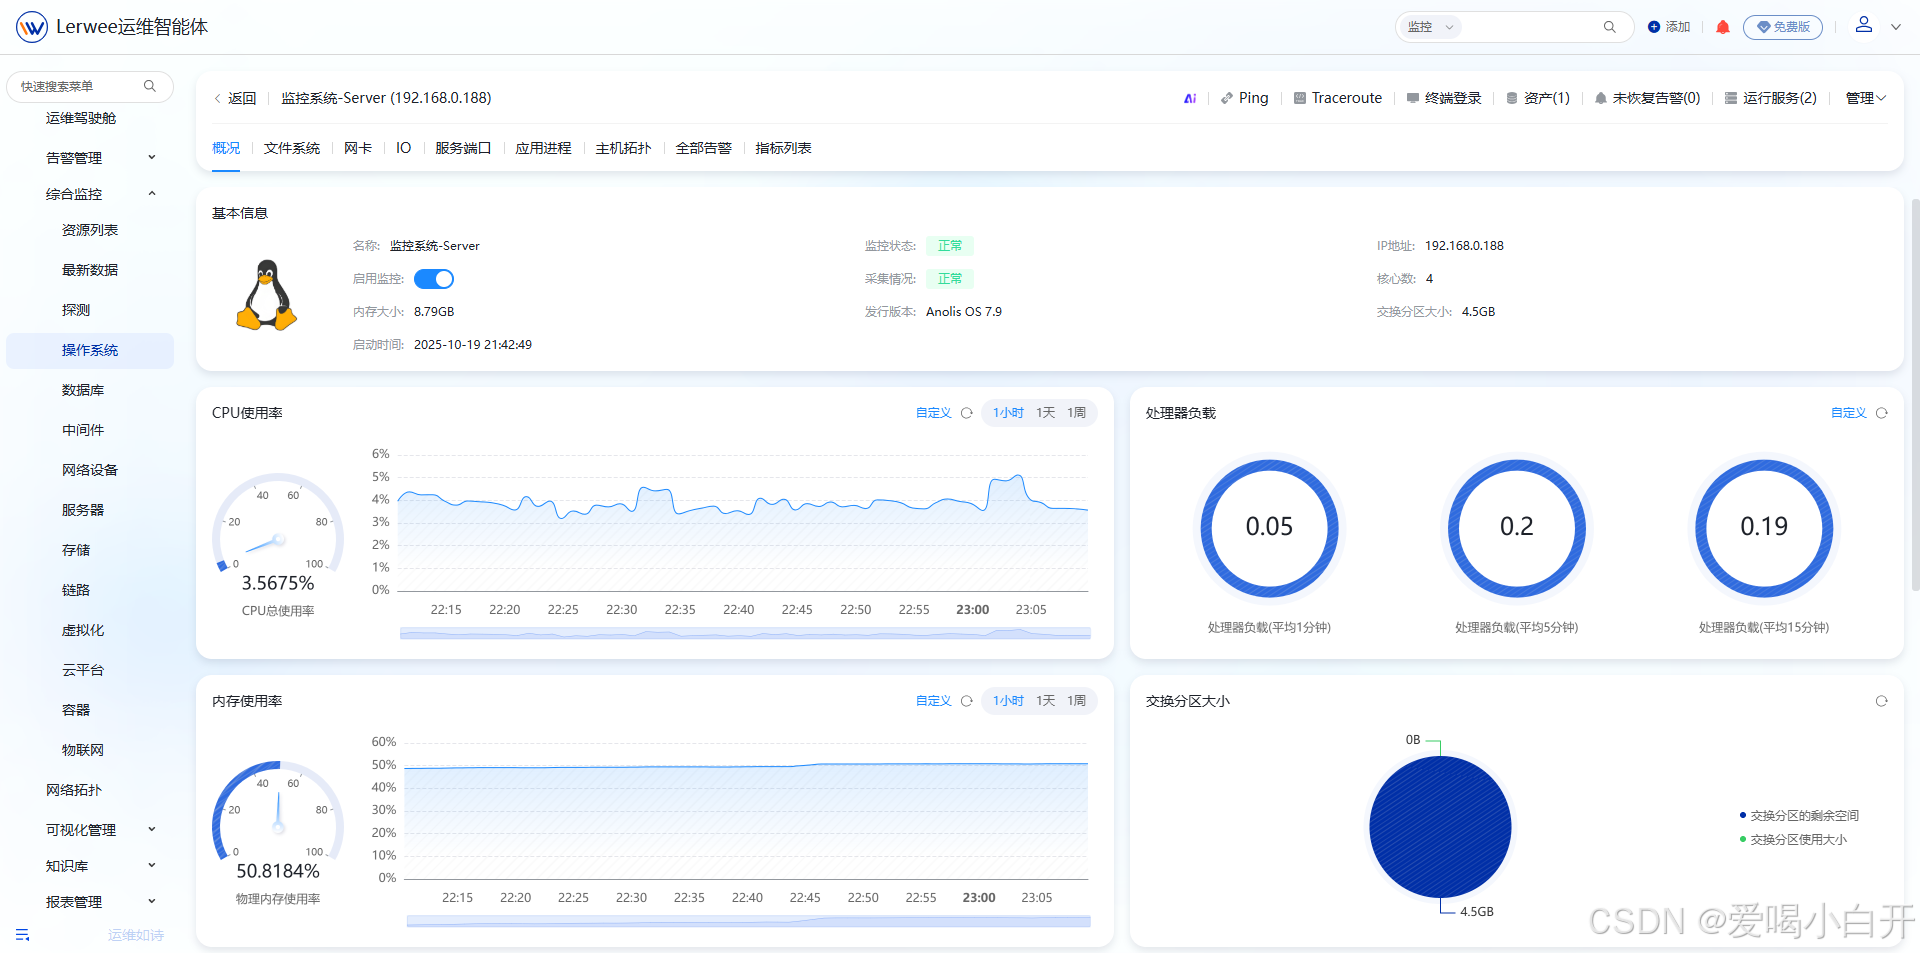
监控设备详情里面,也内置了常用的指标。像操作系统,我们都会关系文件系统、网卡、IO、服务端口、应用进程 、主机拓扑、全部高级、指标列表等各种各样的功能。
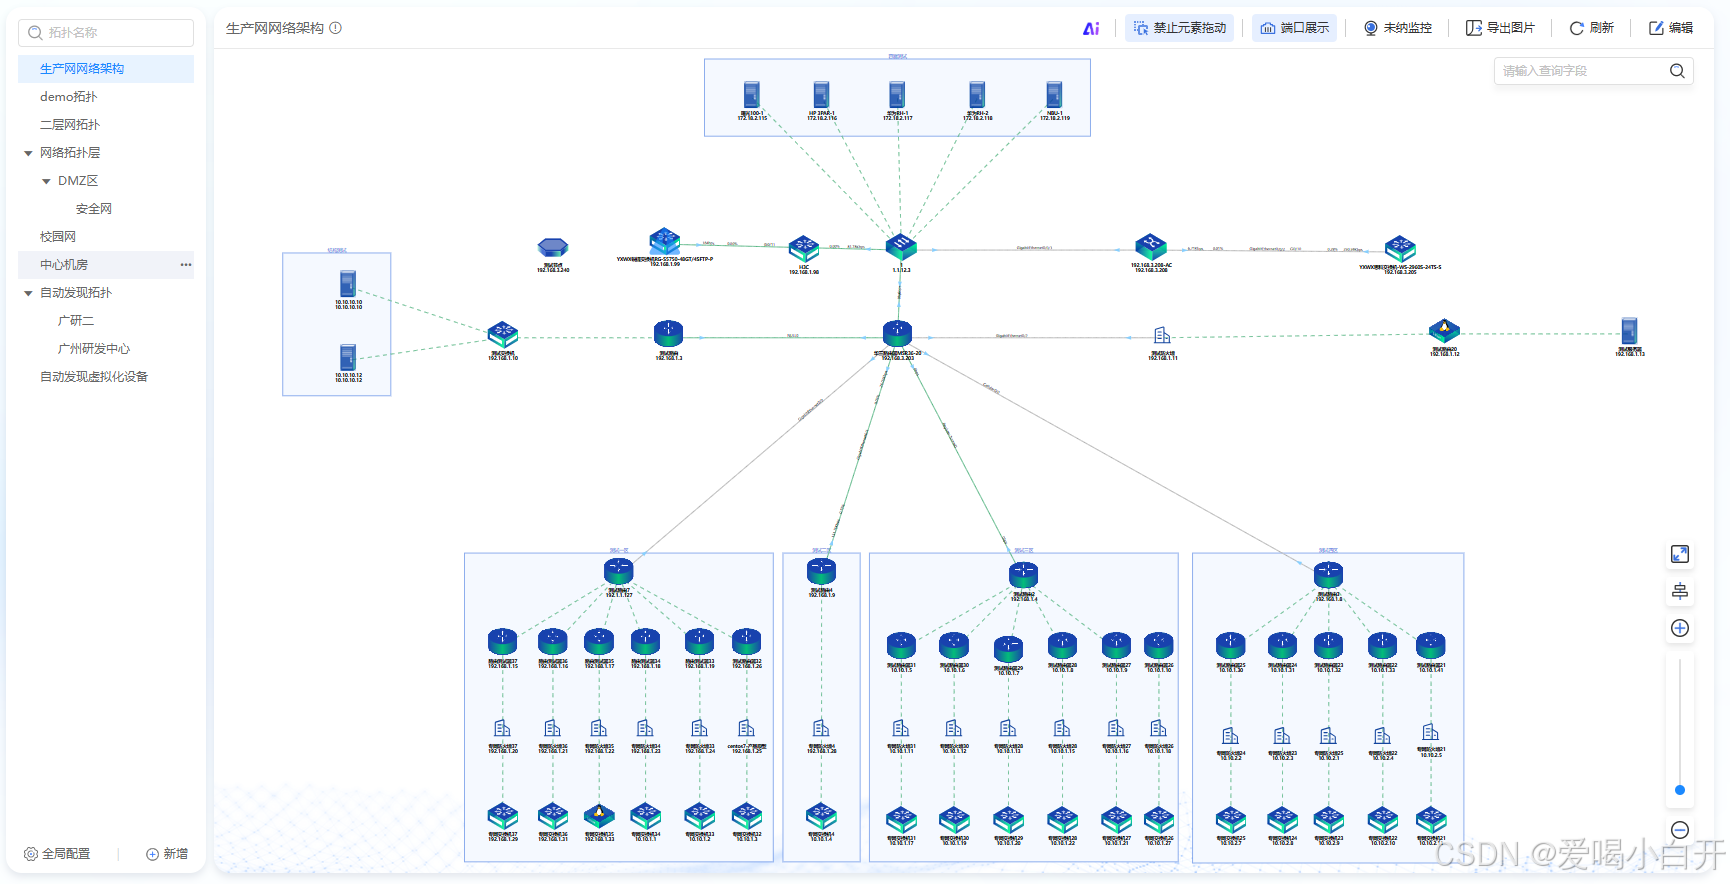
强大的网络拓扑发现能力
这里网络拓扑支持自动发现、手动添加网络设备。从拓扑的情况来看,拓扑的功能支持度都比较高,像我们在其他监控厂商的拓扑中该有的功能都会有,另外支持的发现协议也会渐渐随着后续的升级越来越多,越来越准确。
可视化管理
可视化的视图,可以从直观上了解设备监控情况。
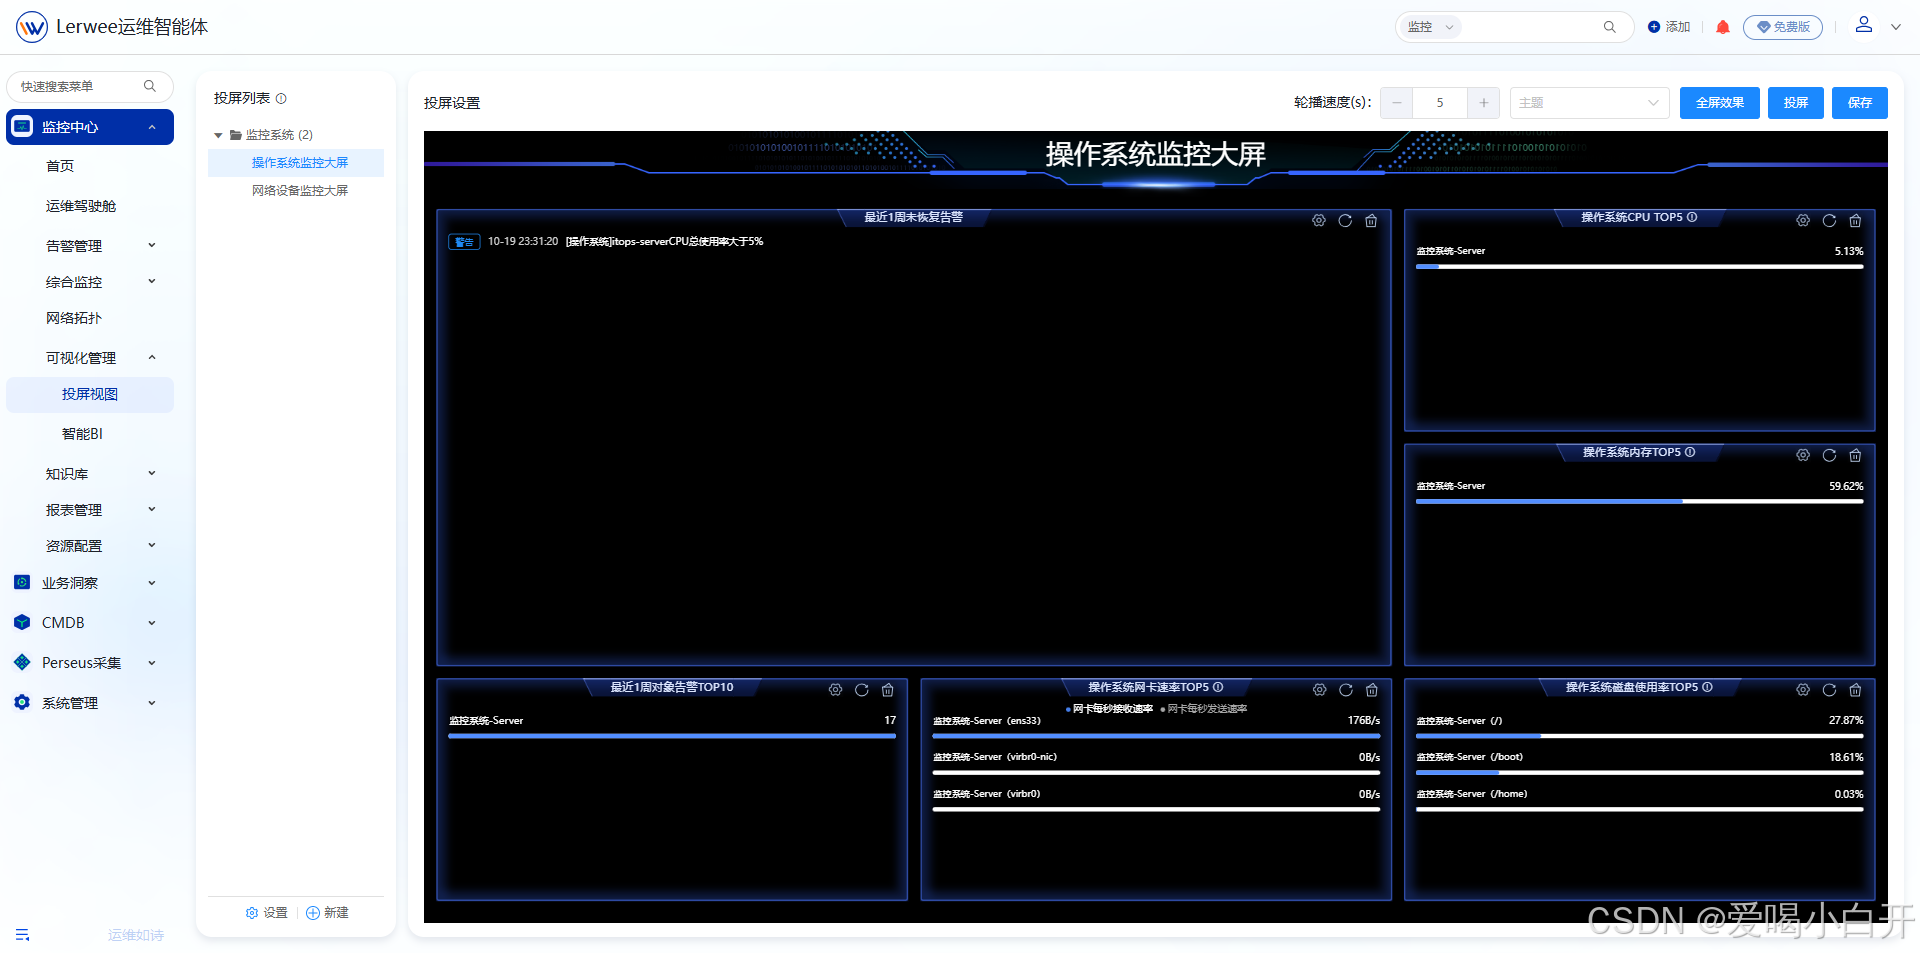
业务场景化的投屏视图
这里的投屏视图可以根据每个业务单独 配置一个投屏,这样更加方便知道哪些业务出现故障、产生了什么告警等。
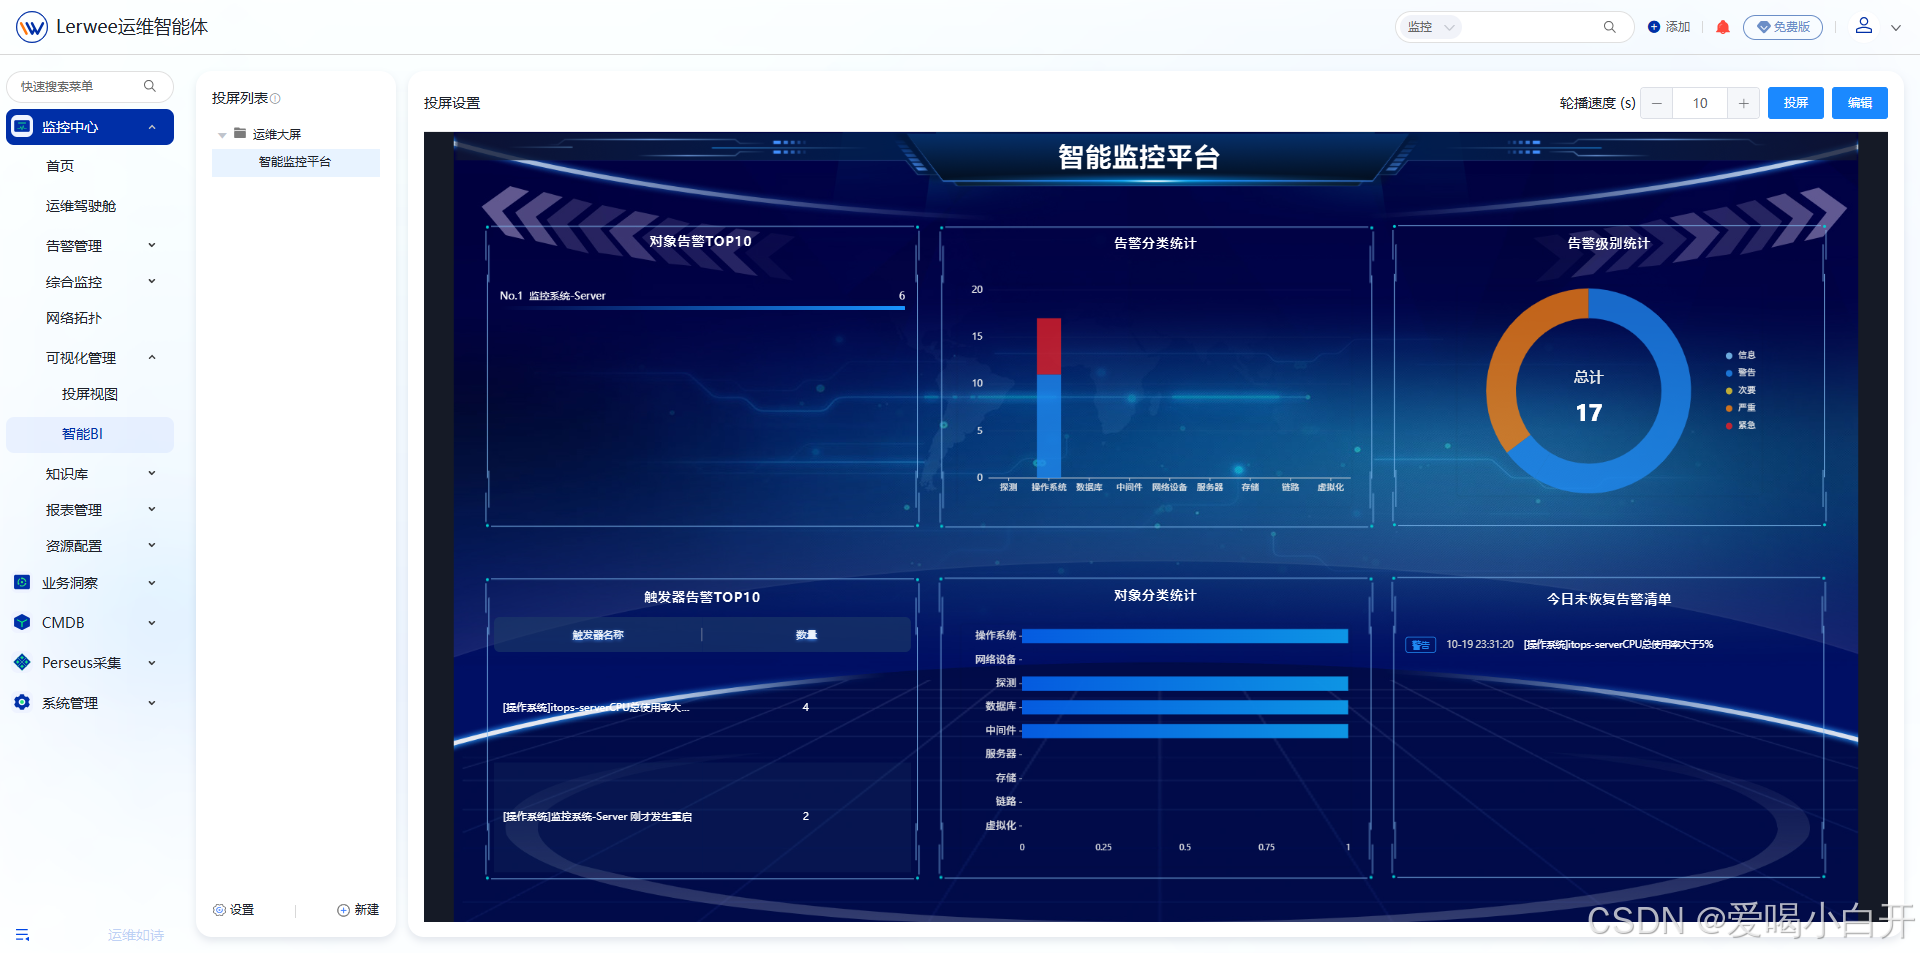
可DIV大屏的智能BI
如果感觉上面投屏视图的业务已经不能满足现状,这里的DIV大屏,对不同业务的支持度也比较高, 控件、背景、图表等都比较多,但是维独对样式设计能力要困难了点,不过还好,这里把样式调整已经界面化了。
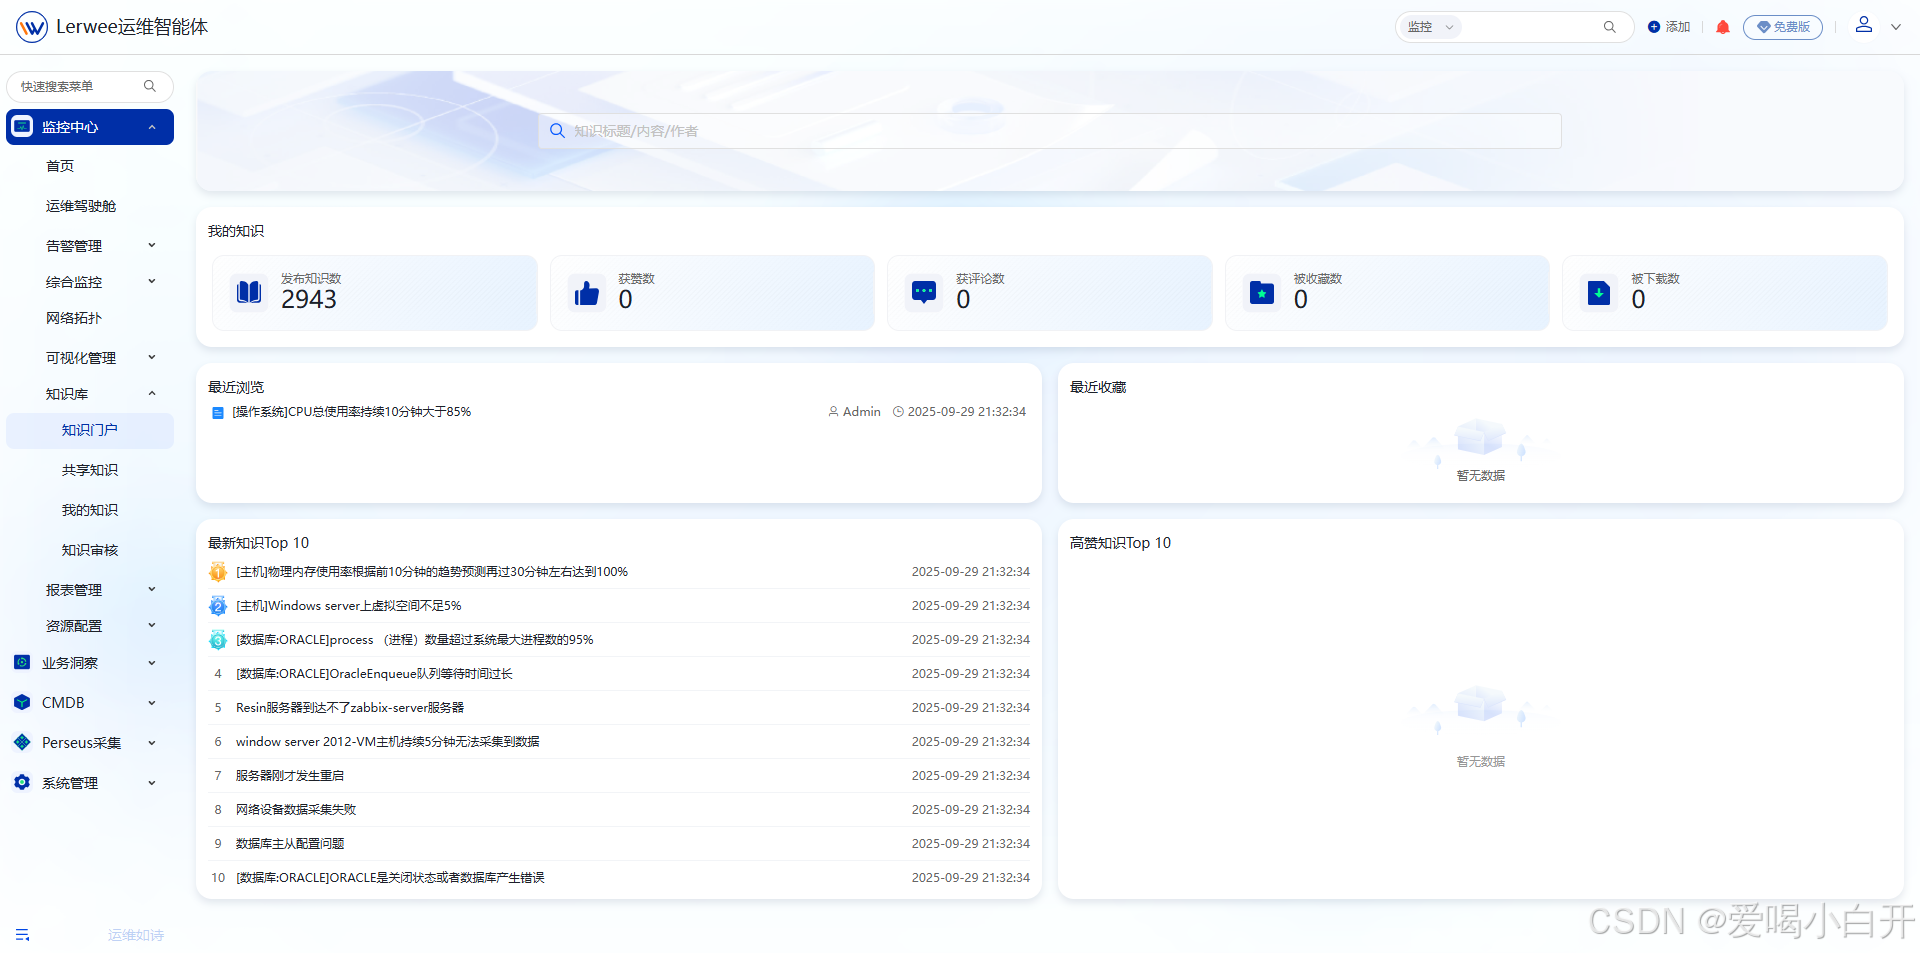
打造“从问题识别-知识匹配-方案执行”全链路设计的知识库
知识门户(从界面上可以看到知识数量以及高频的知识)
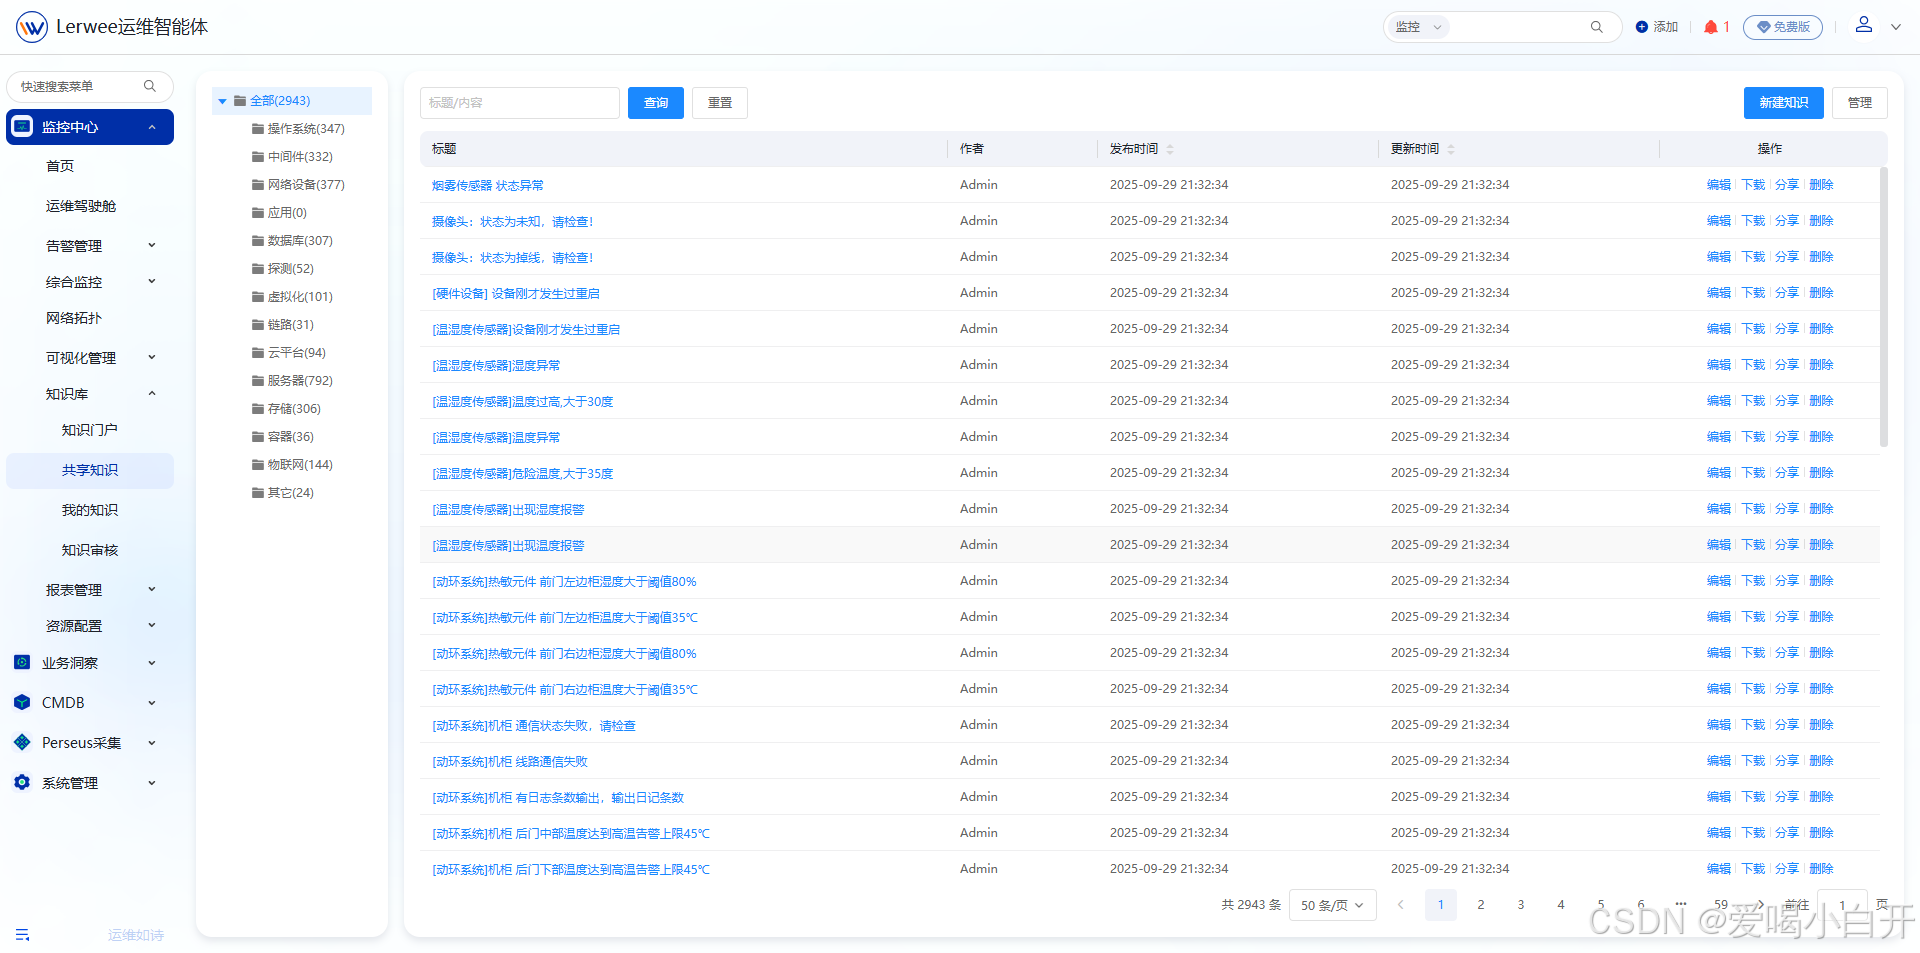
共享知识(这里是所有已归类的知识)
这里的知识不仅仅提供了权限控,还能配置知识分词匹配告警以及匹配知识分类。
我的知识(我创建的所有知识)
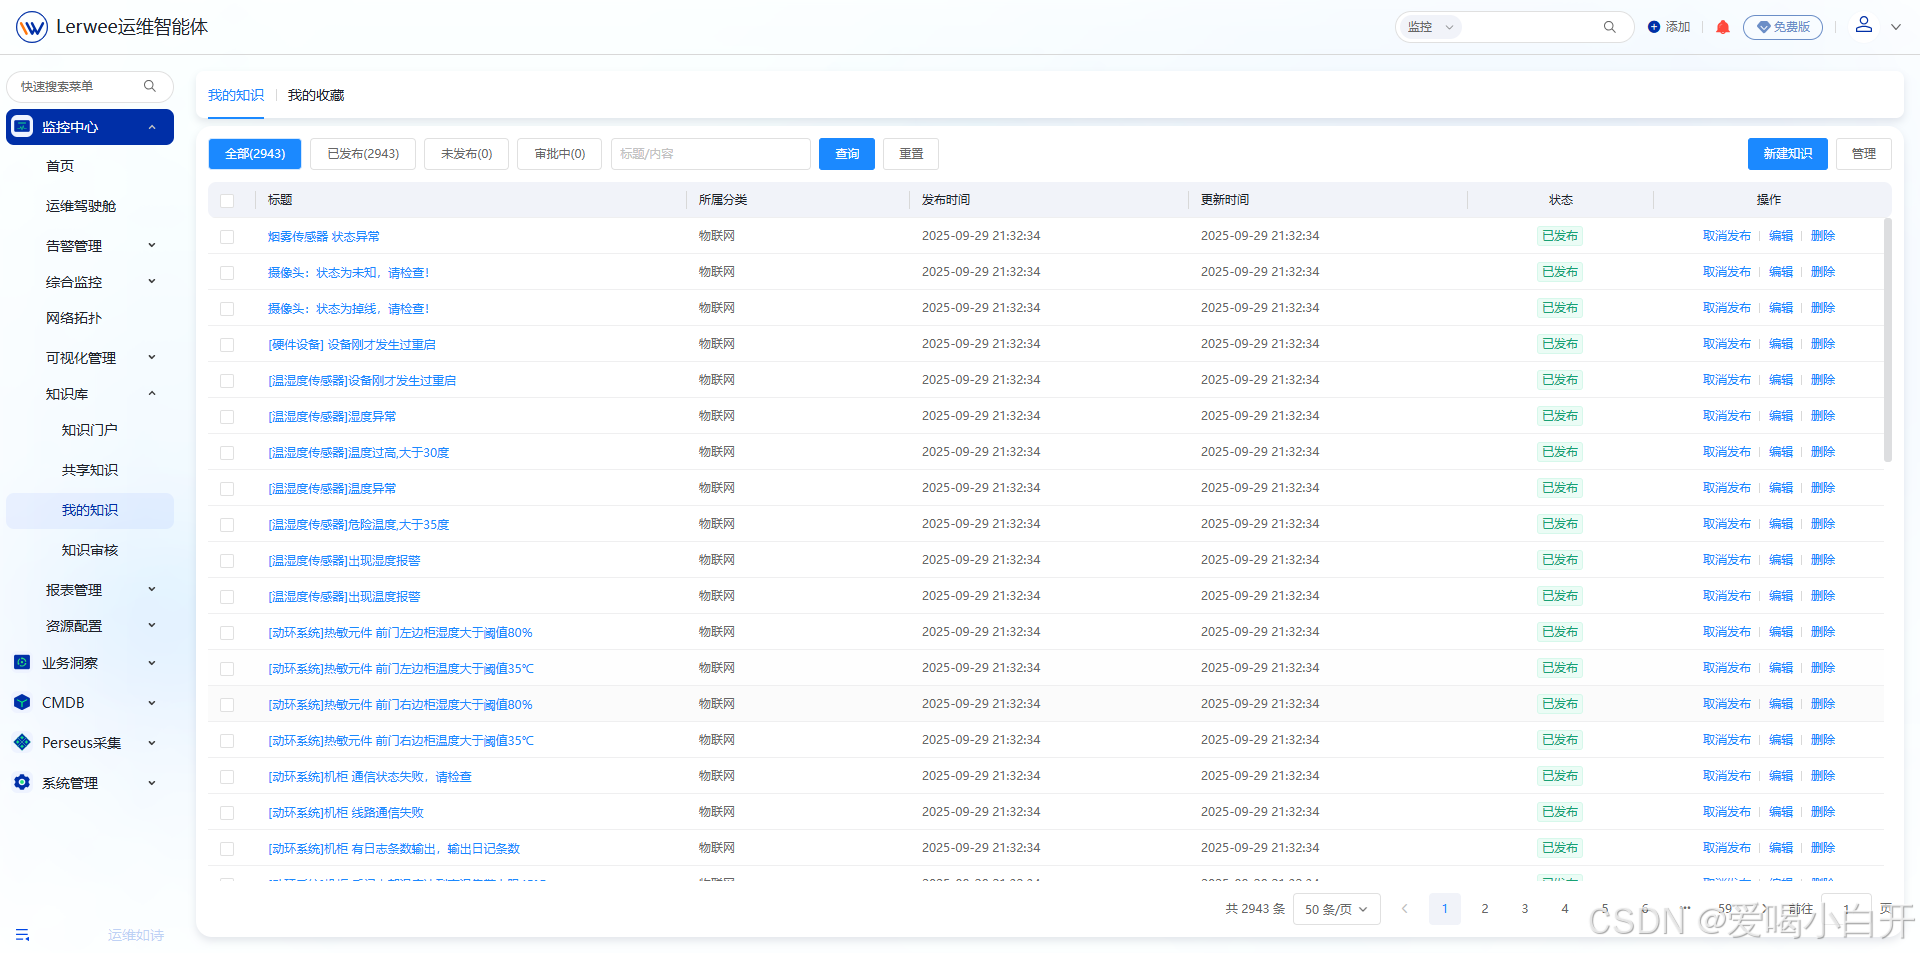
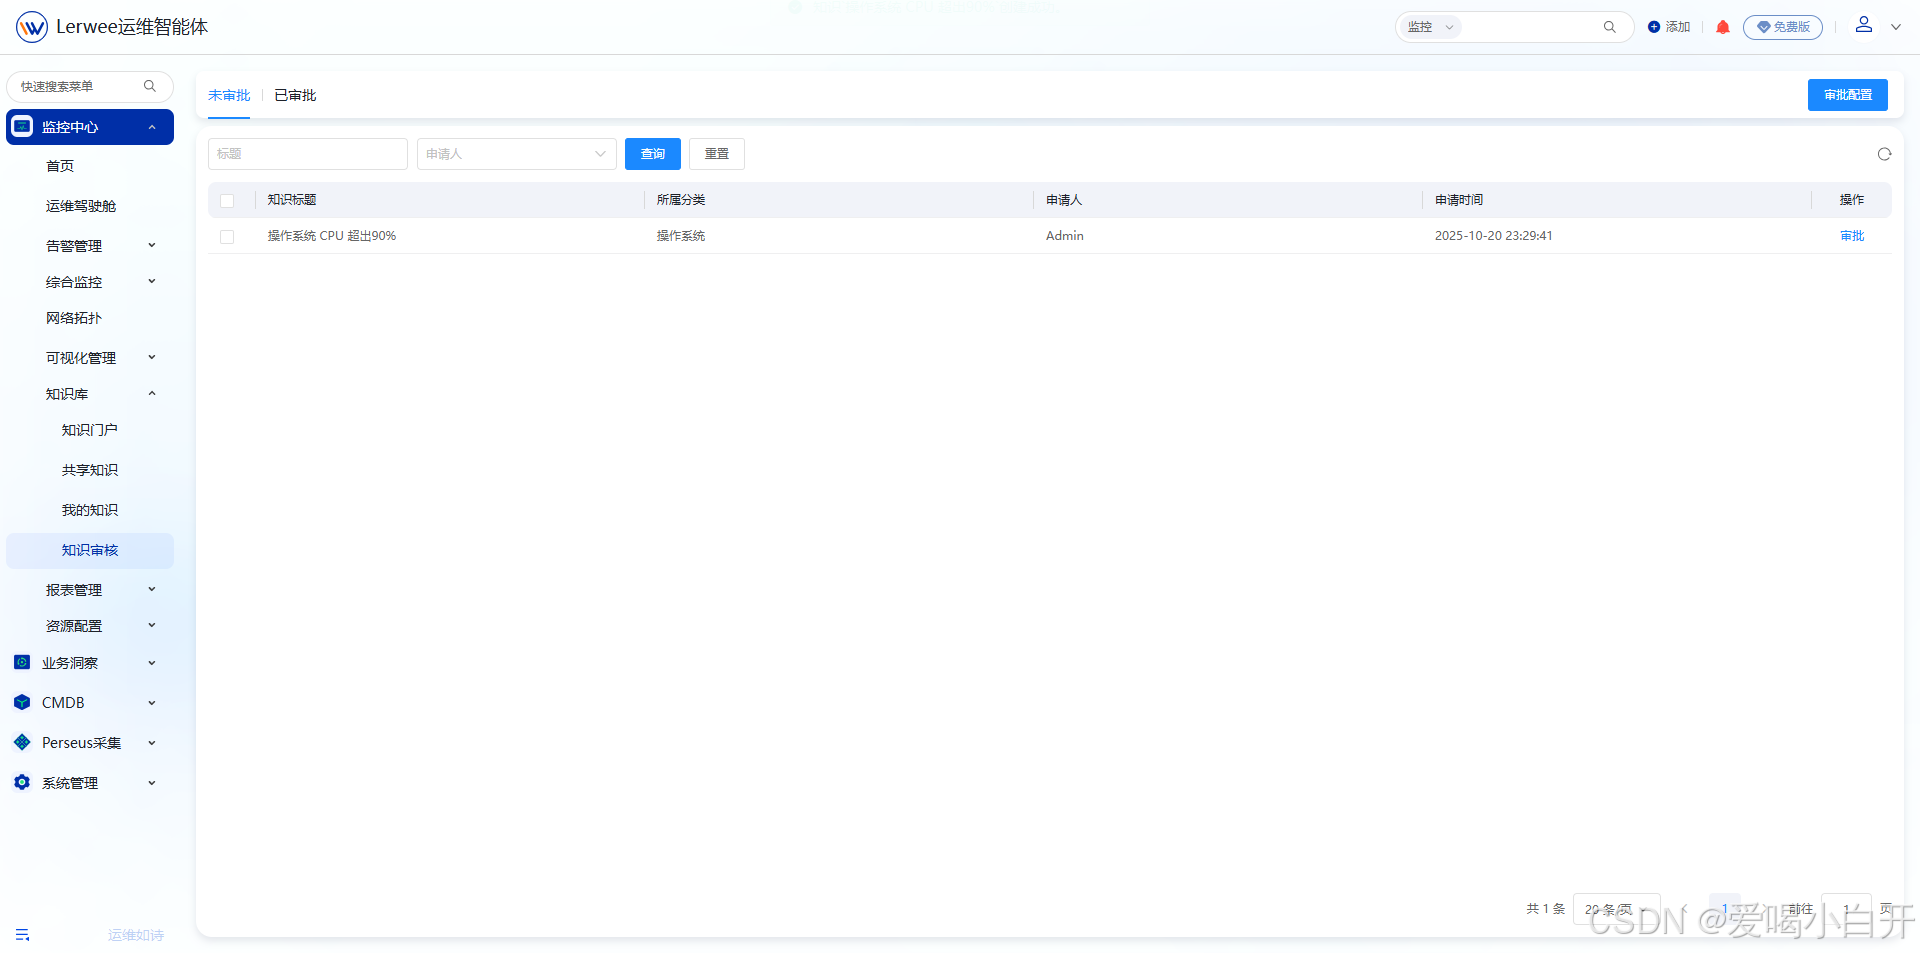
知识审核(知识审核管理,确保知识质量可行可用)
报表管理
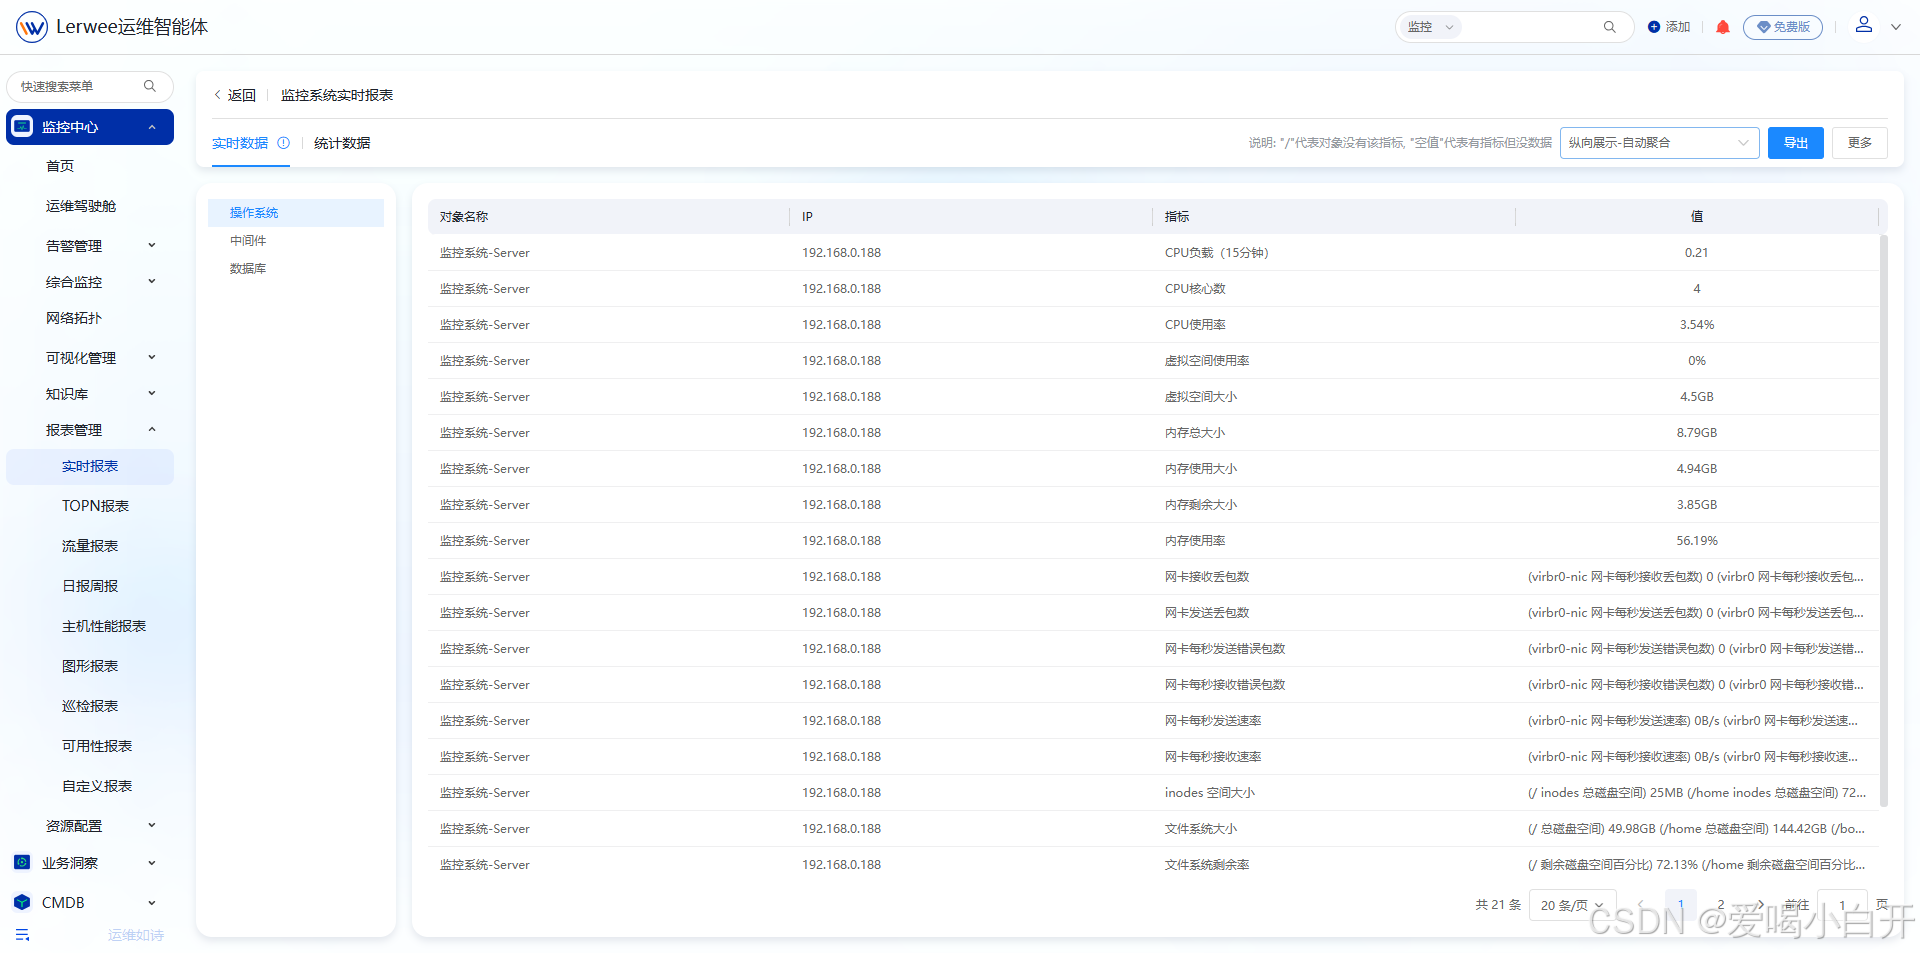
一个可以实时查询的实时报表
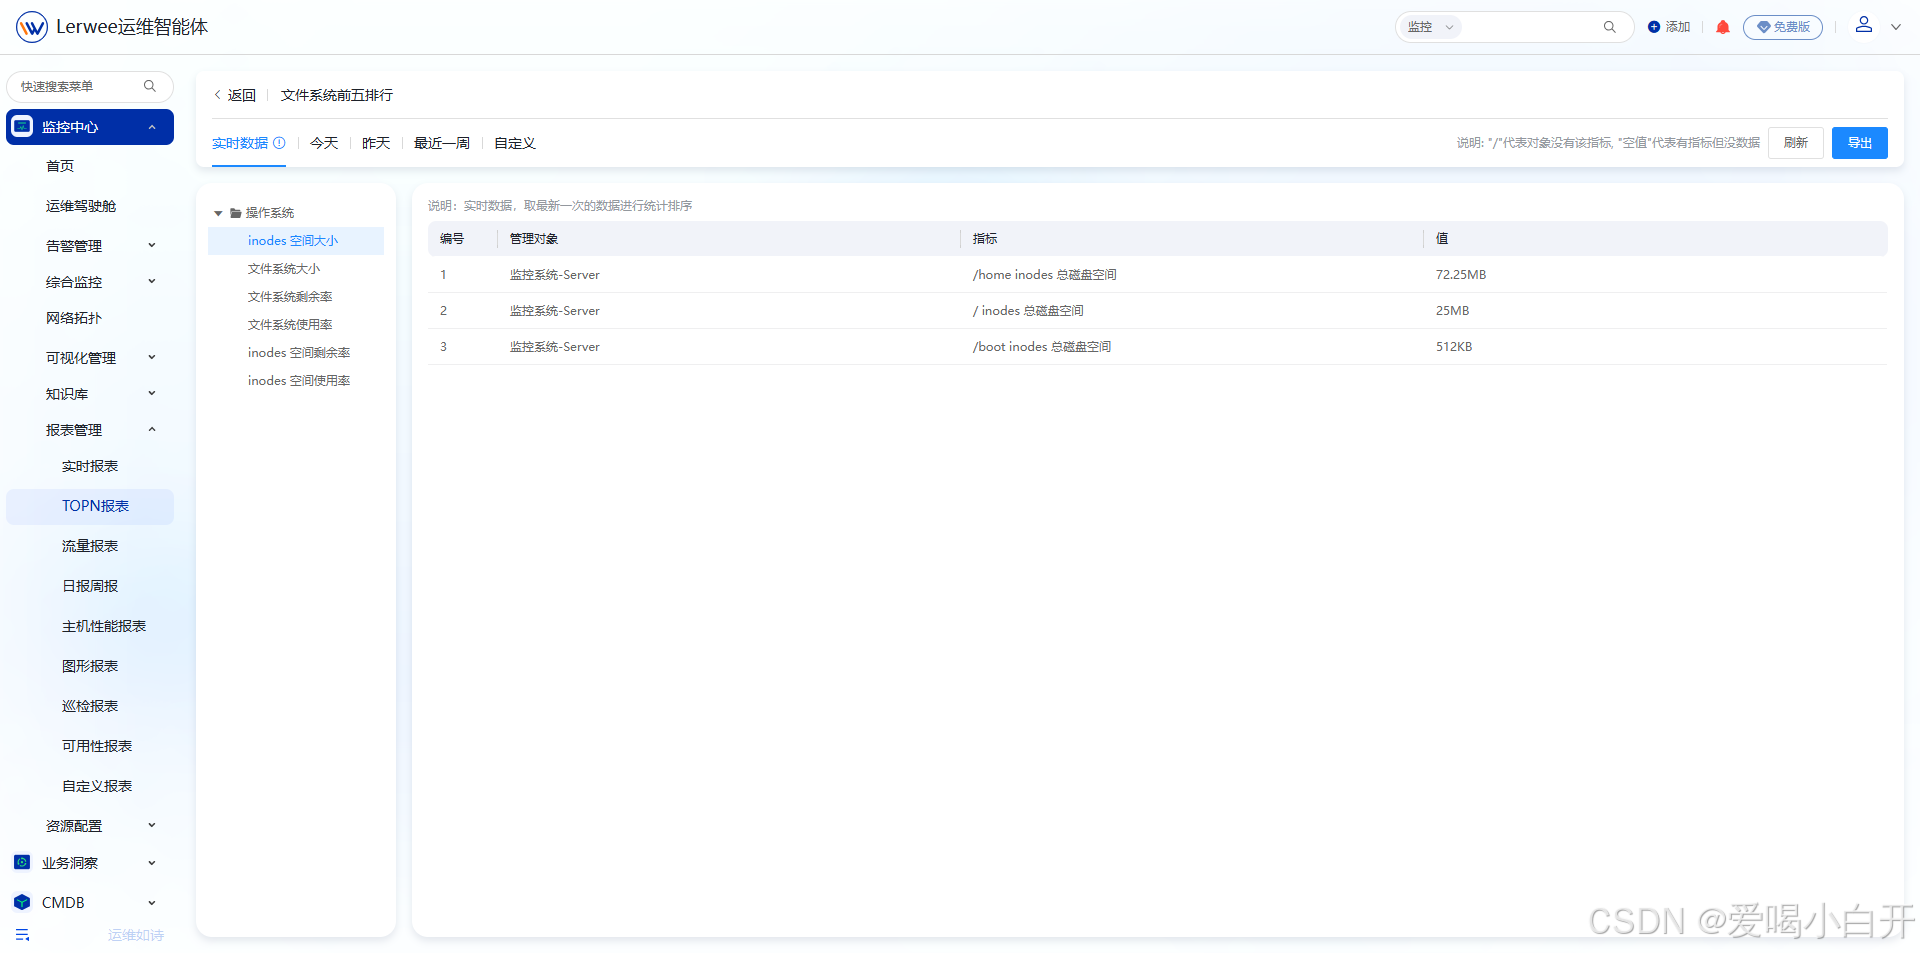
一个会排行的报表
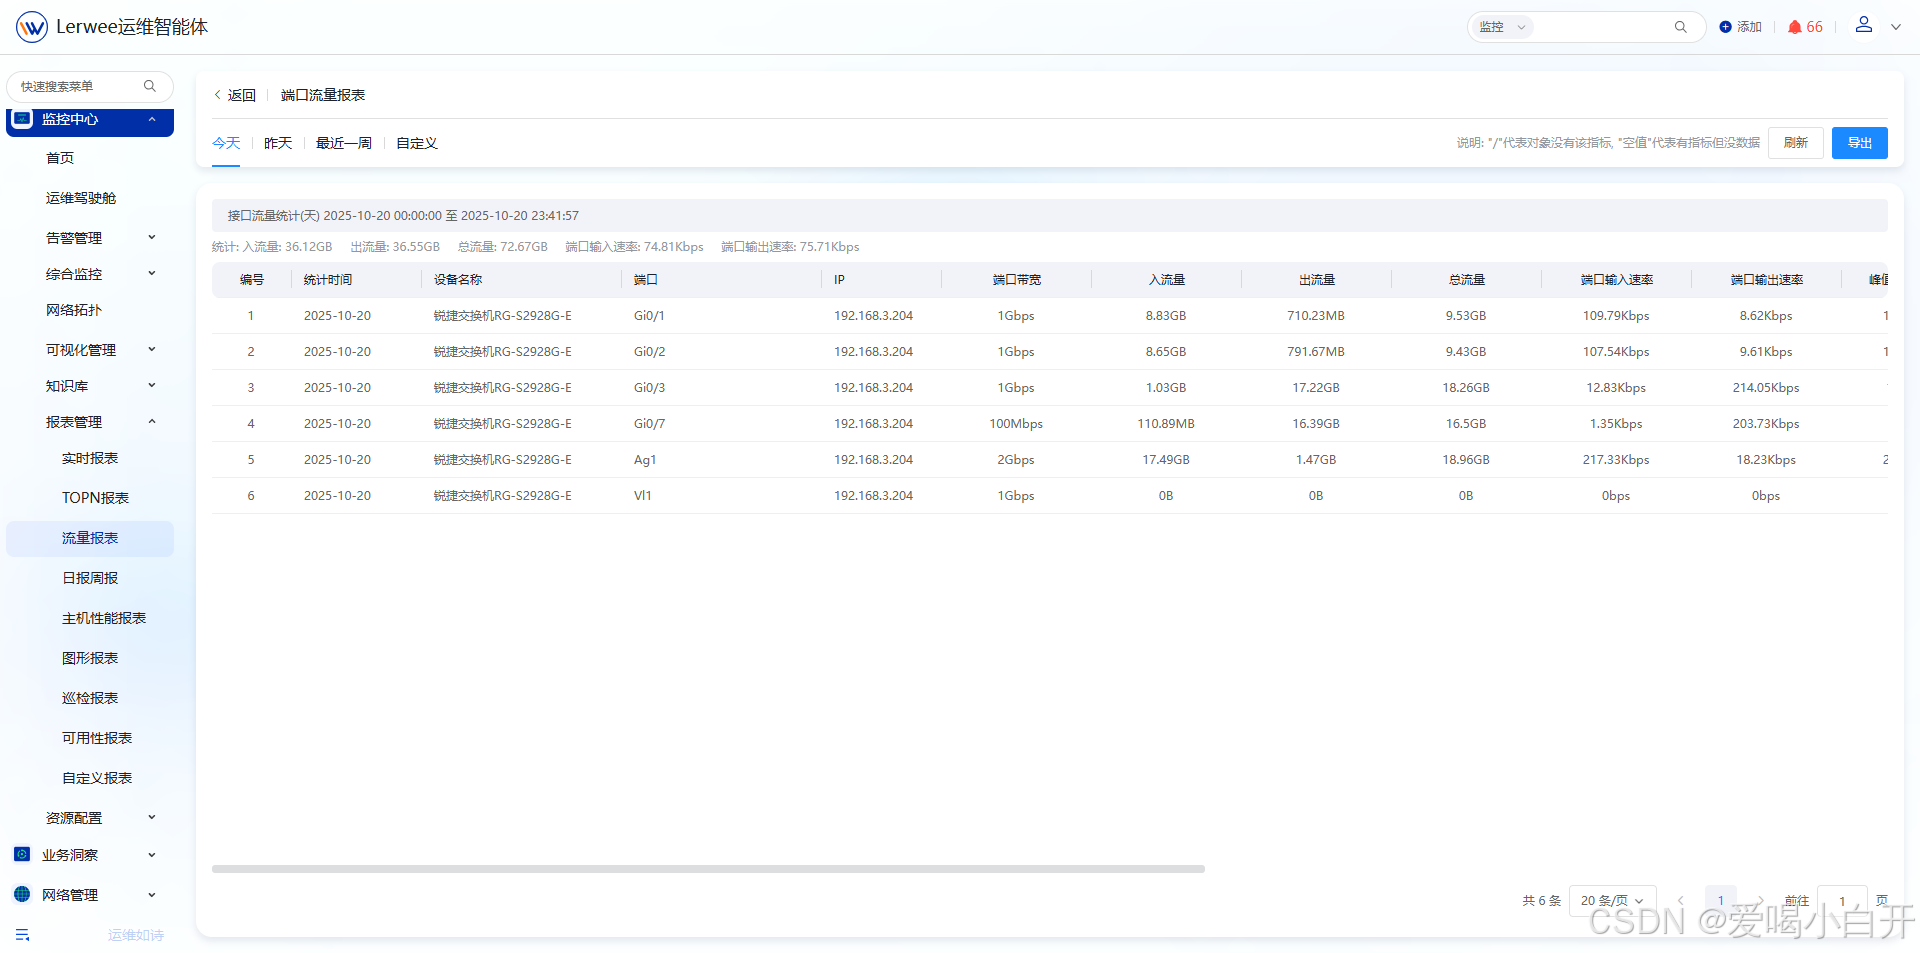
一个查询网络设备端口流量的流量报表
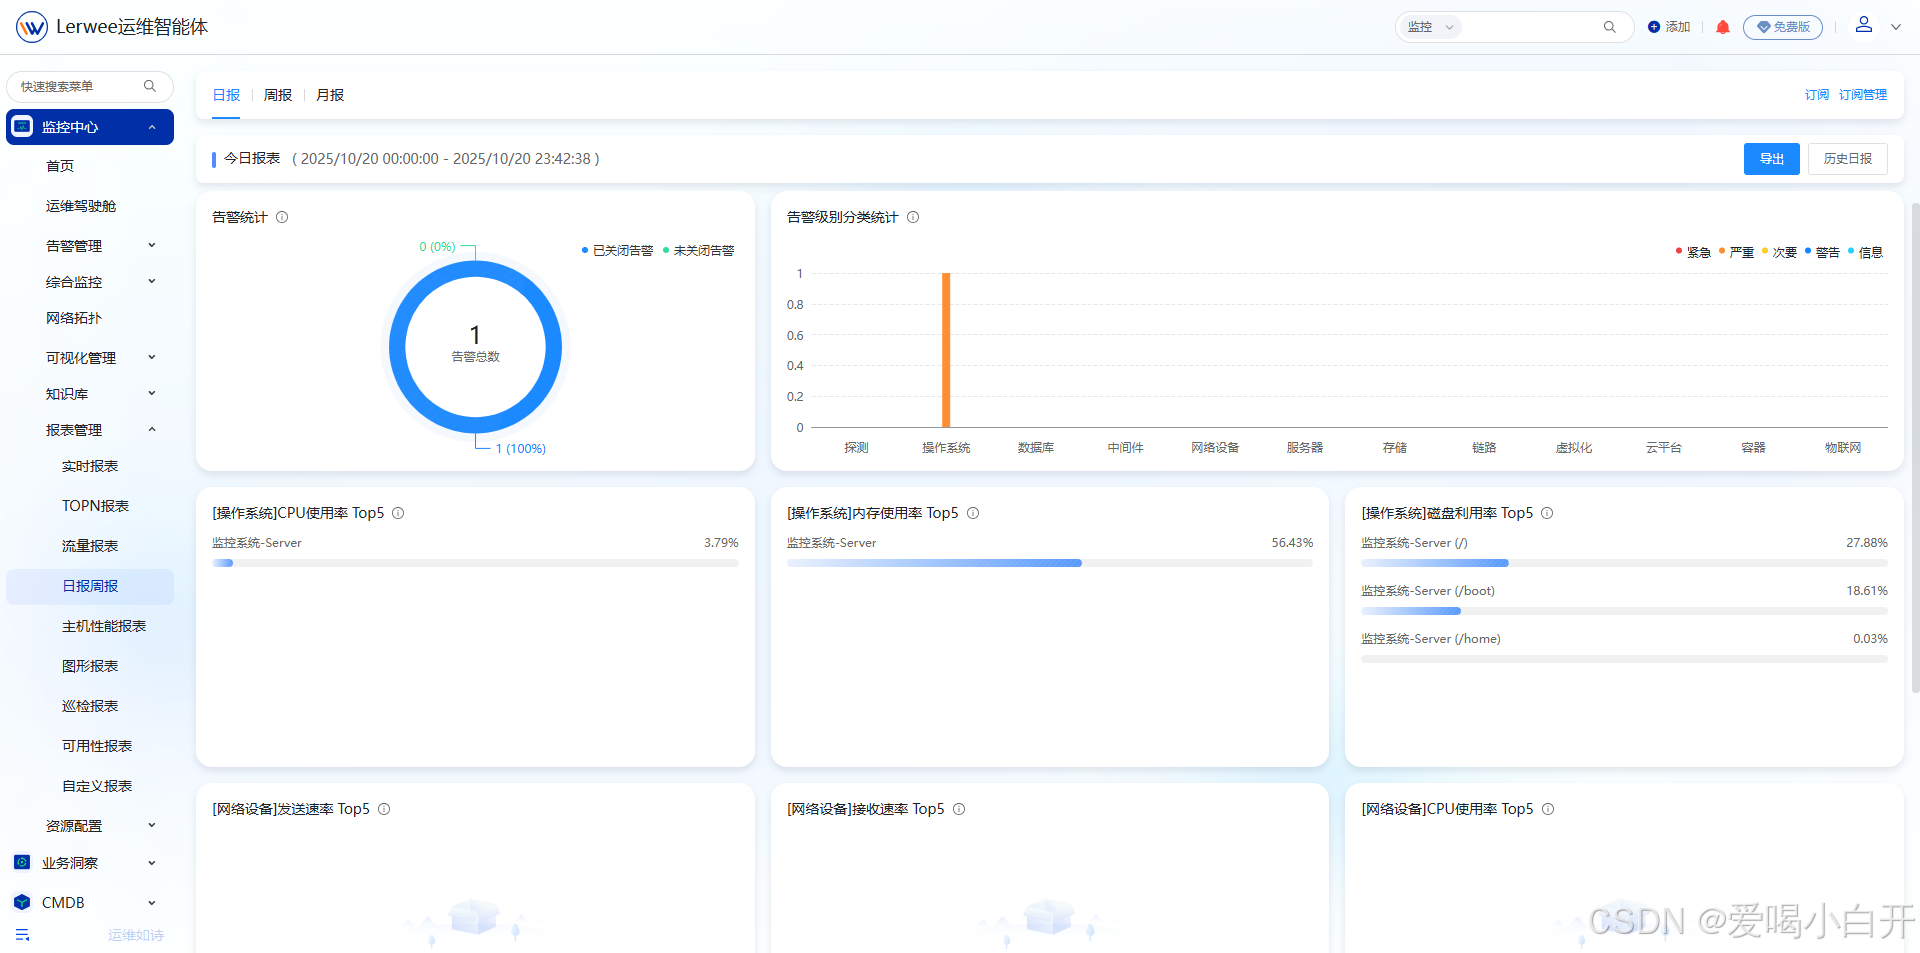
日报周报月报
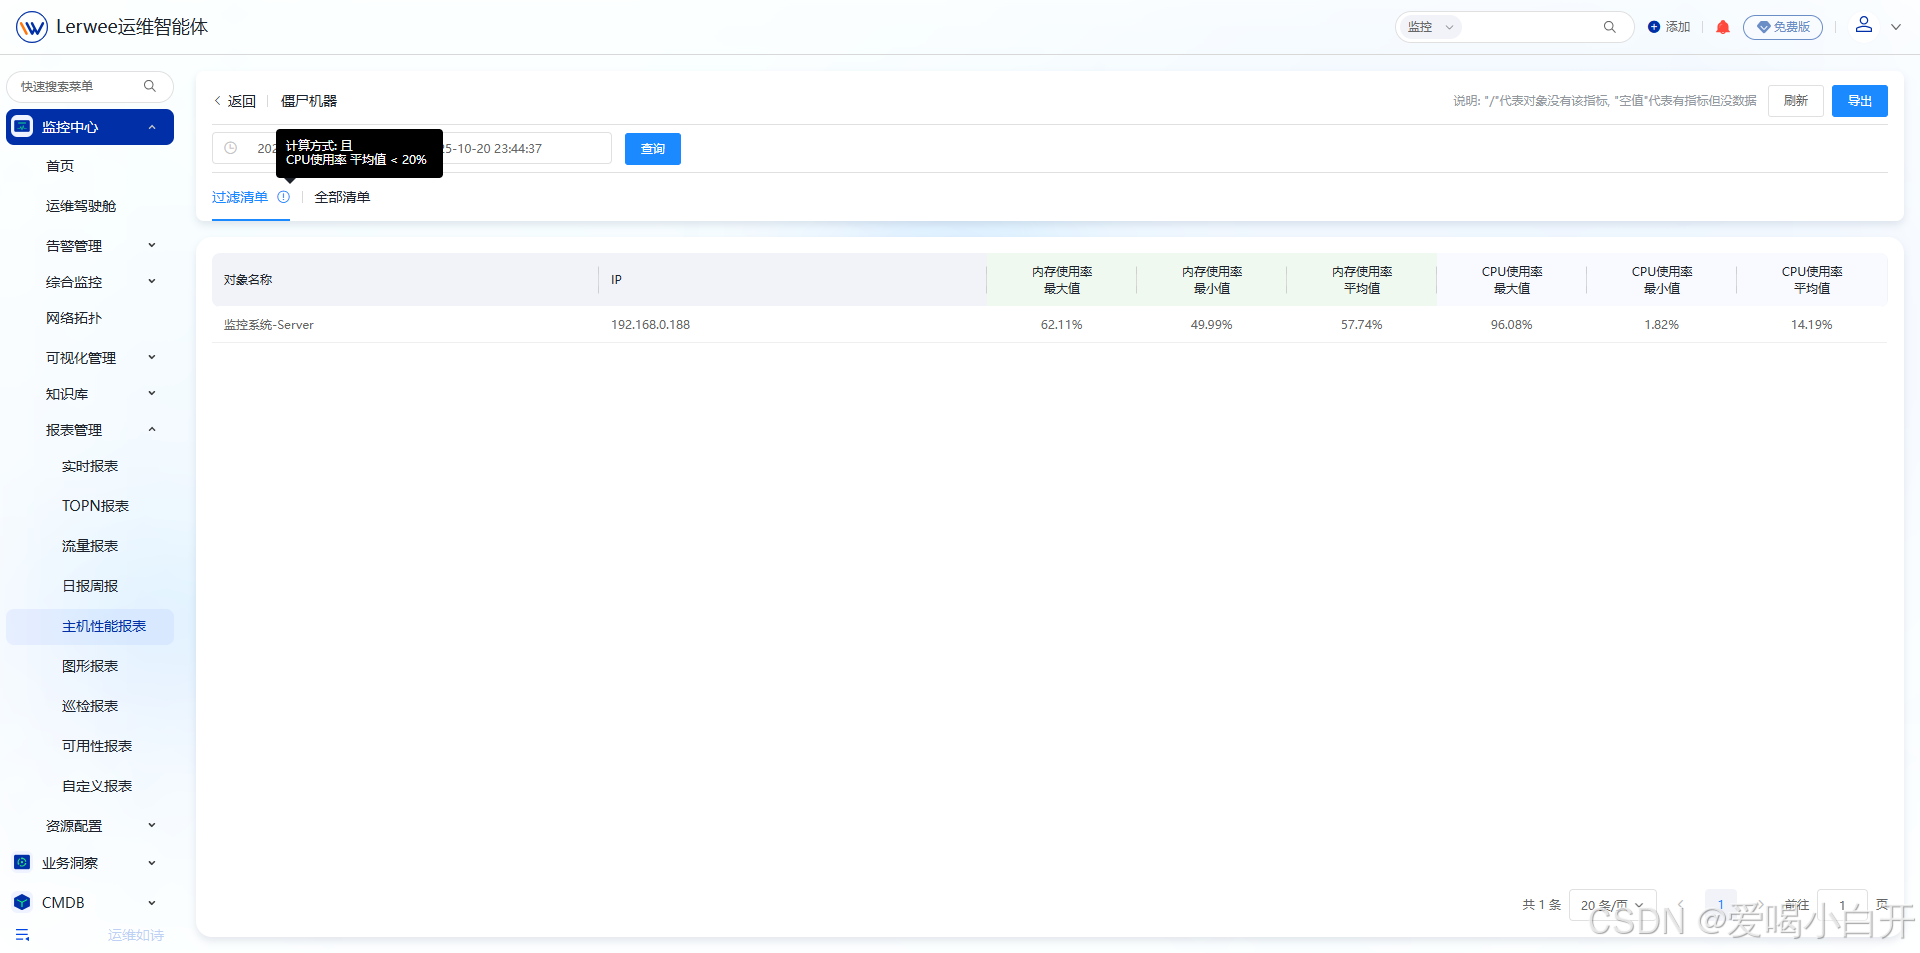
一个能检测僵尸设备的主机性能报表
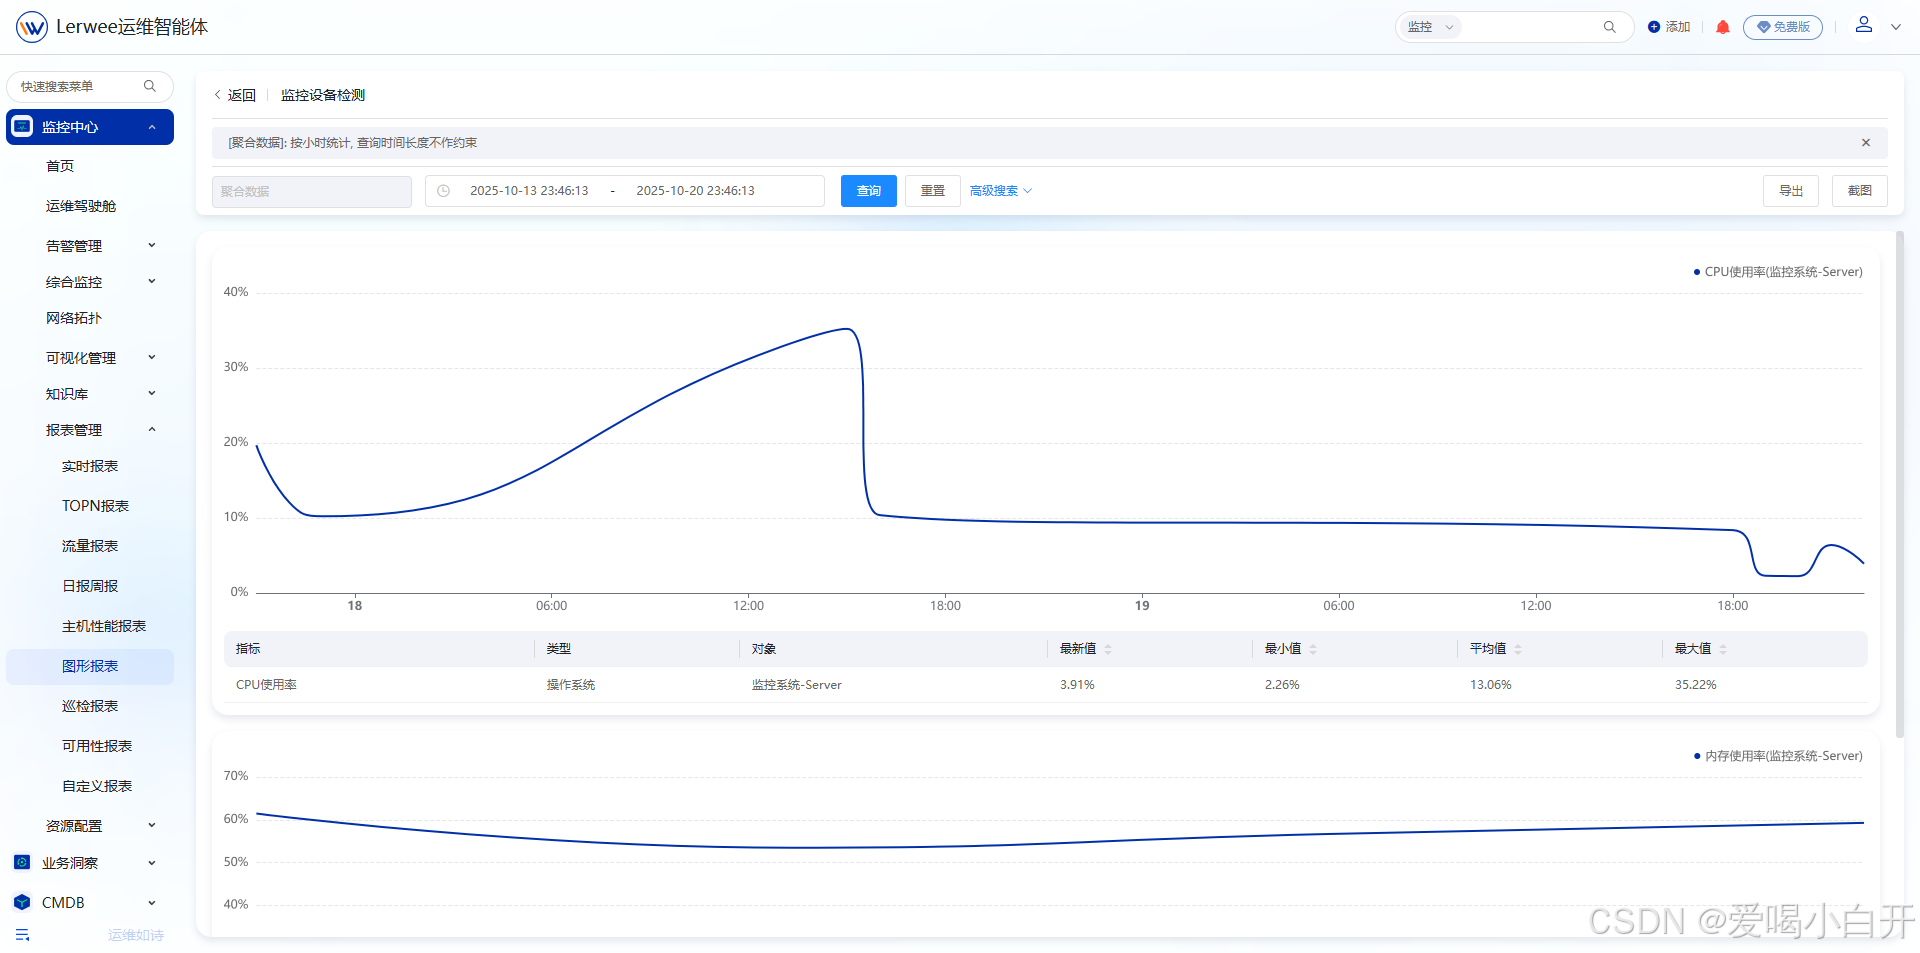
一个可以查询某个业务下各项指标趋势的图形报表
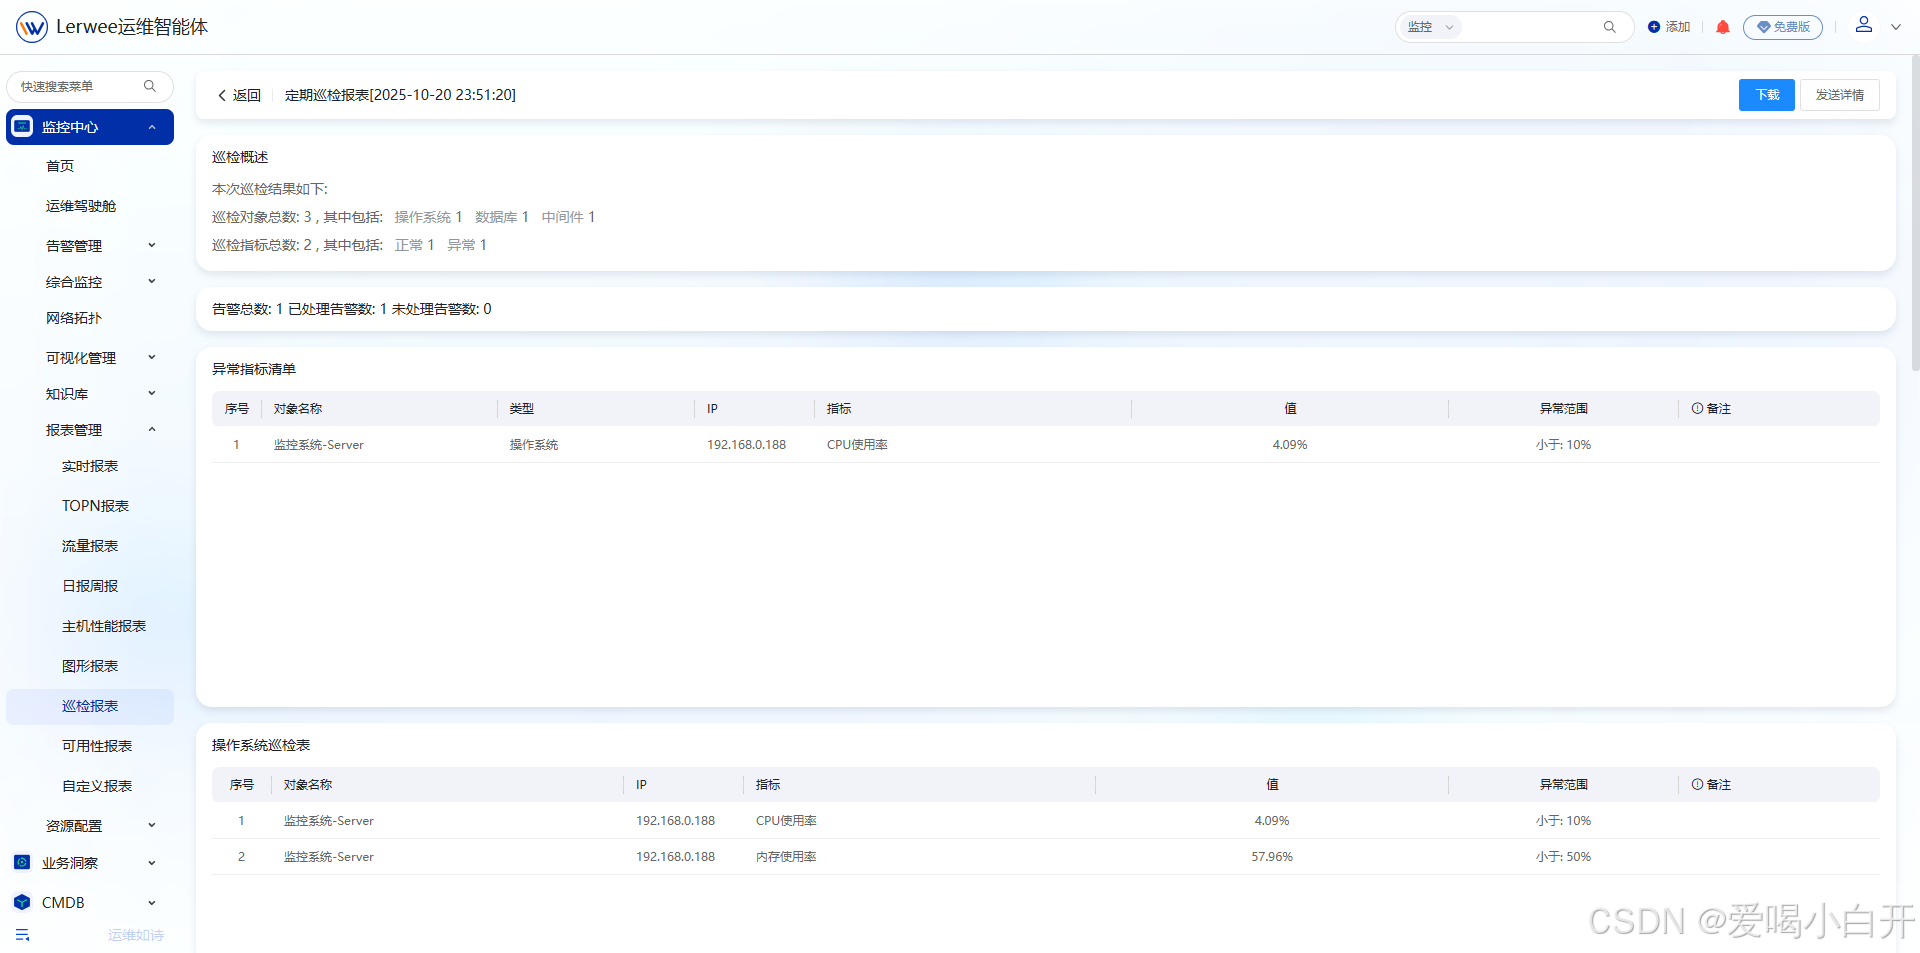
一个可以定期检测异常的巡检报表
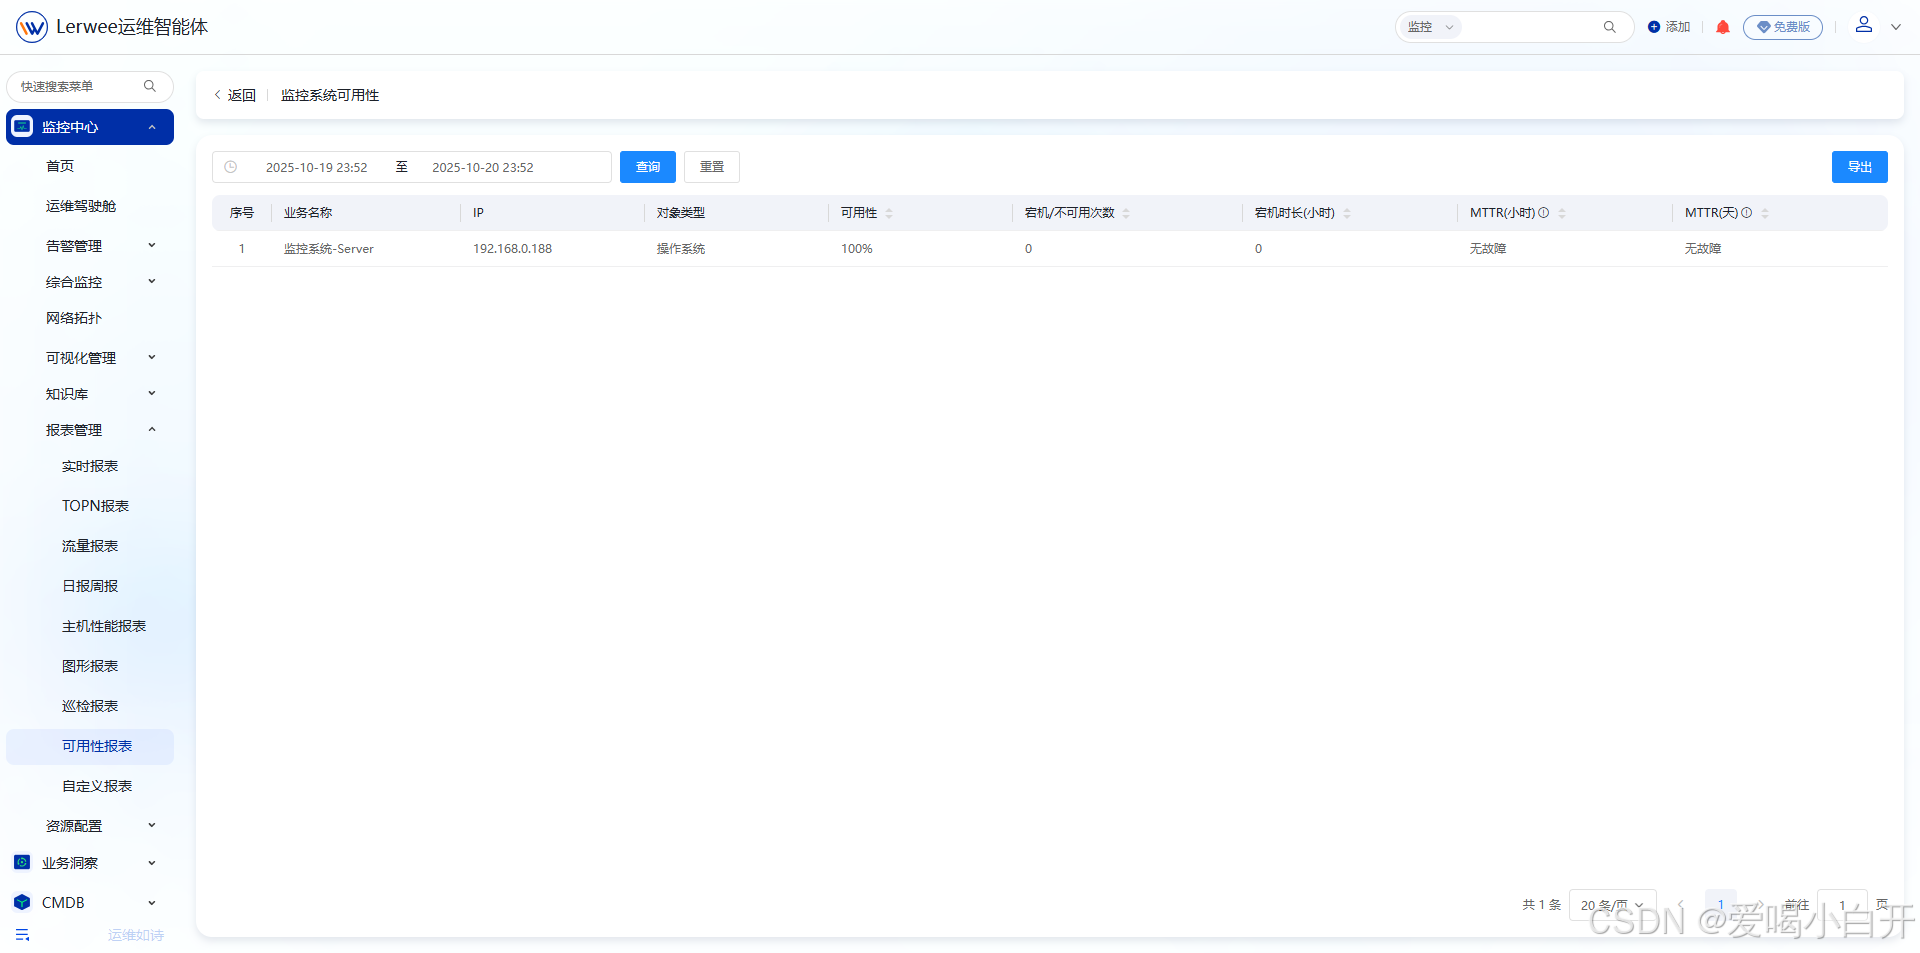
一个可以确定设备是否故障的可用性报表
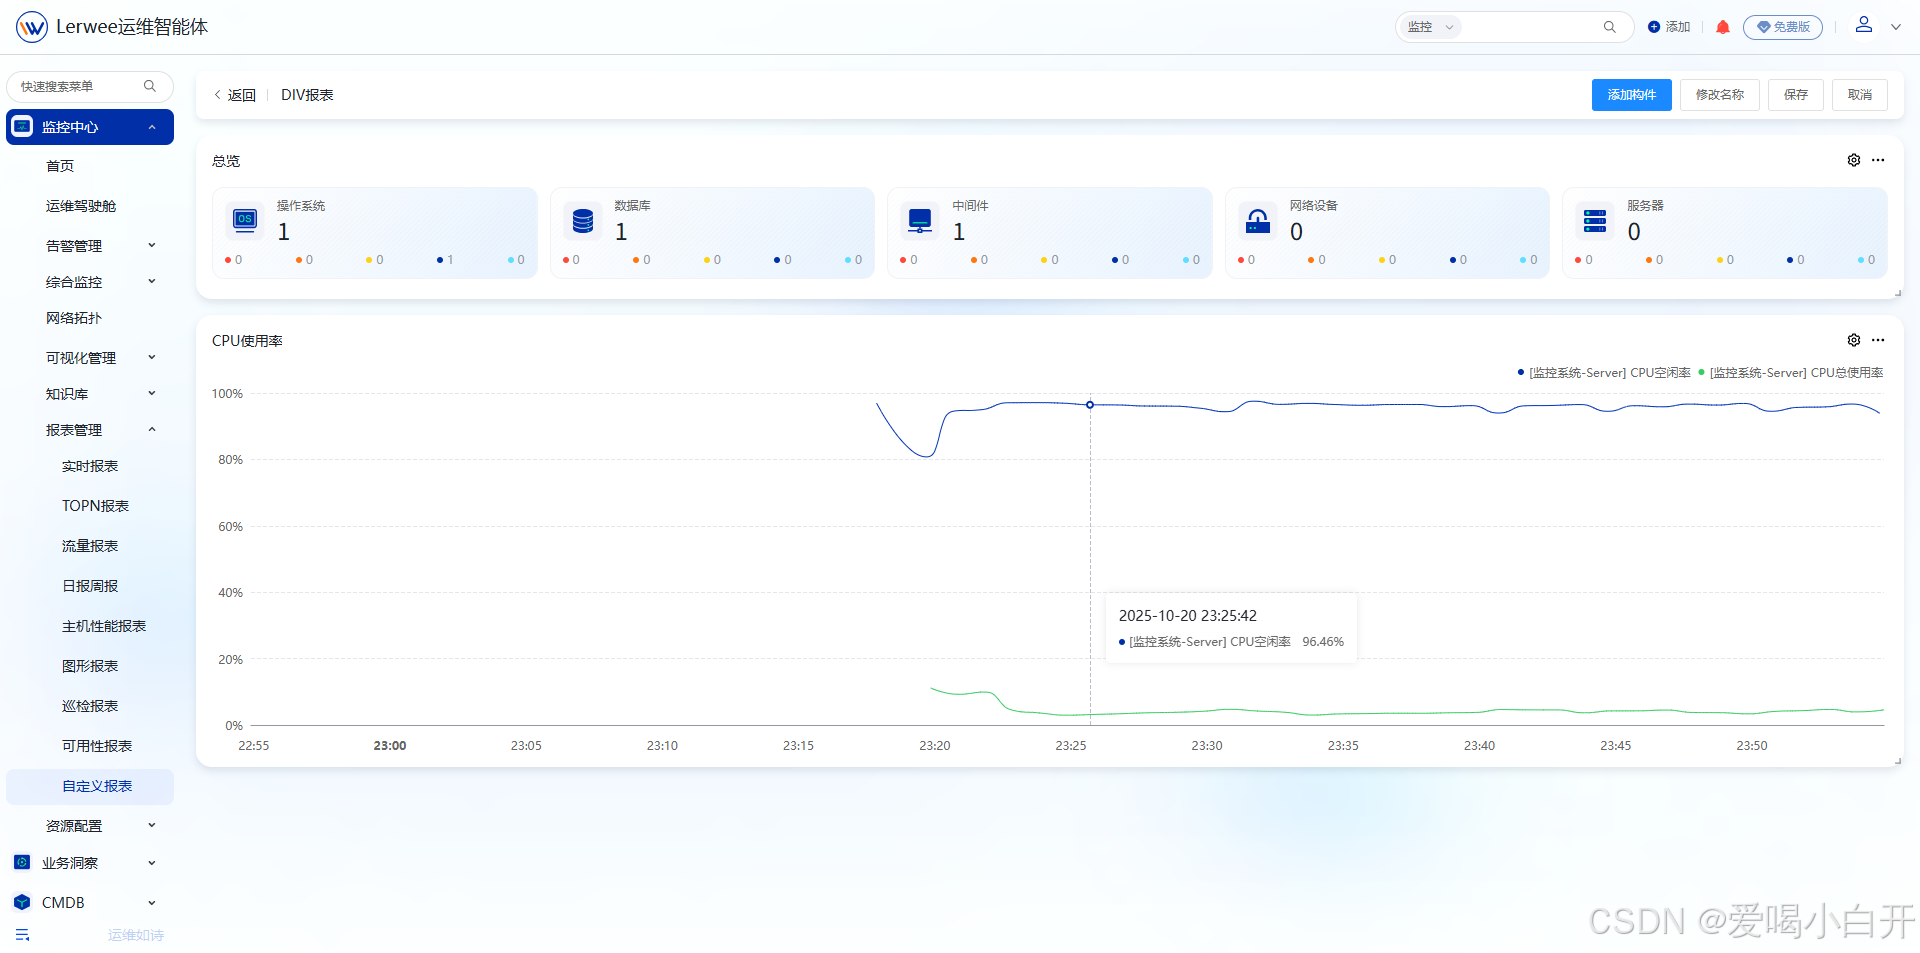
一个可以DIV的自定义报表
资源配置
针对监控模板、指标、宏、维护模式配置。
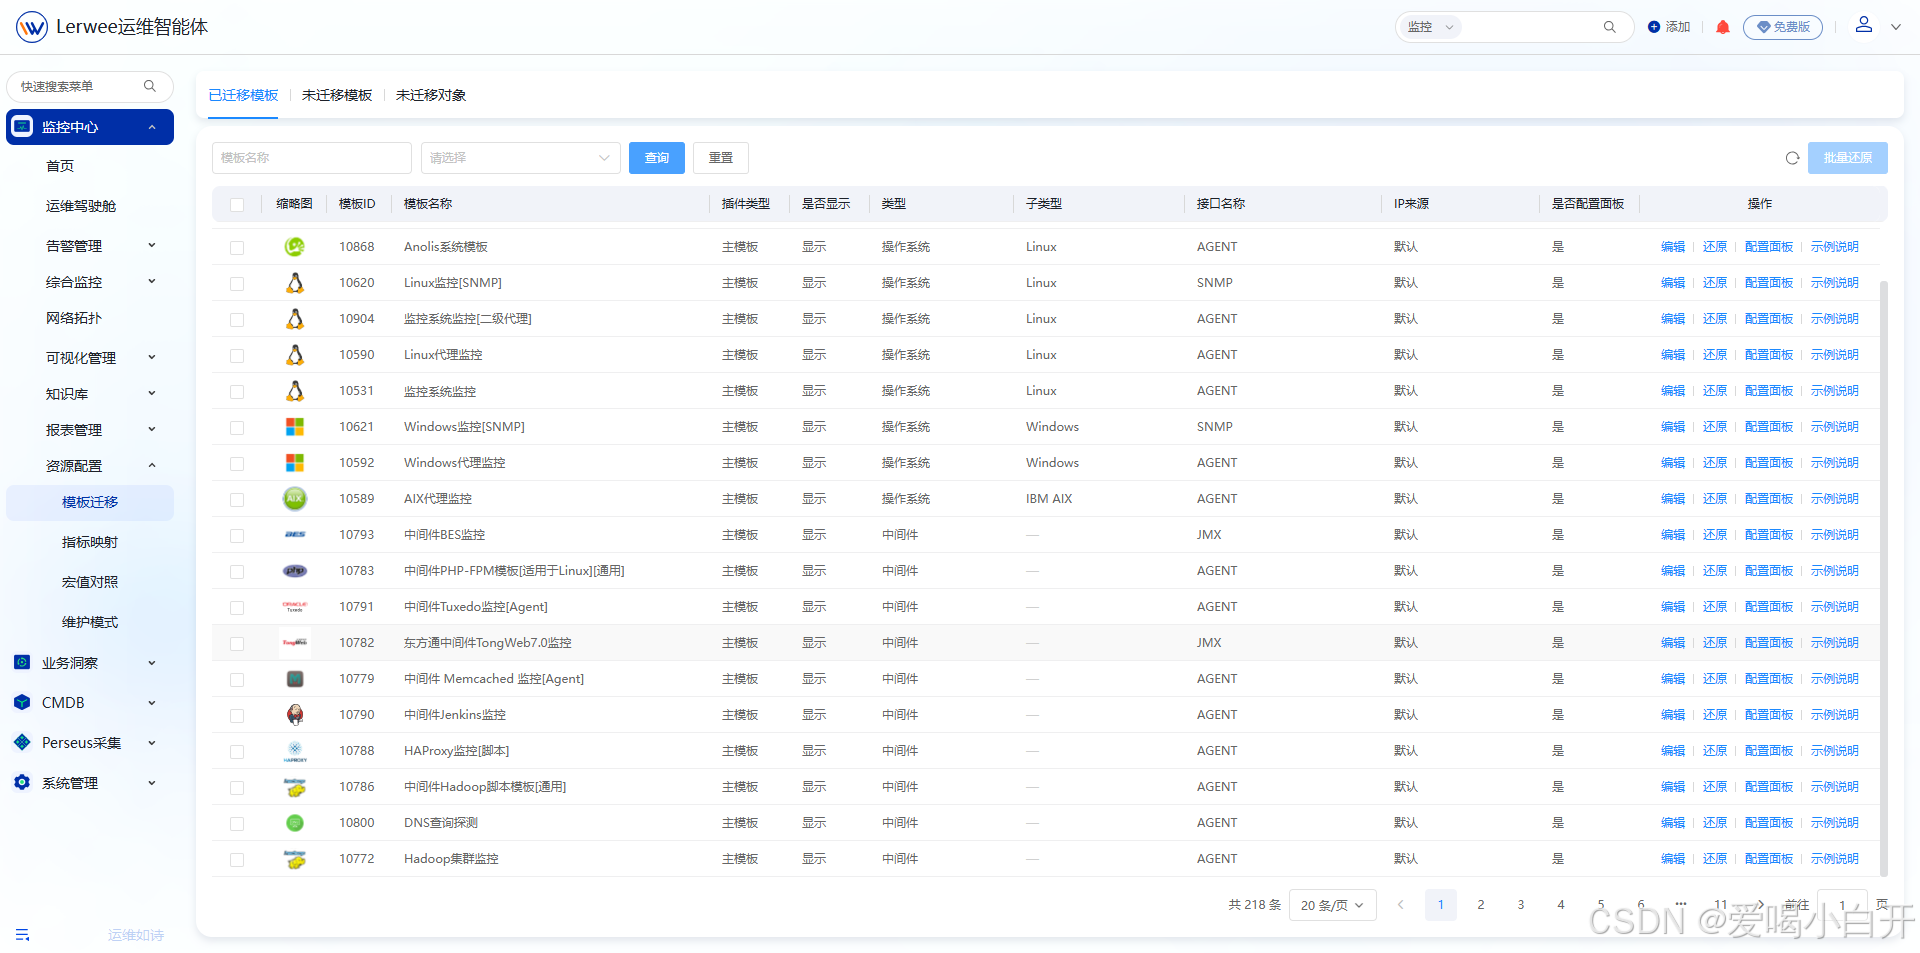
模板迁移
模板迁移是对模板进行归类(如操作系统、数据库、中间件等),并在模板的基础上为对设备详情面板配置配置、为模板配置示例说明以及设定采集异常的触发器。
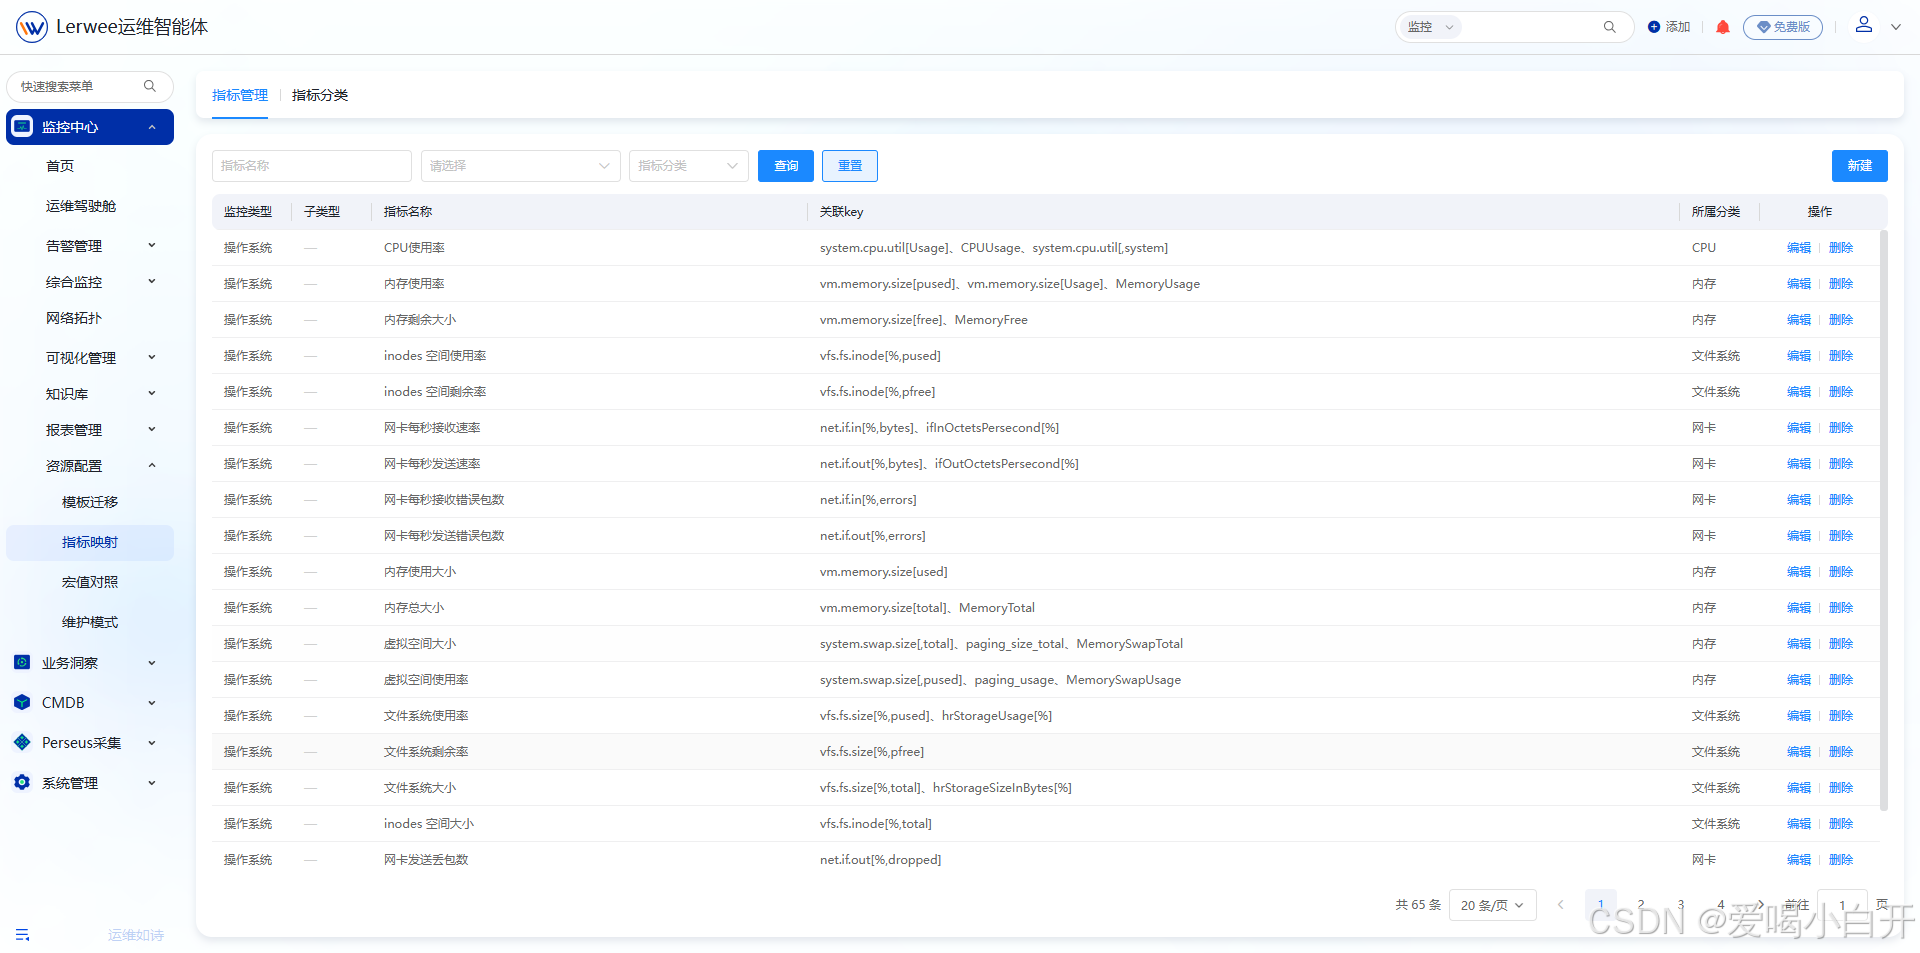
指标映射
这里的意思是多个键值值映射为一个指标,举个粟子:
操作系统有个CPU的键值,网络设备也有另外一个CPU的键值,这样就会产生一个疑惑,为什么不归类成一个指标:CPU,后面直接使用“CPU”这个指标,就可以查出CPU的指标,不需要多选几个操作系统CPU指标、网络设备CPU指标了。
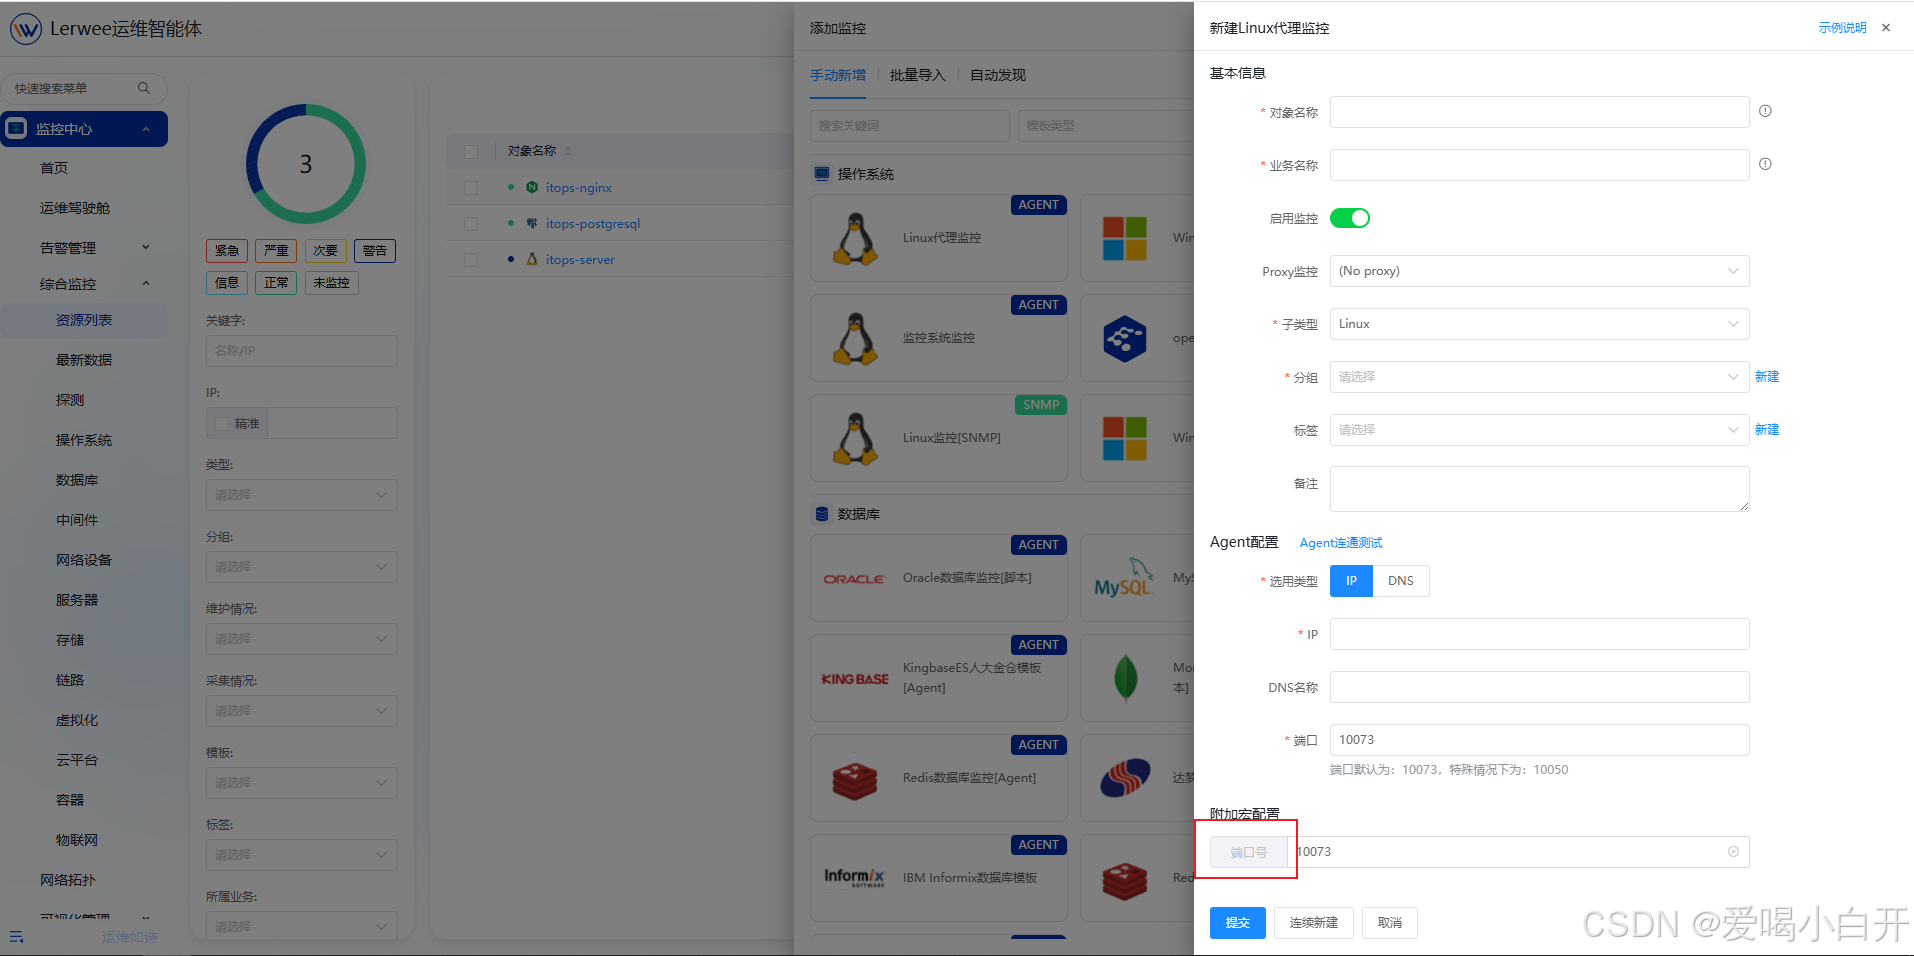
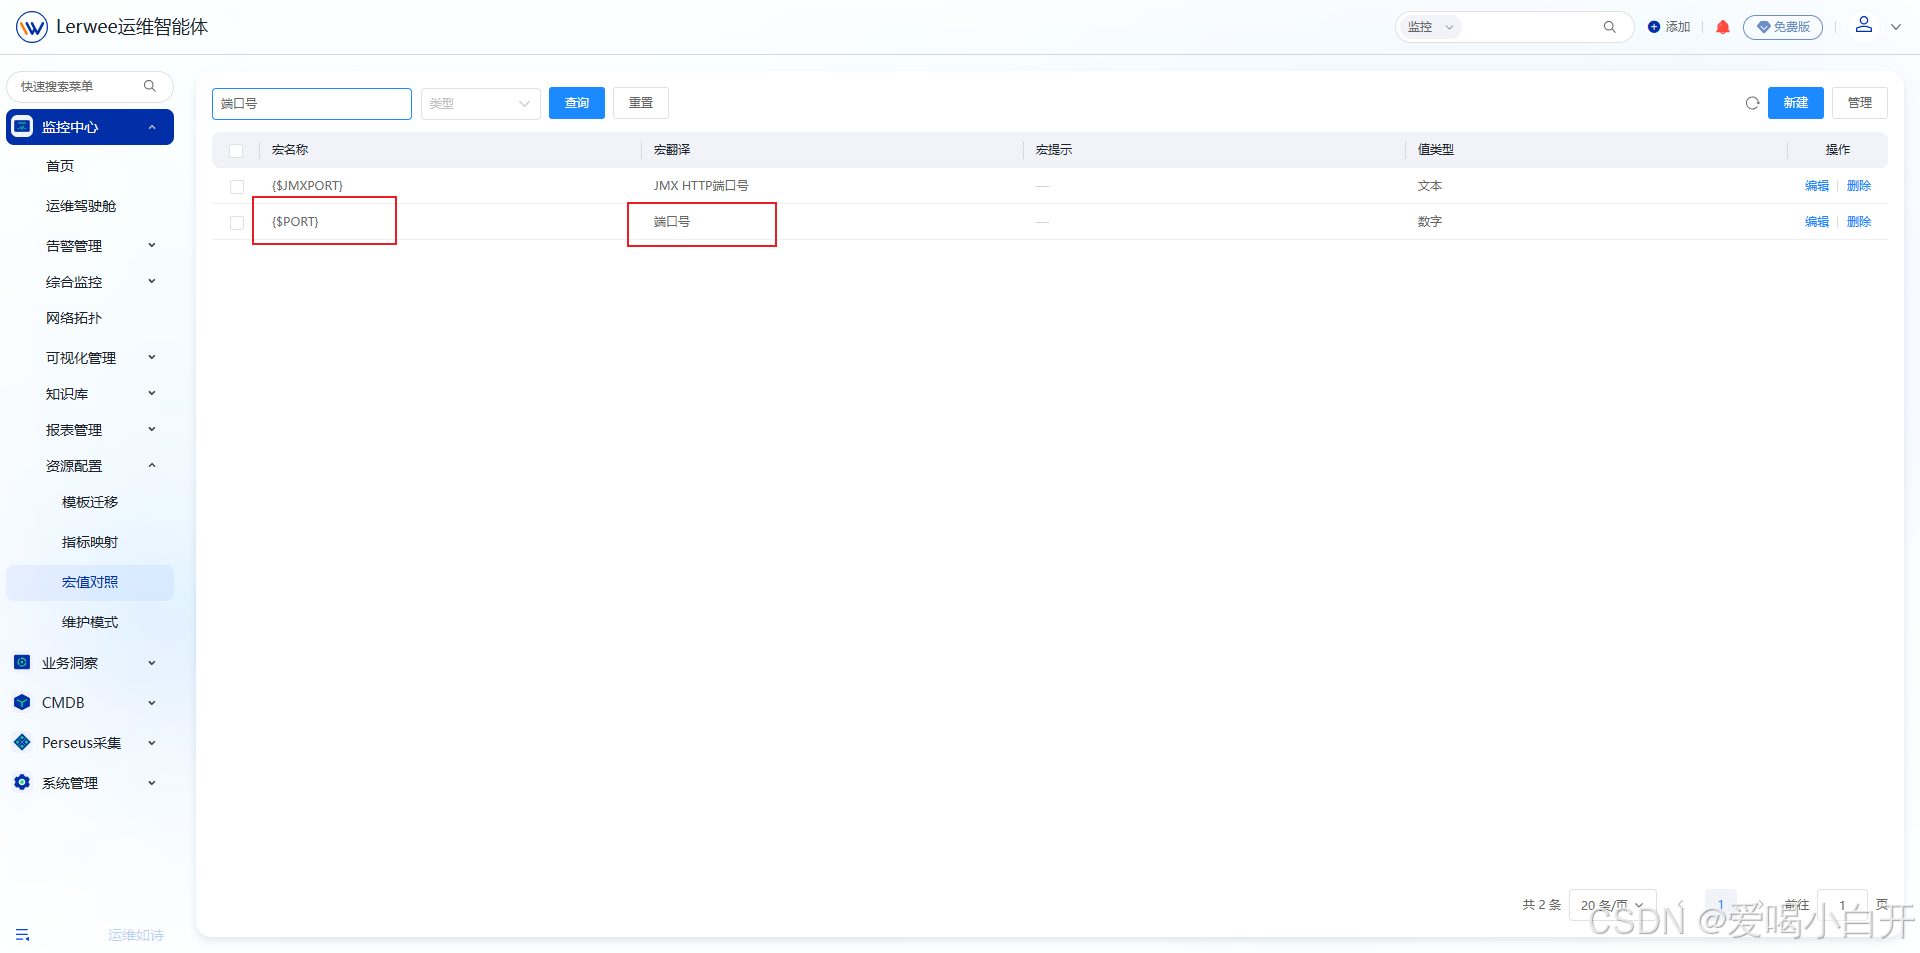
宏值对照
针对本系统中使用的宏,进行翻译,转化为人们容易识别的宏翻译。
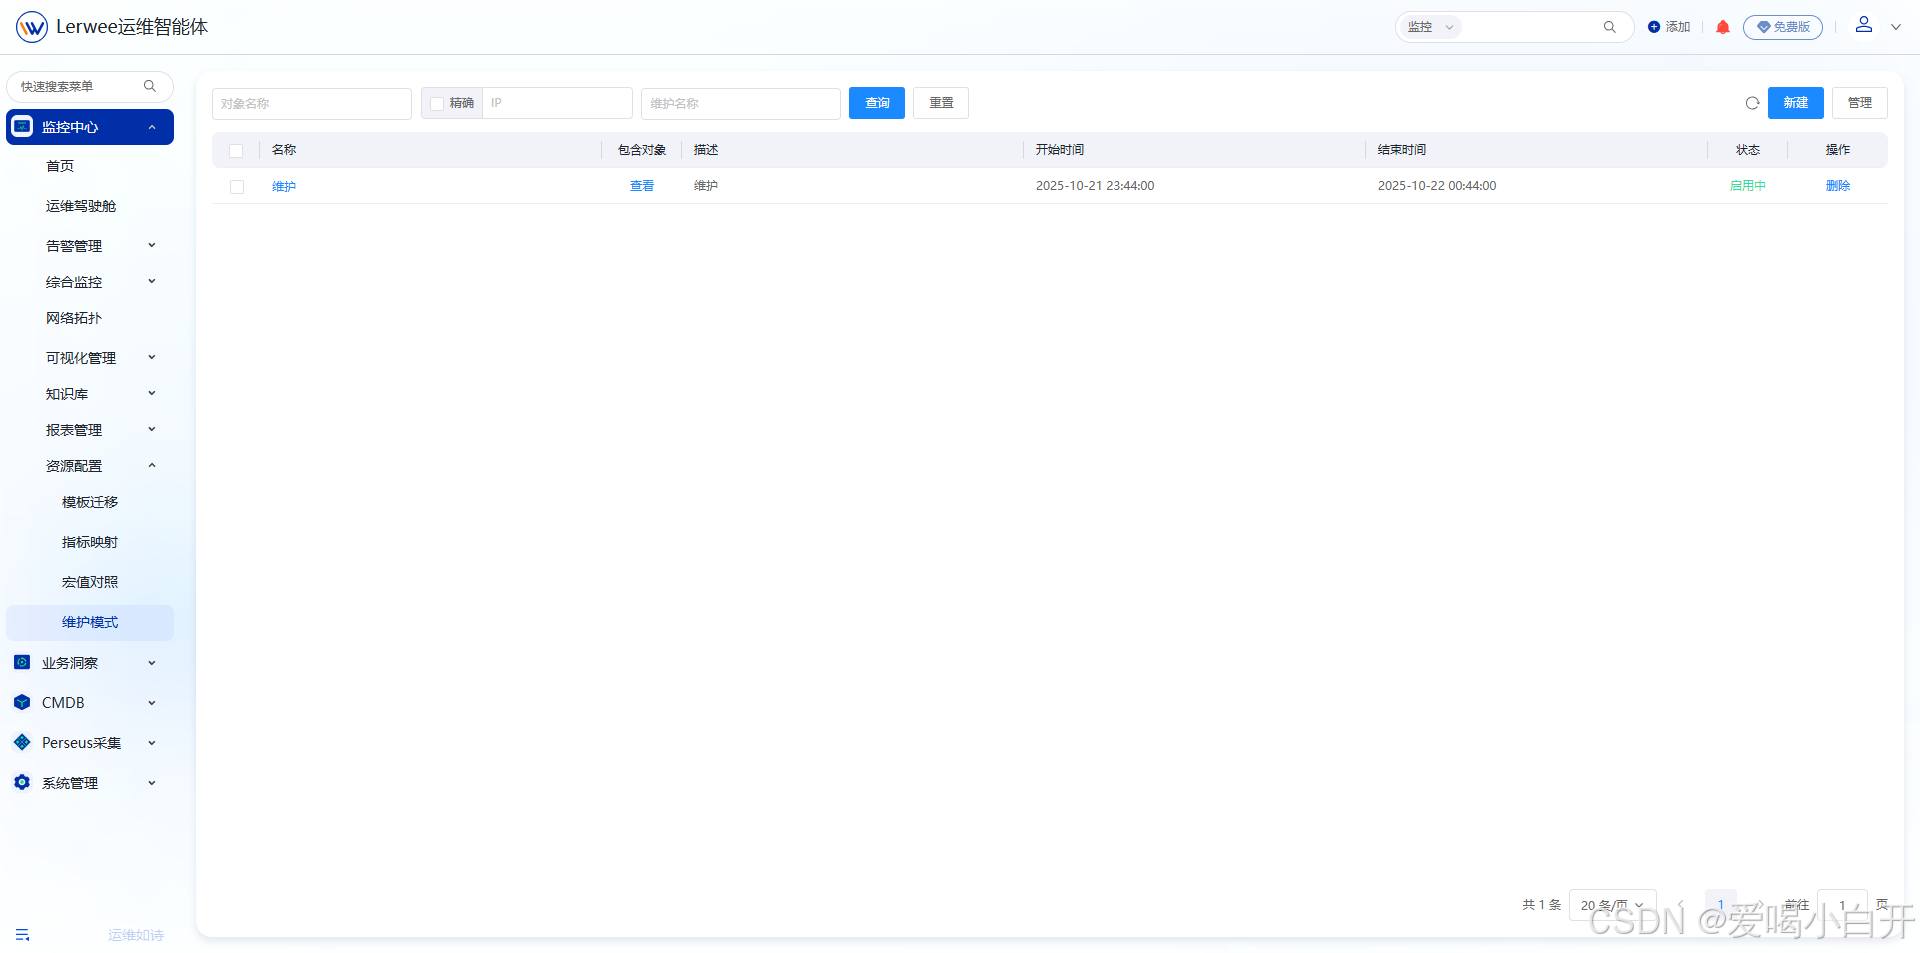
维护模式
监控设备如果发生故障、停机、检修等原因导致设备需要维护,那么就需要这个功能,可以选择性对这个设备进行维护,停止告警产生。这里还支持在维护期间是否支持数据采集,这就需要根据你个人判断了。
最后总结
我看过其他国产运维监控系统官网,要么部署包没有开放出来,要么就是部署太复杂化了,而这款美观又实用的国产监控,不仅部署简单(用运维术语来说,解压部署包--执行安装--访问web三部曲来完成一键部署),还能在自家虚拟机或企业内部初步体验。
费心整理一个免费版监控场景使用,原创不易,感谢支持!

中国智能体开发者社区,聚焦智能体与大模型开发,提供前沿资讯、实用工具链、开源项目及行业案例。通过技术沙龙、开发者大赛等活动,促进经验交流与协作,助力开发者快速构建创新智能应用。
更多推荐



 15
 0
- 0


 已为社区贡献2条内容

所有评论(0)