Langchain实现一个高级RAG!
Langchain实现一个高级RAG
一、前言
在前一篇文章中,我们介绍了如何基于 LangChain 构建的简单 RAG系统,通过文档加载、向量化、检索、注入提示词与大模型生成回答,完成了基本的问答流程。然而,在真实应用中,基于单一查询的向量检索存在一些召回不足、语义偏差的问题。为此,在本文中我们使用langchain来实现一个高级RAG系统,通过引入更复杂的组件和策略,提升召回质量和答案准确性。核心改进点如下:
- 多查询生成(Multi-Query Generation):将原始用户问题重写成多个不同视角的语义等价查询,从多个角度理解用户意图,提高召回的覆盖面。
- 多路召回(Multi-Path Retrieval):使用多个查询并行检索,获得多个候选文档集合,丰富上下文候选池。
- 排序融合(Reciprocal Rank Fusion):整合多个检索结果,提升排序稳定性和语义一致性,避免单一查询带来的偏差。
二、相关知识
2.1 高级RAG
高级RAG流程在基础 RAG 的检索 + 生成结构上进行了增强,核心在于通过“多查询 + 多结果融合”的策略,提高检索的全面性与答案准确性。具体流程是:
- 用户提出一个问题;
- 使用大模型对问题生成多个改写版本(多视角查询);
- 分别对每个改写后的问题进行检索,获取多个相关文档列表;
- 将这些文档结果使用排序融合算法进行合并,得出综合最优的上下文;
- 将融合后的上下文和原始问题输入大模型,生成最终回答。
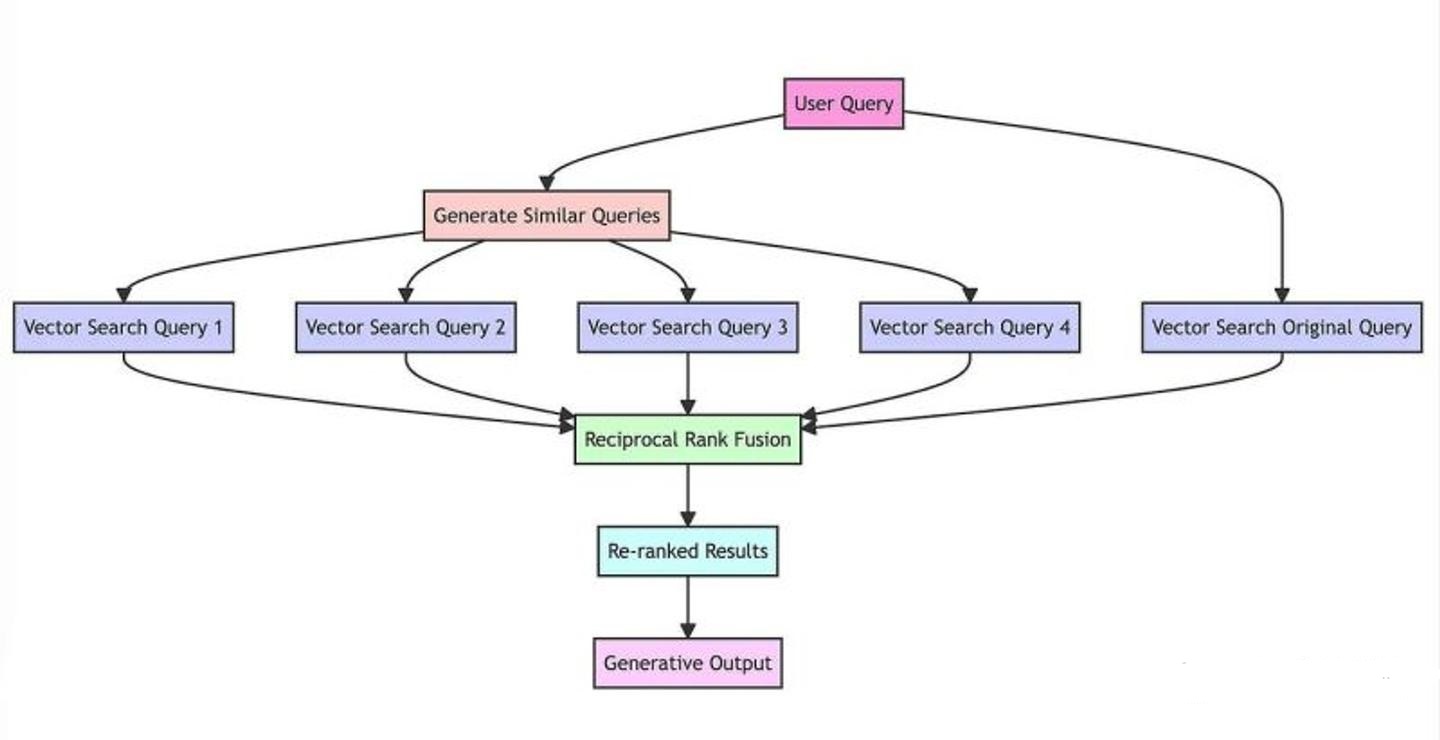
这样做的好处是:即使原问题表达不够准确,也能通过多个变体进行更全面的语义匹配,提高回答的可靠性。
2.2 排序融合算法(Reciprocal Rank Fusion, RRF)
排序融合算法的过程如下:
- 对每个改写查询的检索结果按相似度打分,生成多个文档排名列表;
- 对于每个文档,在每个列表中的排名位置越靠前,其得分越高;
- 所有排名得分按一定公式加权累加,得到一个综合得分;
- 按照这个最终得分重新排序,形成统一、融合后的结果列表。
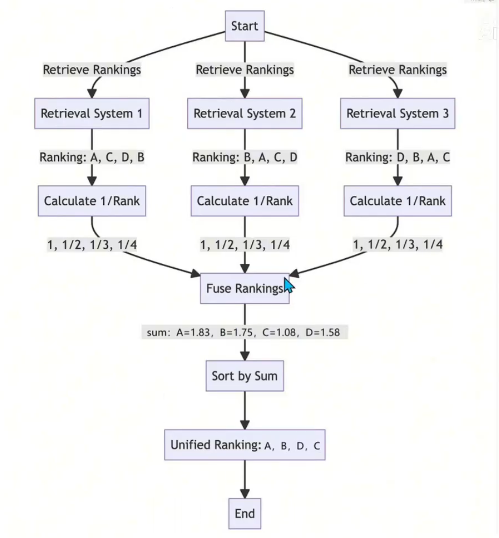
对每个文档,根据其在各个查询下的排名分数,计算加权和得到每个文档的最终打分:
Score
=
∑
q
∈
Q
1
k
+
rank
\text{Score} = \sum_{q \in Q} \frac{1}{k + \text{rank}}
Score=q∈Q∑k+rank1
- Q:查询集合
- rank:文档在某个查询下的排名(从 1 开始)
- k:一个平滑常数(通常设为 60)
排序融合结果能更好地代表多个语义路径下的综合相关性,非常适用于 RAG 系统中多视角信息融合的场景。
三、代码解析
3.1 文档预处理
def prepare_data():
    file_dir = Path('my_knowledge')
    text_loader_utf8 = partial(TextLoader, encoding='utf-8')
    documents = DirectoryLoader(str(file_dir), loader_cls=text_loader_utf8).load()
    text_splitter = RecursiveCharacterTextSplitter(chunk_size=500, chunk_overlap=100)
    chunks = text_splitter.split_documents(documents)
    # print("第一个文本块内容示例:\n", chunks[0].page_content)
    return chunks
加载本地知识库中的文本文件,并将其切分为更小的语义片段(chunk),为后续的向量化准备。通过设置合理的 chunk_size 和 chunk_overlap,可以在保证语义连贯性的同时提升检索覆盖率。
3.2 构建向量数据库
def embedding_data(chunks):
    # 使用 BAAI 的中文 embedding 模型
    rag_embeddings = HuggingFaceEmbeddings(model_name="BAAI/bge-small-zh-v1.5")
    persist_dir = "./chroma_advanced_db"

    if os.path.exists(os.path.join(persist_dir, "index")):
        # 向量库已存在,加载即可
        vector_store = Chroma(
            persist_directory=persist_dir,
            embedding_function=rag_embeddings
        )
    else:
        # 第一次运行,创建向量库
        vector_store = Chroma.from_documents(
            documents=chunks,
            embedding=rag_embeddings,
            persist_directory=persist_dir
        )

    retriever = vector_store.as_retriever()
    return vector_store, retriever
利用 BAAI 的中文嵌入模型对文本块进行向量化,并存储到 Chroma 本地向量数据库中。后续可以根据查询问题快速计算语义相似度,返回最相关的文本片段供模型使用。
3.3 多查询生成
def get_multiple_queries(question):
    template = """You are an AI language model assistant.
Your task is to generate five different versions of the given user question
to retrieve relevant documents from a vector database.
By generating multiple perspectives on the user question, your goal is to help
the user overcome some of the limitations of the distance-based similarity search.
Provide these alternative questions separated by newlines.

Original question: {question}"""

    prompt_perspectives = ChatPromptTemplate.from_template(template)

    generate_queries = (
            prompt_perspectives
            | llm
            | StrOutputParser()
            | (lambda x: x.split("\n"))
    )
    # 生成多个查询
    response = generate_queries.invoke({"question": question})
    print(response)

    all_results = retrieval_and_rank(response)
    reranked_results = reciprocal_rank_fusion(all_results)

    return generate_queries, reranked_results
针对用户问题,调用大模型生成多个改写版本,从不同视角增强语义覆盖,缓解单一表达带来的检索偏差。每个生成的问题都用于独立检索,提升文档召回的全面性。
3.4 多路召回与重排序
def retrieval_and_rank(queries):
    all_results = {}

    for query in queries:
        if query:
            search_results = vector_store.similarity_search_with_score(query)
            results = []
            for res in search_results:
                content = res[0].page_content
                score = res[1]
                results.append((content, score))
            all_results[query] = results

    document_ranks = []
    for query, doc_score_list in all_results.items():
        ranking_list = [doc for doc, _ in sorted(doc_score_list, key=lambda x: x[1], reverse=True)]
        document_ranks.append(ranking_list)

    return document_ranks
将多个查询结果进行检索,并按相似度得分排序后,生成每个查询对应的文档排名列表。为后续的排序融合做准备。
3.4 排序融合
def reciprocal_rank_fusion(document_ranks, k=60):
    fused_scores = {}

    for docs in document_ranks:
        for rank, doc in enumerate(docs):
            doc_str = dumps(doc)
            if doc_str not in fused_scores:
                fused_scores[doc_str] = 0
            fused_scores[doc_str] += 1 / (rank + k)

    reranked_results = [
        (json.loads(doc), score)
        for doc, score in sorted(fused_scores.items(), key=lambda x: x[1], reverse=True)
    ]
    return reranked_results
使用 Reciprocal Rank Fusion(RRF)算法对多个文档排序结果进行融合打分。该方法对不同查询下排名靠前的文档赋予更高权重,有效提升综合检索质量和鲁棒性。
3.5 生成回答
def multi_query_generate_answer(question):
    # 定义模板
    template = """Answer the following question based on this context:
    {context}
    Question: {question}
"""
    prompt = ChatPromptTemplate.from_template(template)

    retrieval_chain = generate_queries | retriever.map() | get_unique_union

    # 构造最终 RAG 链
    final_rag_chain = (
            {"context": retrieval_chain,
             "question": operator.itemgetter("question")}
            | prompt
            | llm
            | StrOutputParser()
    )

    # 执行调用,传入问题字典
    response = final_rag_chain.invoke({"question": question})
    print(response)
构建最终 RAG 链,将排序融合后的上下文输入大模型,结合用户问题生成答案。
3.6 主函数
if __name__ == "__main__":
    llm = OllamaLLM(model="qwen3:0.6b")
    # print(llm.invoke("你是谁?"))

    template = """您是问答任务的助理。
    使用以下检索到的上下文来回答问题。
    如果你不知道答案,就说你不知道。
    最多使用三句话,不超过100字,保持答案简洁
    {context}
    Question: {question}
    Answer:
"""
    prompt = ChatPromptTemplate.from_template(template)

    chunks = prepare_data()
    vector_store, retriever = embedding_data(chunks)

    query = "艾伦·图灵的论文叫什么"

    generate_queries, reranked_results = get_multiple_queries(query)
    # 多查询生成答案
    multi_query_generate_answer(query)
四、完整代码
以下是一个完整的 RAG 实现示例
import json
from functools import partial
from pathlib import Path
from langchain_ollama import OllamaLLM
from langchain_community.document_loaders import DirectoryLoader, TextLoader
from langchain.text_splitter import RecursiveCharacterTextSplitter
from langchain.prompts import ChatPromptTemplate
from langchain.schema.runnable import RunnablePassthrough
from langchain.schema.output_parser import StrOutputParser
from langchain_community.vectorstores import Chroma
from langchain_huggingface import HuggingFaceEmbeddings
from langchain.load import dumps, loads

import operator
import os


def prepare_data():
    file_dir = Path('my_knowledge')
    text_loader_utf8 = partial(TextLoader, encoding='utf-8')
    documents = DirectoryLoader(str(file_dir), loader_cls=text_loader_utf8).load()
    text_splitter = RecursiveCharacterTextSplitter(chunk_size=500, chunk_overlap=100)
    chunks = text_splitter.split_documents(documents)
    # print("第一个文本块内容示例:\n", chunks[0].page_content)
    return chunks


def embedding_data(chunks):
    # 使用 BAAI 的中文 embedding 模型
    rag_embeddings = HuggingFaceEmbeddings(model_name="BAAI/bge-small-zh-v1.5")
    persist_dir = "./chroma_advanced_db"

    if os.path.exists(os.path.join(persist_dir, "index")):
        # 向量库已存在,加载即可
        vector_store = Chroma(
            persist_directory=persist_dir,
            embedding_function=rag_embeddings
        )
    else:
        # 第一次运行,创建向量库
        vector_store = Chroma.from_documents(
            documents=chunks,
            embedding=rag_embeddings,
            persist_directory=persist_dir
        )

    retriever = vector_store.as_retriever()
    return vector_store, retriever


def get_multiple_queries(question):
    template = """You are an AI language model assistant.
Your task is to generate five different versions of the given user question
to retrieve relevant documents from a vector database.
By generating multiple perspectives on the user question, your goal is to help
the user overcome some of the limitations of the distance-based similarity search.
Provide these alternative questions separated by newlines.

Original question: {question}"""

    prompt_perspectives = ChatPromptTemplate.from_template(template)

    generate_queries = (
            prompt_perspectives
            | llm
            | StrOutputParser()
            | (lambda x: x.split("\n"))
    )
    # 生成多个查询
    response = generate_queries.invoke({"question": question})
    print(response)

    all_results = retrieval_and_rank(response)
    reranked_results = reciprocal_rank_fusion(all_results)

    return generate_queries, reranked_results


def get_unique_union(documents: list[list]):
    flattened_docs = [dumps(doc) for sublist in documents for doc in sublist]
    unique_docs = list(set(flattened_docs))
    return [json.loads(doc) for doc in unique_docs]


def generate_answer(question, retriever, prompt):
    # 创建RAG链(示例,具体实现可能需要根据你的框架调整)
    rag_chain = (
            {"context": retriever, "question": RunnablePassthrough()}
            | prompt
            | llm
            | StrOutputParser()
    )

    resp = rag_chain.invoke(question)
    print(resp)


def multi_query_generate_answer(question):
    # 定义模板
    template = """Answer the following question based on this context:
    {context}
    Question: {question}
"""
    prompt = ChatPromptTemplate.from_template(template)

    retrieval_chain = generate_queries | retriever.map() | get_unique_union

    # 构造最终 RAG 链
    final_rag_chain = (
            {"context": retrieval_chain,
             "question": operator.itemgetter("question")}
            | prompt
            | llm
            | StrOutputParser()
    )

    # 执行调用,传入问题字典
    response = final_rag_chain.invoke({"question": question})
    print(response)


def retrieval_and_rank(queries):
    all_results = {}

    for query in queries:
        if query:
            search_results = vector_store.similarity_search_with_score(query)
            results = []
            for res in search_results:
                content = res[0].page_content
                score = res[1]
                results.append((content, score))
            all_results[query] = results

    document_ranks = []
    for query, doc_score_list in all_results.items():
        ranking_list = [doc for doc, _ in sorted(doc_score_list, key=lambda x: x[1], reverse=True)]
        document_ranks.append(ranking_list)

    return document_ranks


def reciprocal_rank_fusion(document_ranks, k=60):
    fused_scores = {}

    for docs in document_ranks:
        for rank, doc in enumerate(docs):
            doc_str = dumps(doc)
            if doc_str not in fused_scores:
                fused_scores[doc_str] = 0
            fused_scores[doc_str] += 1 / (rank + k)

    reranked_results = [
        (json.loads(doc), score)
        for doc, score in sorted(fused_scores.items(), key=lambda x: x[1], reverse=True)
    ]
    return reranked_results


if __name__ == "__main__":
    llm = OllamaLLM(model="qwen3:0.6b")
    # print(llm.invoke("你是谁?"))

    template = """您是问答任务的助理。
    使用以下检索到的上下文来回答问题。
    如果你不知道答案,就说你不知道。
    最多使用三句话,不超过100字,保持答案简洁
    {context}
    Question: {question}
    Answer:
"""
    prompt = ChatPromptTemplate.from_template(template)

    chunks = prepare_data()
    vector_store, retriever = embedding_data(chunks)

    query = "艾伦·图灵的论文叫什么"

    generate_queries, reranked_results = get_multiple_queries(query)
    # 多查询生成答案
    multi_query_generate_answer(query)
五、总结
本文通过引入多查询生成、多路召回、重排序与融合排序等技术,在原有 RAG 架构基础上构建了一个更强健、精度更高的问答系统。相较于简单 RAG,它更适合应对复杂表达、模糊提问等场景,具备更强的实用性与拓展性,是构建企业级问答系统的重要方向。

中国智能体开发者社区,聚焦智能体与大模型开发,提供前沿资讯、实用工具链、开源项目及行业案例。通过技术沙龙、开发者大赛等活动,促进经验交流与协作,助力开发者快速构建创新智能应用。
更多推荐
 12
 0
- 0


 已为社区贡献2条内容

所有评论(0)