谷歌&谢塞宁创新研究:扩散模型的推理时Scaling
随着OpenAI o1等模型通过增加推理阶段计算量显著提升性能,扩散模型如何通过扩展推理时间的计算来优化性能成为亟待探索的领域。
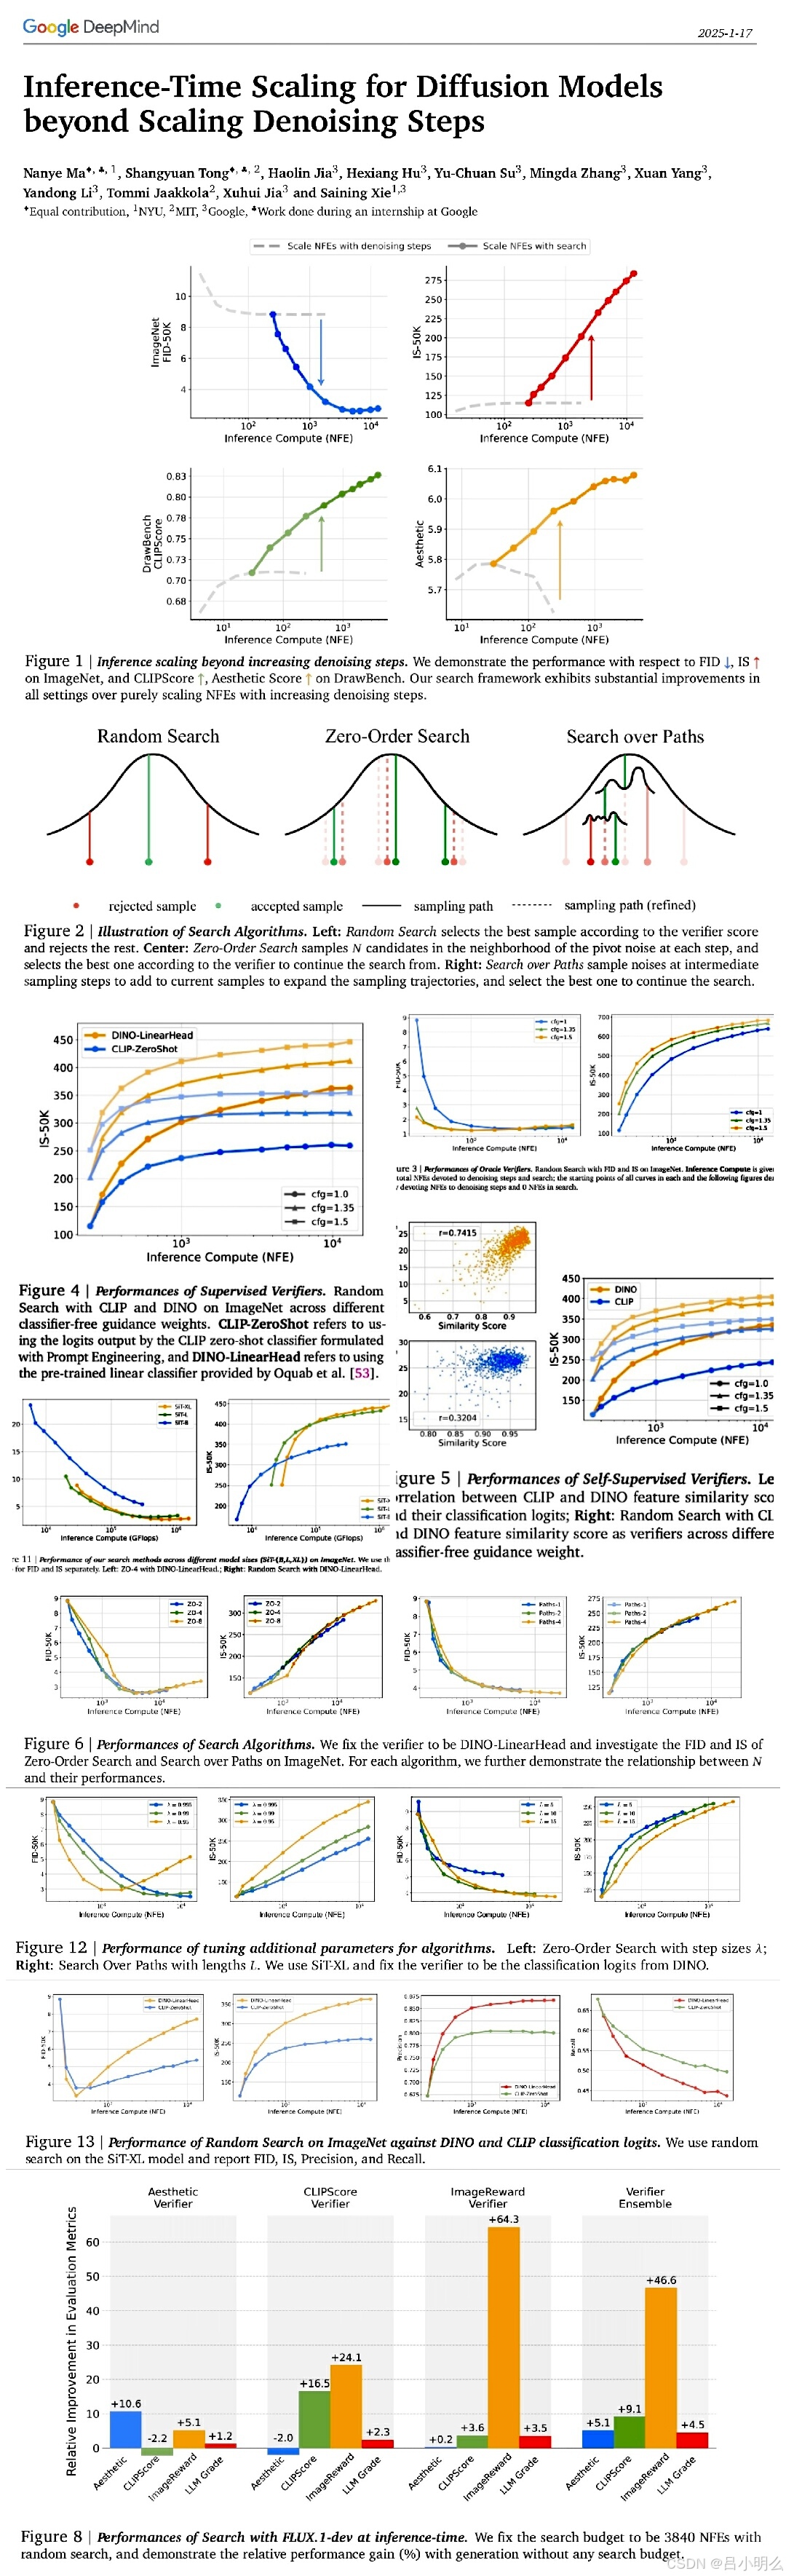
在生成模型中,函数评估次数(NFE)是衡量计算预算的关键指标,但增加去噪步骤的计算投入后,模型性能往往会在某个NFE阈值后趋于稳定,限制了计算增益。因此,以往研究多聚焦于减少NFE以提高效率。
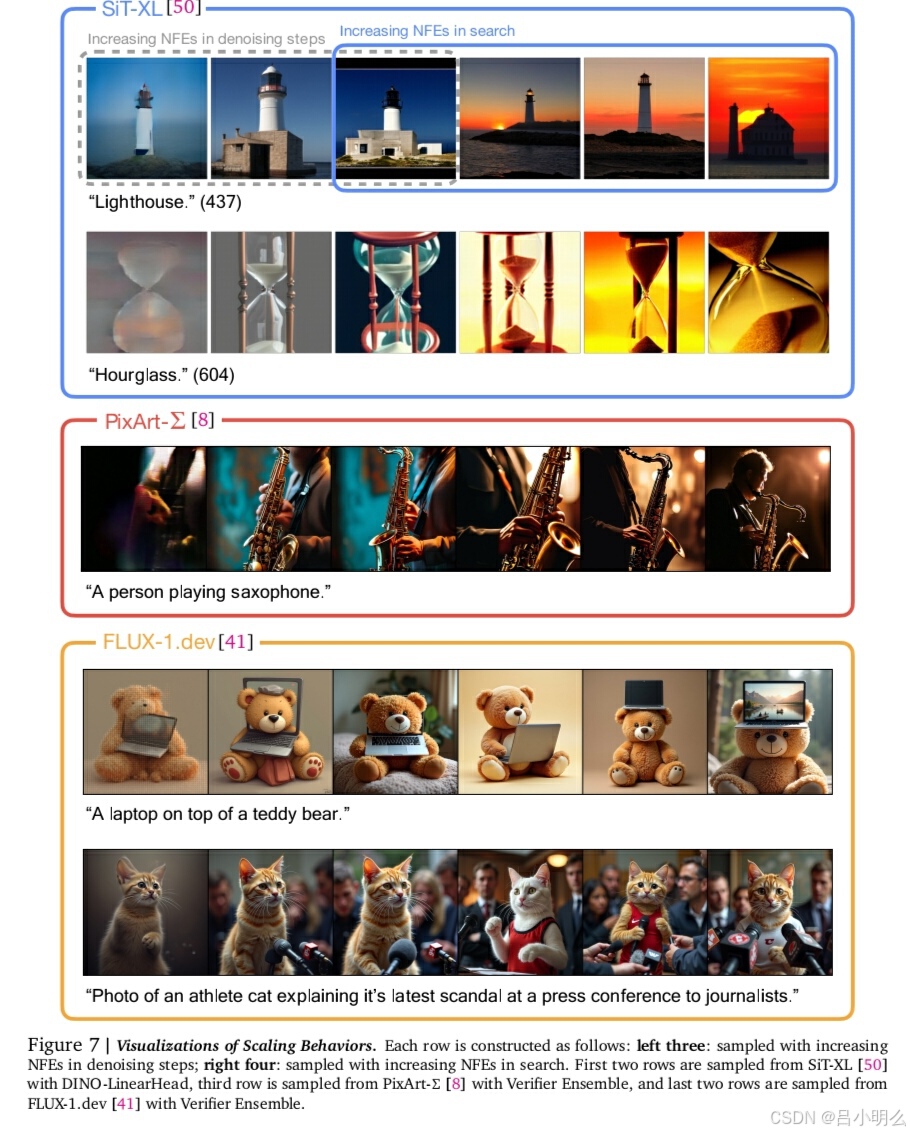
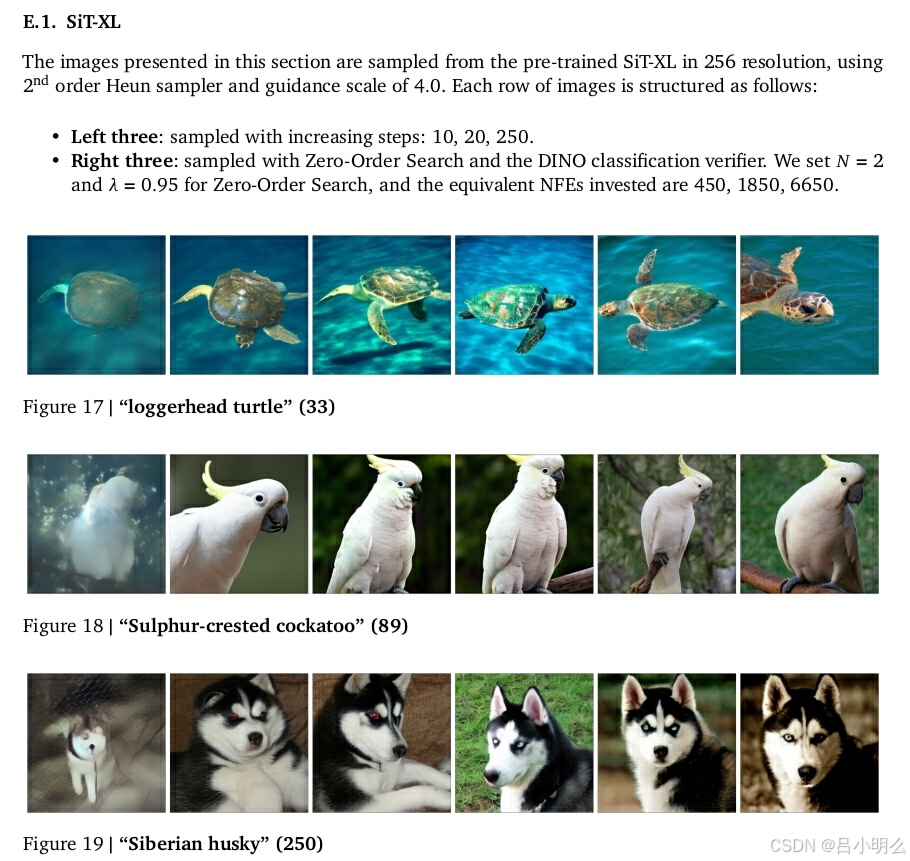
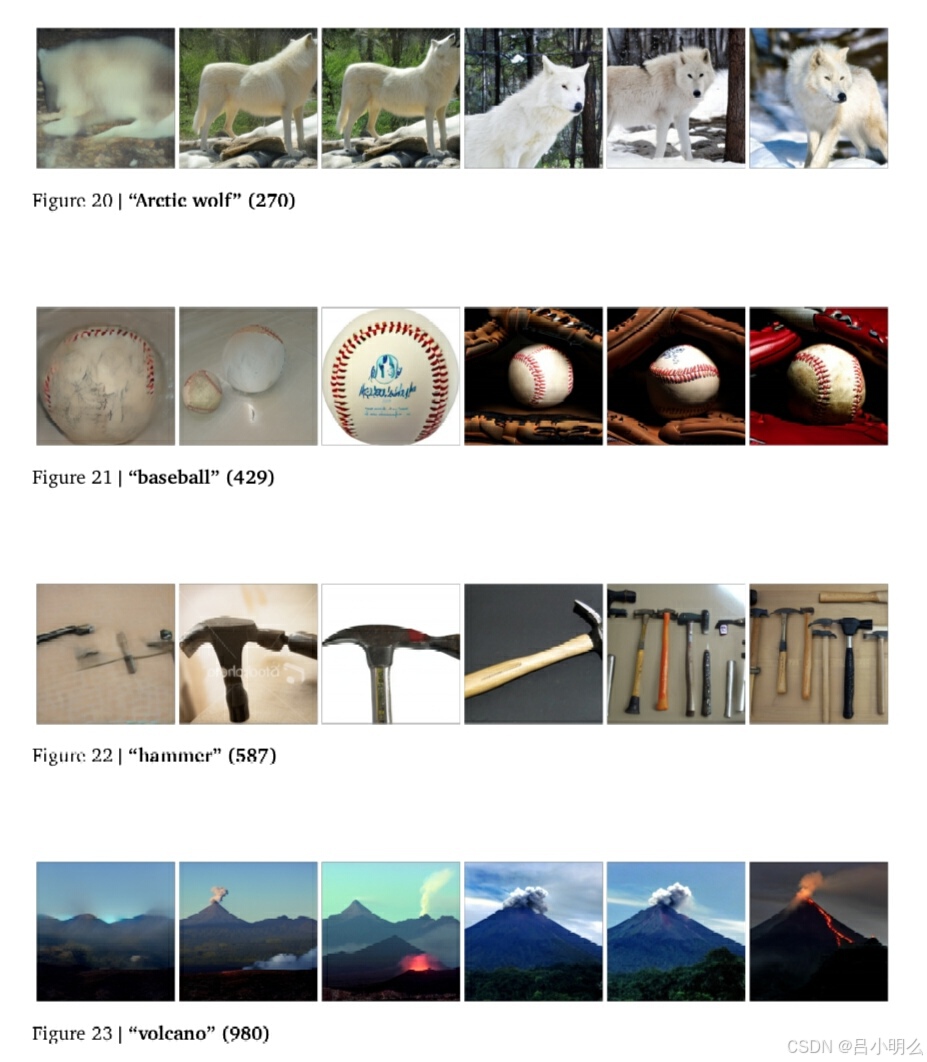
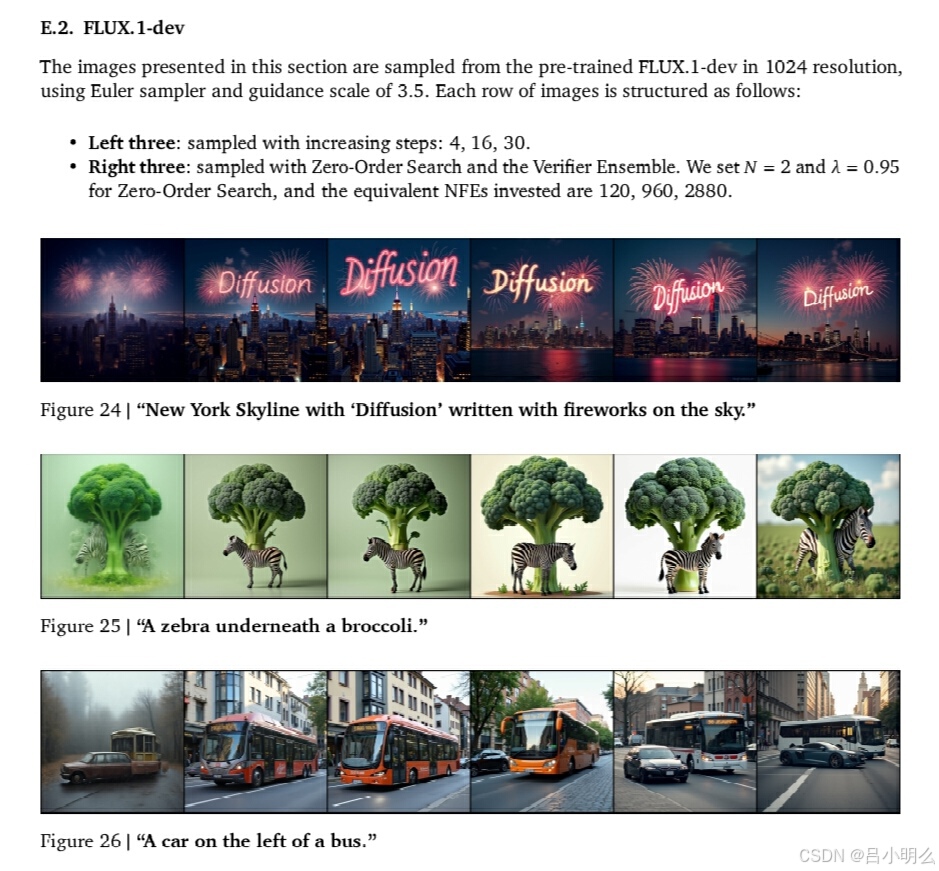
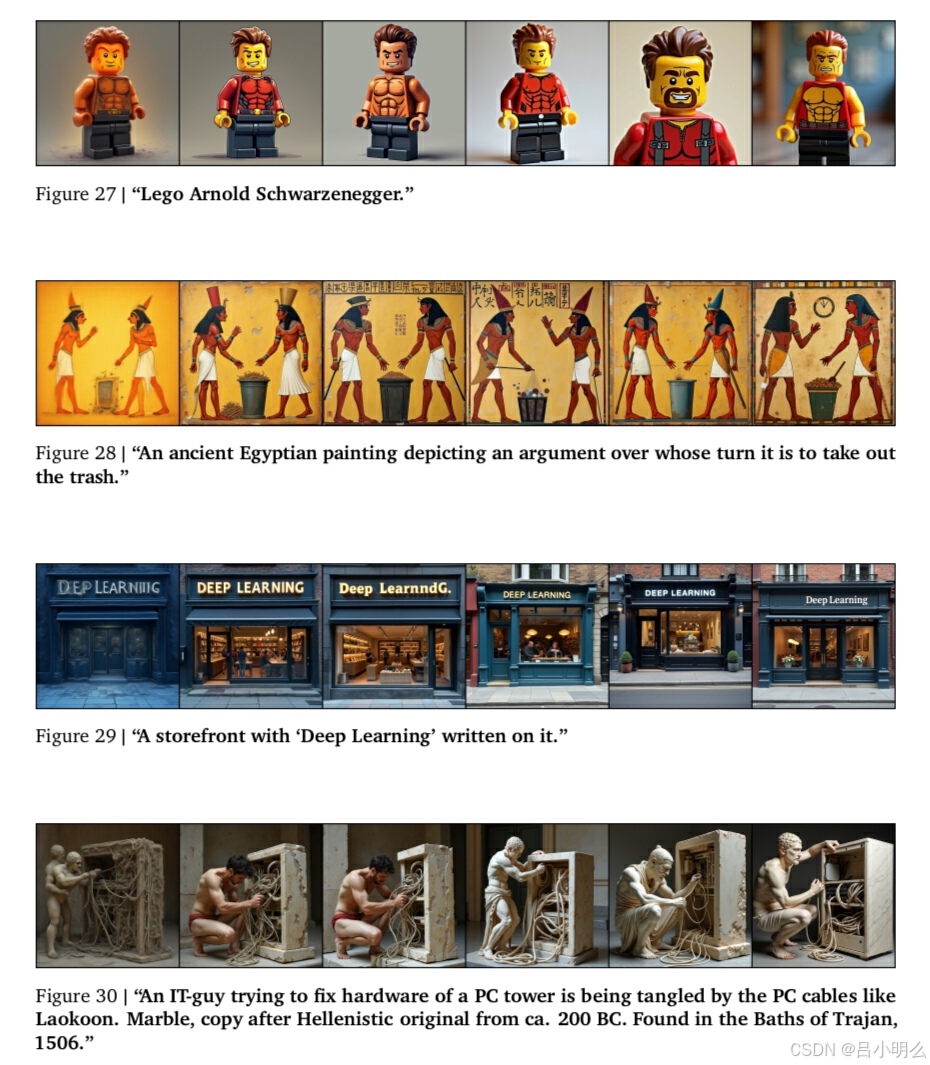
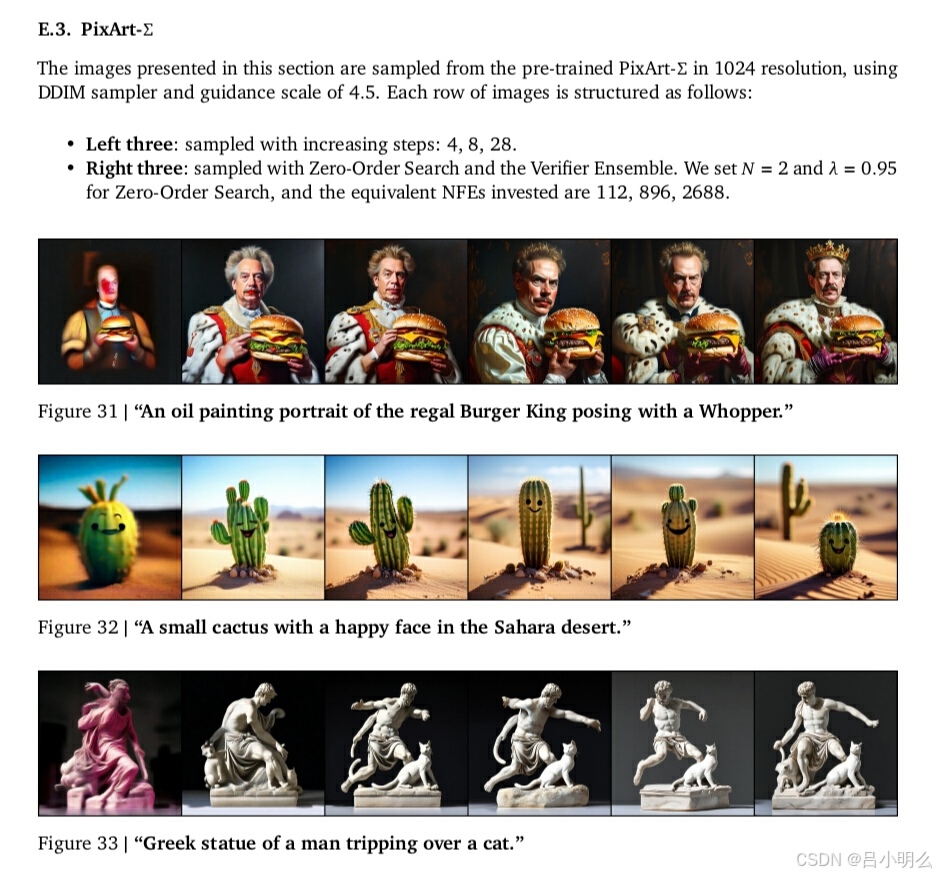
然而,谷歌DeepMind及谢赛宁等人的最新研究提出了新视角,指出扩散模型处理的显式随机性(即初始样本或采样过程中的噪声)对生成效果有显著影响,且噪声间不等价。这一发现为NFE扩展提供了新方向:在采样过程中搜索更优噪声。
论文聚焦于如何在推理过程中有效利用计算资源,而非单纯增加去噪步骤的NFE。作者深入探讨了验证器和算法两个核心设计,用于在搜索过程中提供反馈和寻找更优噪声候选项。研究发现,无普遍最优配置,验证器与生成任务间的匹配度差异显著,需针对特定任务设计验证器。
在验证器设置上,作者考虑了三种场景:掌握最终评估信息、掌握条件信息、无额外信息。搜索算法则包括随机搜索、零阶搜索和路径搜索,其中后两者利用验证器反馈迭代改进噪声候选项或采样轨迹。这里值得注意的是,图像空间不同于语言空间,图像空间的无约束搜索空间加速了随机搜索向验证器偏见的收敛,类似强化学习中的奖励黑客行为,称为“验证器黑客”。因此,研究者采用更细致的搜索算法(零阶和路径搜索),逐步优化候选样本,减轻过拟合风险。
此外,研究发现验证器无需条件信息即可有效指导搜索,如DINO/CLIP分类器输出的logits与模型在低噪声水平下的预测值与最终生成样本间的特征空间余弦相似度强相关。这对于条件信息不可用或难以获取的用例具有重要意义。
实验还探讨了不同维度上推理计算投入的效果,发现调整每次搜索迭代中的去噪步骤数量可揭示不同计算最优区域。较小NFEs/iter实现高效收敛但性能较低,而较大NFEs/iter收敛慢但性能更优,进一步印证了test-time compute下的扩展定律。
然而,对于“搜索”构噪与迭代去噪的说法,个人持保留态度,因基于图像的扩散与语言符号形式搜索在底层形式化上可能存在差异,也许需谨慎对待并深入探索其潜在联系和差异,其并不能完全将图像生成过程的扩散与符号形式的搜索直接对应起来,它们也许在底层形式化上是相同的,但其之间也许会存在着一些过程或优化起点上的差异。

中国智能体开发者社区,聚焦智能体与大模型开发,提供前沿资讯、实用工具链、开源项目及行业案例。通过技术沙龙、开发者大赛等活动,促进经验交流与协作,助力开发者快速构建创新智能应用。
更多推荐



 4
 0
- 0


 已为社区贡献1条内容

所有评论(0)