GPU内存都炸了:funASR解析短视频的语音失败,都怪那些用肮脏技术手段改造视频逃避平台检测的无良搬运者
最近我在用 FunASR + SenseVoiceSmall 模型 把某音短视频的语音转换为文本时,遇到了一种极度恶心的现象——某些看似“短视频”,时长只有10~20分钟左右,结果在解析语音阶段竟然直接把GPU炸了。
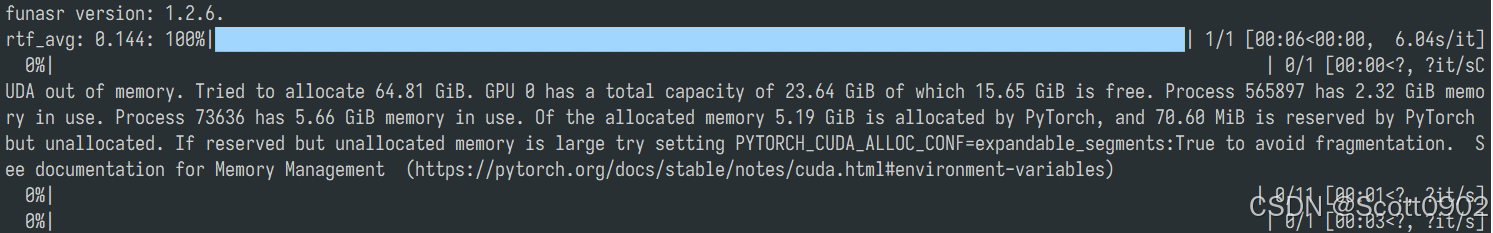
CUDA out of memory.
Tried to allocate 64.81 GiB.
GPU 0 has a total capacity of 23.64 GiB of which 15.65 GiB is free.
Process 565897 has 2.32 GiB memory in use.
Process 73636 has 5.66 GiB memory in use.
Of the allocated memory 5.19 GiB is allocated by PyTorch,
and 70.60 MiB is reserved by PyTorch but unallocated.
If reserved but unallocated memory is large try setting
PYTORCH_CUDA_ALLOC_CONF=expandable_segments:True
to avoid fragmentation.
See documentation for Memory Management
(https://pytorch.org/docs/stable/notes/cuda.html#environment-variables)
模型提示:“CUDA无法分配65GB显存”。
你没看错,65GB显存!
即使我按照提示修改了 PYTORCH_CUDA_ALLOC_CONF=expandable_segments 仍然无济于事。
平时超过一小时的长视频都能正常解析语音,可是这短短十几分钟的视频何德何能可以撑爆一张24GB的显卡的显存?这些“视频垃圾”用了什么妖术把显卡直接拖进深渊?
更可怕的是,如果放到没有GPU、仅靠CPU运算的机器上,这类视频甚至能直接把整台机器卡死,内存与Swap全被吃光,系统瘫痪,无法动弹。
一、问题的技术现象
表面上这些视频长度10~20多分钟,但我仔细分析后发现:
真正有有效语音内容的部分只有十几秒。
剩下的时间段,要么播放器无法拖动、无法播放,要么一直卡在加载中。更离谱的是,有的甚至在视频头尾插上几帧花屏、空白帧或无意义的噪声段落,用肉眼几乎察觉不到,却能让解码器、语音识别模型陷入疯狂计算。
在执行 funasr 的语音解析流程时,这类视频的音频流会被错误地识别为一条“巨型长音频”。模型尝试提取声学特征(MFCC等),卷积层和注意力机制会生成大量特征矩阵,GPU内存呈指数级增长,最终炸裂。
二、技术分析:这是如何被“恶意制造”的?
经过多次验证,我可以断定这些视频是被人为篡改或伪造的。很多短视频博主为了传播视频、未经他人许可而散播,又担心被视频平台检测到视频与他人作品太相似,坊间有不少给短视频添油加醋的小工具从而逃避平台的检测,常见的“手段”包括:
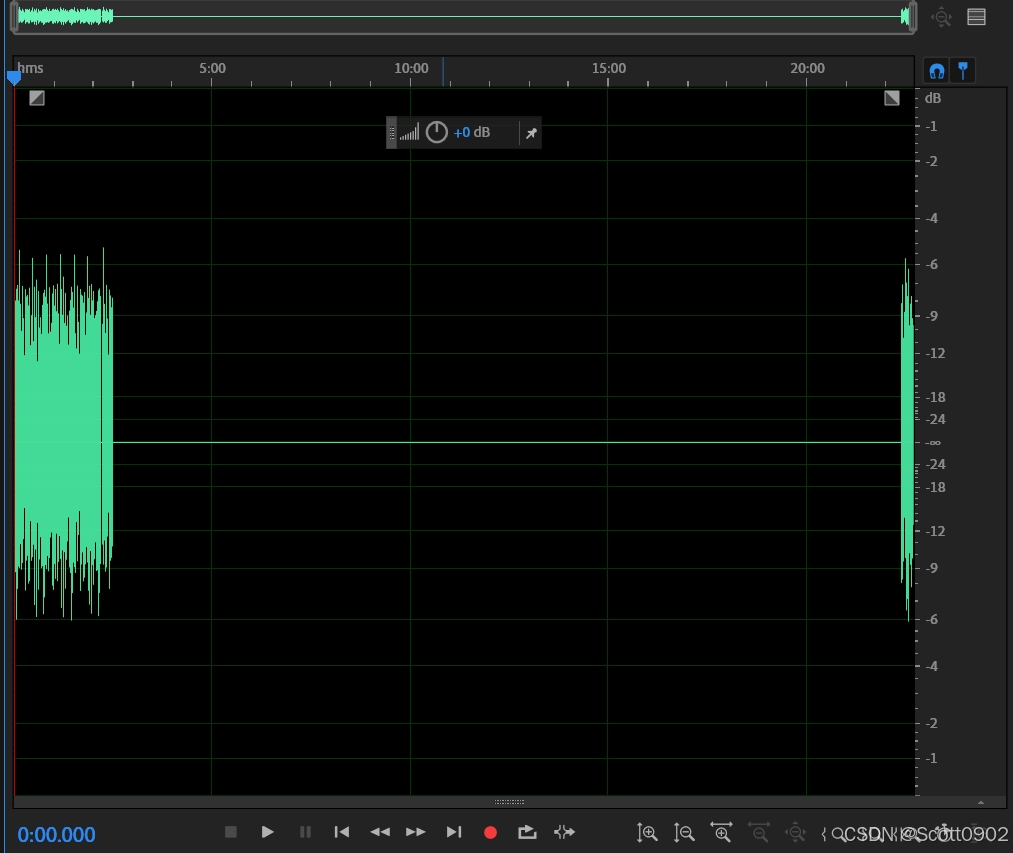
- 拉长时长:使用简单的视频编辑工具,在视频末尾或首尾插入大量空帧或静态帧,让视频看起来像“长达20分钟”。
-
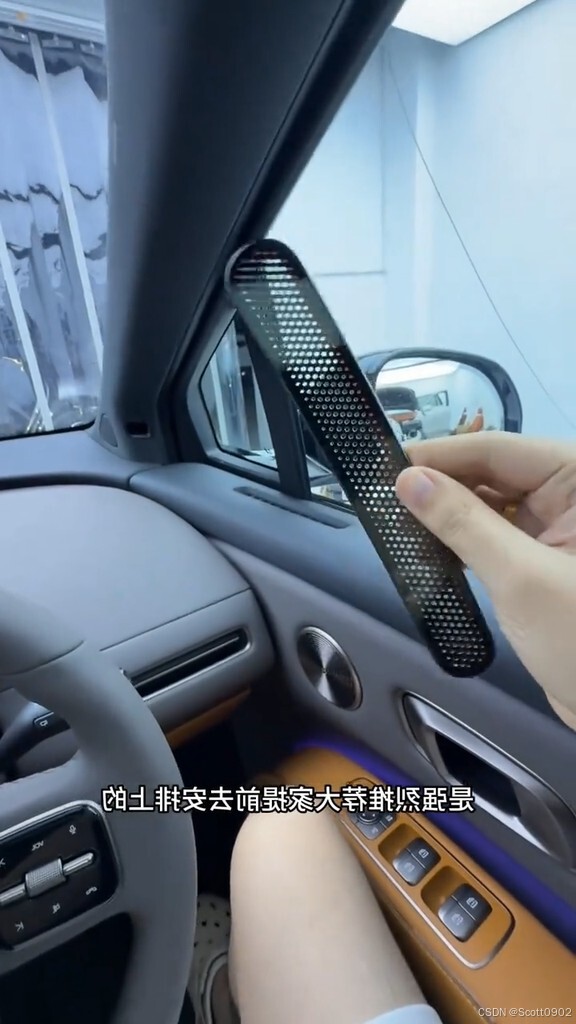
水平翻转:将画面镜像反转,以规避内容相似度检测算法。
-
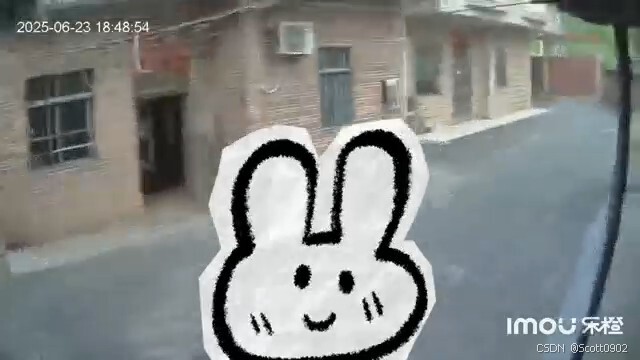
添加伪水印或小图标:在角落随意放个图标,试图蒙混过“原创检测系统”。
-
修改视频元数据:通过篡改容器层(如MP4封装中的duration字段),让播放器显示的时长与实际帧数不符。
-
插入噪音或无效音频:在音频流中掺杂无意义数据,让自动识别模型陷入高负载状态。
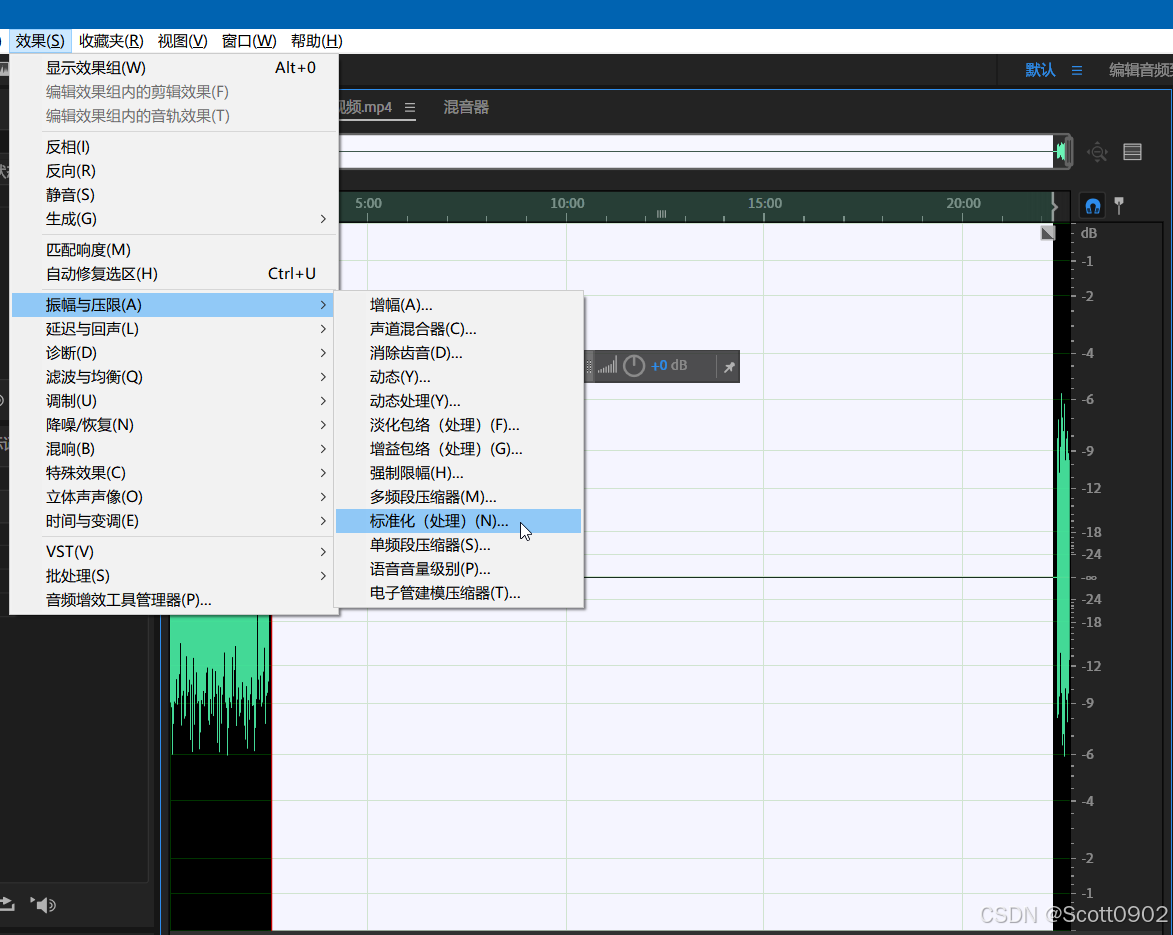
以上面第一点的视频为例,用 Adobe Audition 打开,表面上有一大段空白无声音频,如果人工把它剪掉,另存一个 wav 文件,那么 funASR 能够正常解析为文本(废话!)。但是一个正常空白无声的音频,是不足以 funASR 干爆显存的,我们推断这种垃圾视频的“无声”视频应该是被做了手脚。此时在 Adobe Audition 选取无声音频的部分(记住,不是全选),点击“效果”——“振幅与压限”——标准化处理(如下图),在对话框的数值里填100:
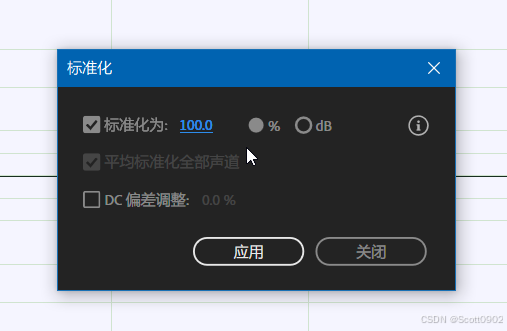
点击“应用”,“无声”片段被暴力拉满,还原出一大截“爆咪”的音频,按 Shift + D 查看波谱——全是8.5k~20kHz的高频噪音!那画面太美,我不敢看。
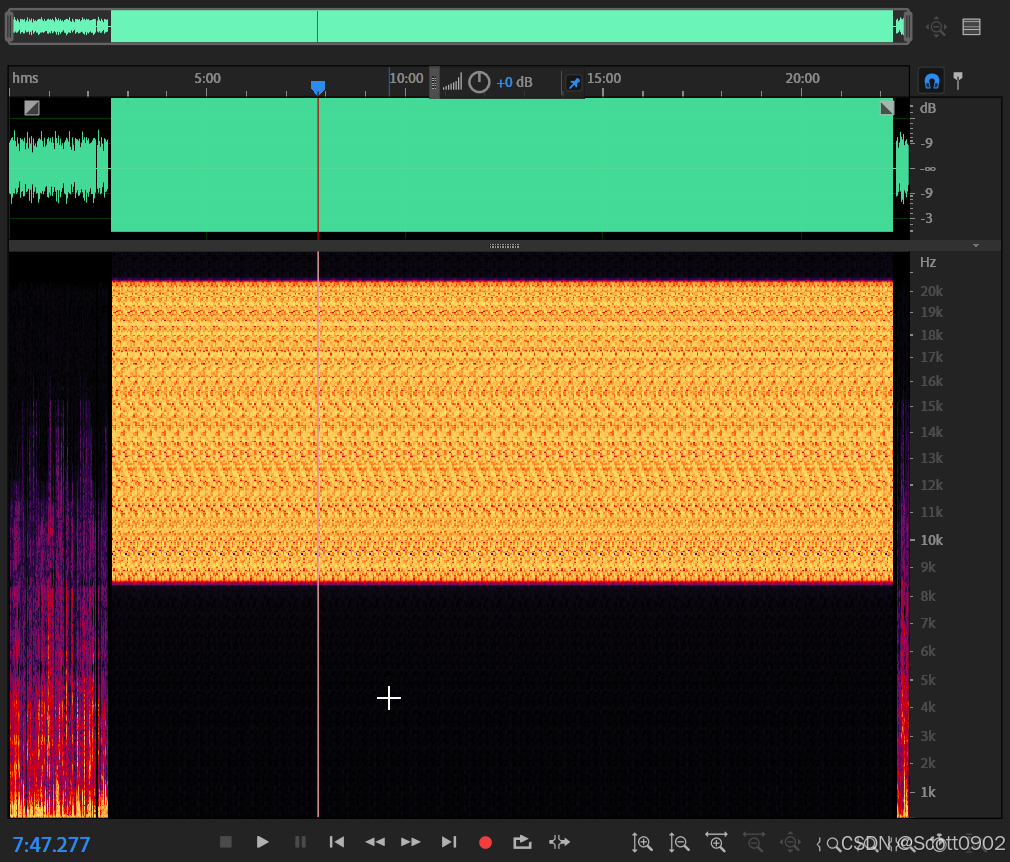
正是这些高能的噪音,使得 funASR 在预处理 / 特征提取阶段(特别是带卷积/注意力的模型)产生异常大的频谱矩阵或数值,从而干爆显存/内存!
这些做法表面看是“技术手段”,但本质上是一种技术滥用与欺骗行为。
三、这些视频的本质:技术污染与计算浪费
在视频平台的生态里,这类视频不仅仅是“抄袭作品”。
它们已经演变成一种系统性污染:
- 浪费计算资源:每一次分析或识别这样的伪视频,都是GPU/CPU的灾难。
- 浪费存储空间:数以百万计的无效帧在OSS或CDN上白白占用TB级空间。
- 污染算法训练集:如果这些视频混入语音识别或推荐算法的数据集中,将极大干扰模型判断。
- 误导用户体验:普通用户拖动进度条,只会看到播放卡死、黑屏或杂音。
这不是“创作”,而是赤裸裸的技术垃圾制造行为。
它们让真正的内容创作者被掩埋在数据噪音中,让平台算法背上不必要的计算负担,更让技术工作者徒劳无功地调试、优化、排错。
四、对“伪原创”视频制作者的愤慨
我想说一句很不客气的话:
你不是在创作,你是在浪费全社会的算力。
靠反转画面、填充空白帧、篡改时长来骗过系统检测,不仅体现了低劣的职业素养,更暴露了对技术和他人劳动的极度不尊重。
真正的技术人,是用技术让世界更高效、更美好;而你们,是在用技术制造障碍,让算法、设备、乃至整个网络生态背锅。
这些“搬运+伪原创”的行为,本质上与恶意软件没有区别。
前者污染用户体验,后者污染算力资源——性质一样恶劣。
五、结语:技术人的底线
作为程序员,我尊重一切创造性的技术手段,但前提是——它服务于效率与公平,而不是欺骗与浪费。
希望各大平台能在反抄袭检测之外,增加一种“视频有效性检测”机制,例如:
- 检测视频中有效帧的比例;
- 识别无效音频段落;
- 自动标注“异常封装”视频。
只有这样,才能让真正有价值的内容被看见,让恶意制造的数据垃圾失去立足之地。
我愿意把GPU的每一块显存、CPU的每一个核心,奉献给有意义的计算。
但绝不会再浪费在这些被伪装成原创的视频垃圾上。
——技术可以被利用,但绝不该被滥用。

中国智能体开发者社区,聚焦智能体与大模型开发,提供前沿资讯、实用工具链、开源项目及行业案例。通过技术沙龙、开发者大赛等活动,促进经验交流与协作,助力开发者快速构建创新智能应用。
更多推荐



 8
 0
- 0


 已为社区贡献1条内容

所有评论(0)