【RAG全栈课程】Task02:数据准备
前言
检索增强生成(RAG)的性能在很大程度上取决于其检索模块的质量,而文本分块(Chunking)是决定检索质量的关键前置步骤。粗暴或不恰当的分块会导致信息丢失、上下文割裂、检索效率低下等问题,严重影响 RAG 系统的最终表现。值得注意的是,高质量的分块策略必须建立在合理、高效的数据加载基础之上“垃圾进,垃圾出(Garbage In, Garbage Out)” ——高质量输入是高质量输出的前提。
因此,选择和设计合适的数据加载方式与文本分块策略是构建RAG流程的关键步骤。它们如同建房子时候的地基,地基不稳地动山摇,会直接影响到LLM(大语言模型)理解能力与生成质量。本文将系统梳理了数据加载和文本分块策略、实现与优化,助你告别粗暴的切分,为你的 RAG 系统打下坚实、可靠的基础。
一、数据加载
1. 文档加载器
核心功能:将各种格式的原始文档内容读取并转换为统一的、结构化的文本格式(通常是纯文本或带有元数据的文档对象),供后续的分块(Chunking)、嵌入(Embedding)和检索(Retrieval)使用。
-
支持多种文件格式:能处理PDF、Word、PPT、Excel、TXT、HTML、Markdown、JSON、CSV 等常见文档类型。
-
提取纯文本内容:剥离格式、排版、图像(除非特别支持 OCR)等非文本信息,只保留语义相关的文字内容。
-
保留元数据(Metadata):保留文件名、URL、作者、创建时间、页码、章节标题等,用于后续过滤或增强检索。
-
输出标准化文档对象:通常返回统一的数据结构,如 LangChain 中的Document(page_content="...", metadata={...}),便于后续模块处理。
-
处理特殊内容(部分高级加载器):能提取表格结构(Unstructured、LlamaParse)、处理扫描版 PDF(OCR)、解析代码仓库(GitHubRepoLoader)
当前主流RAG文档加载器:
| 工具名称 | 特点 | 适用场景 | 性能表现 |
|---|---|---|---|
| PyMuPDF4LLM | PDF→Markdown转换,OCR+表格识别 | 科研文献、技术手册 | 开源免费,GPU加速 |
| TextLoader | 基础文本文件加载 | 纯文本处理 | 轻量高效 |
| DirectoryLoader | 批量目录文件处理 | 混合格式文档库 | 支持多格式扩展 |
| Unstructured | 多格式文档解析 | PDF、Word、HTML等 | 统一接口,智能解析 |
| FireCrawlLoader | 网页内容抓取 | 在线文档、新闻 | 实时内容获取 |
| LlamaParse | 深度PDF结构解析 | 法律合同、学术论文 | 解析精度高,商业API |
| Docling | 模块化企业级解析 | 企业合同、报告 | IBM生态兼容 |
| Marker | PDF→Markdown,GPU加速 | 科研文献、书籍 | 专注PDF转换 |
| MinerU | 多模态集成解析 | 学术文献、财务报表 | 集成LayoutLMv3+YOLOv8 |
2. Unstructured文档处理库
Unstructured 是一个专业的文档处理库,专门设计用于RAG和AI微调场景的非结构化数据预处理。提供了统一的接口来处理多种文档格式,是目前应用较广泛的文档加载解决方案之一。
核心优势:
-
广泛的格式支持:原生支持PDF、Word、PPT、Excel、TXT、HTML、Markdown、JSON、CSV 等数十种格式。
-
智能内容解析:不仅提取文本,还能识别文档结构(如标题、段落、列表、表格、代码块),并保留语义层级信息。
-
与主流框架深度集成:官方提供 LangChain、LlamaIndex 等 RAG 框架的加载器,开箱即用。
-
可扩展性与云原生支持:支持本地部署或通过的 Unstructured.io 提供的托管 API 服务。
Unstructured能够识别和分类以下文档元素:
| 元素类型 | 描述 |
|---|---|
Title | 文档标题 |
NarrativeText | 由多个完整句子组成的正文文本,不包括标题、页眉、页脚和说明文字 |
ListItem | 列表项,属于列表的正文文本元素 |
Table | 表格 |
Image | 图像元数据 |
Formula | 公式 |
Address | 物理地址 |
EmailAddress | 邮箱地址 |
FigureCaption | 图片标题/说明文字 |
Header | 文档页眉 |
Footer | 文档页脚 |
CodeSnippet | 代码片段 |
PageBreak | 页面分隔符 |
PageNumber | 页码 |
UncategorizedText | 未分类的自由文本 |
CompositeElement | 分块处理时产生的复合元素(由一个或多个连续的文本元素组合而成) |
3. 从LangChain封装到原始Unstructured
在第一章的示例中,我们使用了LangChain的UnstructuredMarkdownLoader,它是LangChain对Unstructured库的封装。接下来我们通过直接使用Unstructured库,以获得更大的灵活性和控制力。
第一步:环境配置
(1)、下载并解压poppler,在“系统环境变量中”添加如下内容(注意:需要改成自己的路径)
C:\Users\woyych\Desktop\all-in-rag\poppler-25.07.0\Library\bin(2)、下载并安装Tesseract,在“系统环境变量中”添加如下内容(注意:需要改成自己的路径)
C:\Program Files\Tesseract-OCR(3)、下载chi_sim.traineddata中文包,放入以下目录下(注意:此为安装的默认目录。若安装到其他路径需改成自己的路径)
C:\Program Files\Tesseract-OCR\tessdata第二步:更改代码
01_unstructured_example(partition_pdf).py:
from unstructured.partition.pdf import partition_pdf
import warnings
import logging

# 屏蔽特定的警告信息
warnings.filterwarnings("ignore", message=".*Could get FontBBox from font descriptor.*")
warnings.filterwarnings("ignore", message=".*cannot be parsed as 4 floats.*")
warnings.filterwarnings("ignore", message=".*gray.*invalid float value.*")

# 设置日志级别以减少其他警告信息
logging.getLogger("unstructured").setLevel(logging.ERROR)
logging.getLogger("pdfminer").setLevel(logging.ERROR)
logging.getLogger("urllib3").setLevel(logging.ERROR)

# PDF文件路径
pdf_path = "../../data/C2/pdf/rag.pdf"

# 使用hi_res/ocr_only加载并解析PDF文档
elements = partition_pdf(
    filename=pdf_path,
    strategy="hi_res",    # 可改成"ocr_only"
    content_type="application/pdf",
    languages=["chi_sim", "eng"],
)

# 打印解析结果
print(f"解析完成: {len(elements)} 个元素, {sum(len(str(e)) for e in elements)} 字符")

# 统计元素类型
from collections import Counter
types = Counter(e.category for e in elements)
print(f"元素类型: {dict(types)}")

# 显示所有元素
print("\n所有元素:")
for i, element in enumerate(elements, 1):
    print(f"Element {i} ({element.category}):")
    print(element)
print("=" * 60)第三步:运行程序(需科学上网)
在使用"hi_res"方式时,可能会遇到如下报错:

这是由于程序在尝试从 Hugging Face 下载 YOLOX 布局分析模型(yolox_l0.05.onnx)时,因网络连接超时失败。这通常是因为 Hugging Face 在中国大陆访问受限。因此,需要科学上网解决该问题。
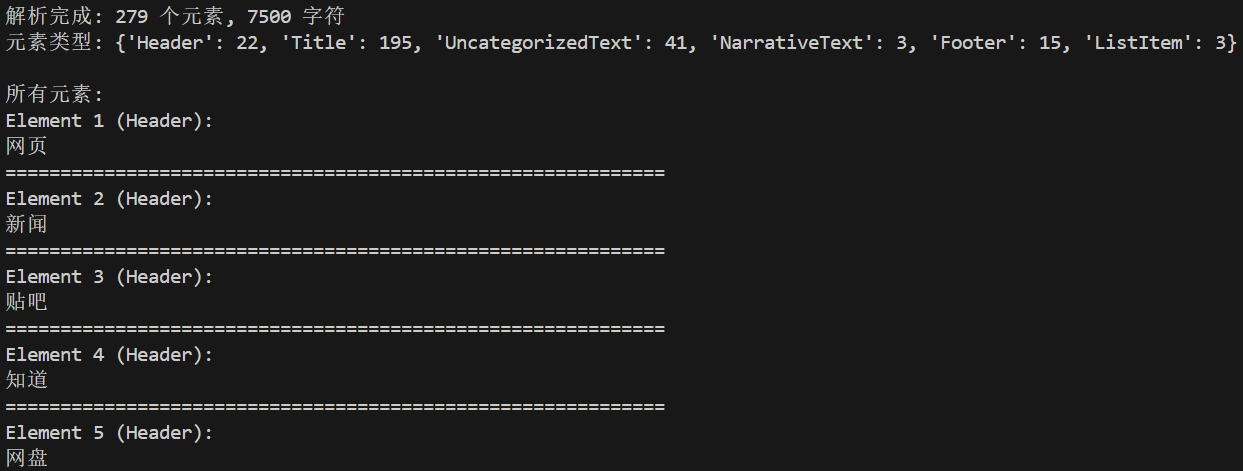
(1)、01_unstructured_example.py运行结果:
(2)、01_unstructured_example(partition_pdf).py运行结果:
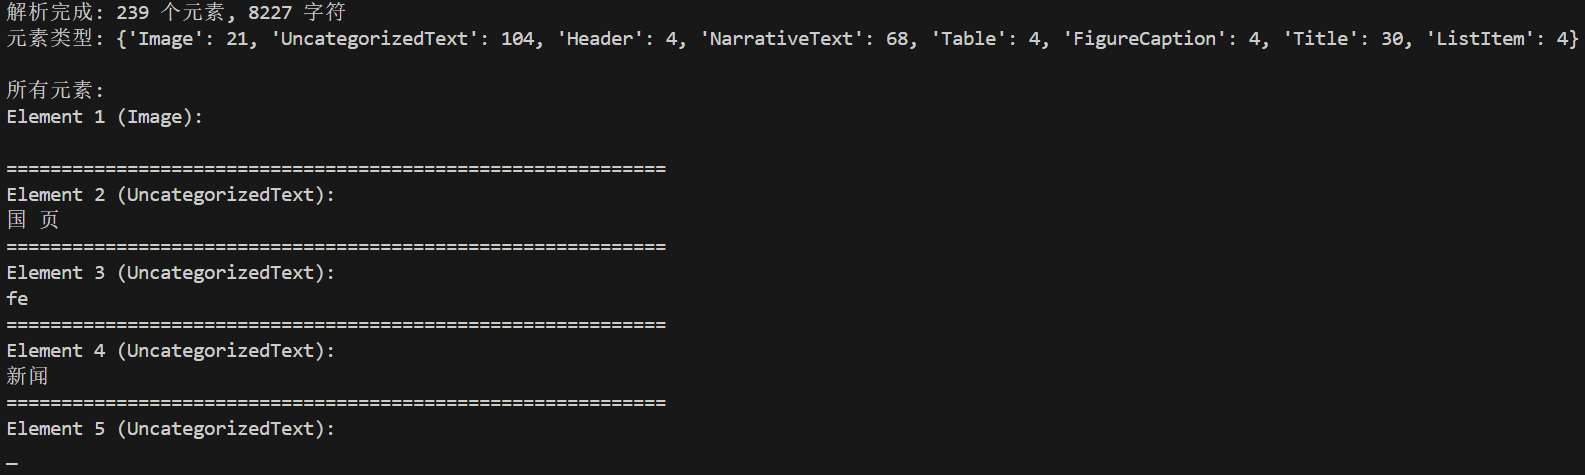
(i)hi_res:
(ii)ocr_only运行结果:
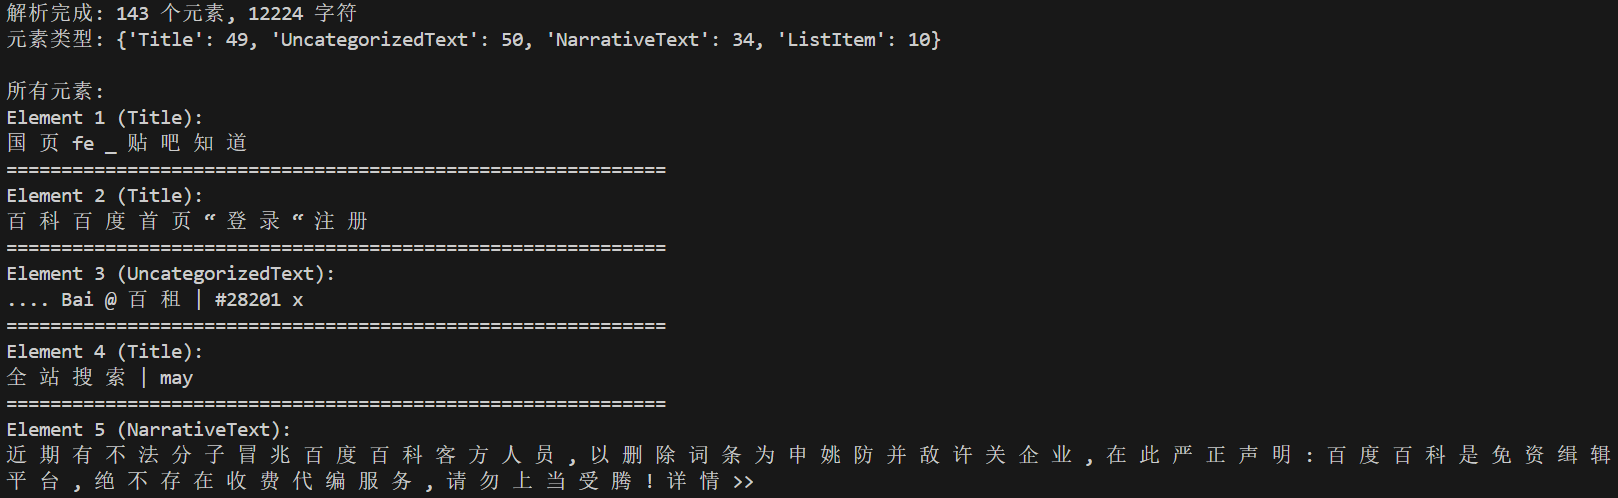
经对比hi_res和ocr_only方法,发现ocr_only方法会出现如下乱码(结构混乱)的情况:
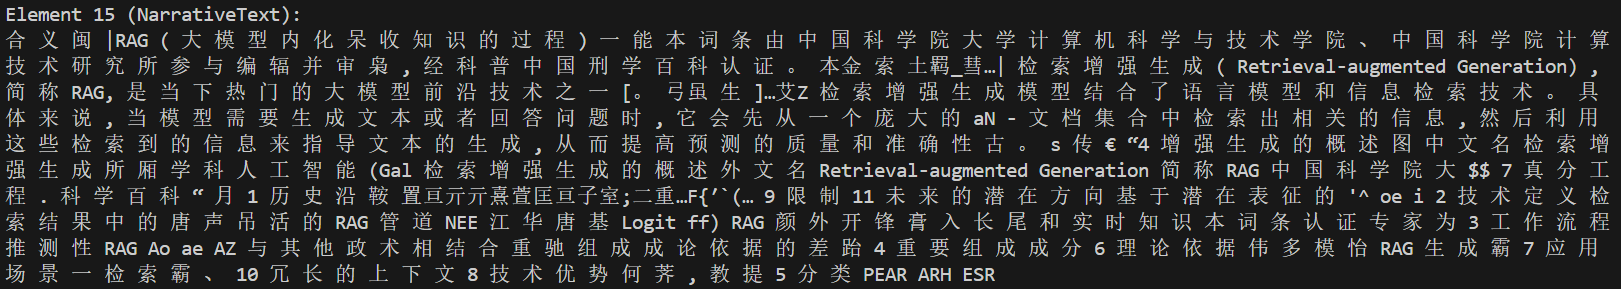
hi_res方法之所以效果更好,是因为它使用了“YOLOX 布局检测模型”来理解文档结构,而ocr_only方法跳过了布局分析,直接对整页图像做 OCR,容易导致文本顺序错乱或识别质量下降。
Extra:无需配置环境(懒人必备)
通过fast方法只使用pdfminer.six库从PDF中提取已有的文本内容,不进行任何 OCR、不分析布局、不转换图像,因此速度最快。
(1)、01_unstructured_example(fast).py:
from unstructured.partition.pdf import partition_pdf
import warnings
import logging

# 屏蔽特定的警告信息
warnings.filterwarnings("ignore", message=".*Could get FontBBox from font descriptor.*")
warnings.filterwarnings("ignore", message=".*cannot be parsed as 4 floats.*")
warnings.filterwarnings("ignore", message=".*gray.*invalid float value.*")

# 设置日志级别以减少其他警告信息
logging.getLogger("unstructured").setLevel(logging.ERROR)
logging.getLogger("pdfminer").setLevel(logging.ERROR)
logging.getLogger("urllib3").setLevel(logging.ERROR)

# PDF文件路径
pdf_path = "../../data/C2/pdf/rag.pdf"

# 使用fast加载并解析PDF文档
elements = partition_pdf(
    filename=pdf_path,
    strategy="fast",
    content_type="application/pdf",
    languages=["chi_sim", "eng"],
)

# 打印解析结果
print(f"解析完成: {len(elements)} 个元素, {sum(len(str(e)) for e in elements)} 字符")

# 统计元素类型
from collections import Counter
types = Counter(e.category for e in elements)
print(f"元素类型: {dict(types)}")

# 显示所有元素
print("\n所有元素:")
for i, element in enumerate(elements, 1):
    print(f"Element {i} ({element.category}):")
    print(element)
    print("=" * 60)
(2)、运行结果:

三种方法对比
| 特性 / 方法 | hi_res | ocr_only | fast |
| 核心原理 | 布局分析 + OCR + NLP 模型 | 仅 OCR | 纯文本 |
| 适用文档类型 | 复杂排版扫描件 | 扫描件 | 内嵌文本 |
| 是否依赖 OCR | ✔ | ✔ | ❌ |
| 处理速度 | 慢 | 中 | 快 |
| 准确率 | 高 | 中 | 低 |
| 是否保留布局 | ✔ | ❌ | ❌ |
| 是否支持表格识别 | ✔ | ❌ | ❌ |
| 资源消耗 | 高 | 中 | 低 |
| 典型应用场景 | 法律合同、财报、科研论文 | 老旧扫描文档 | 快速预览 |
| 依赖外部服务 | ✔(YOLOX 布局检测模型) | ✔(Tesseract) | ❌ |
二、文本分块
1. 定义与功能
文本分块(Text Chunking / Splitting)是构建RAG流程的关键步骤。其核心原理是将加载后的长篇文本资料,切分成更小、更易于处理的文本块(Chunks)。这些被切分出的文本块,是后续向量检索和模型处理的基本单位。

上述分词示例来自:Text Splitter Visualizer
文本分块的核心目标,可以归纳为以下几点:
(1)、克服上下文窗口限制
在 RAG(检索增强生成)系统中,文本分块首先是为了适配两个关键组件的硬性长度限制:
- 嵌入模型(Embedding Model) :通常有较短的上下文窗口(例如 512 或 768 token)。任何超出此限制的文本块在输入时都会被截断,导致信息丢失,生成的向量也无法完整代表原文的语义。因此,文本块的大小必须小于等于嵌入模型的上下文窗口。
- 大语言模型(LLM) :虽然上下文窗口更大(例如 32K、128K 甚至更多),但其总容量必须容纳用户问题、系统提示和所有检索到的文本块。如果单个块过大,可能会导致只能容纳少数几个相关的块,限制了LLM回答问题时可参考的信息广度。

(2)、提高检索精度与效率
文本分块不仅是为了“塞得进”模型,更是为了“找得准、响应快”。
假设嵌入模型最多能处理8192个token,是否应该把块切得尽可能大(比如8000个token)呢?答案是否定的。块的大小并非越大越好,过大的块会严重影响RAG系统的性能。
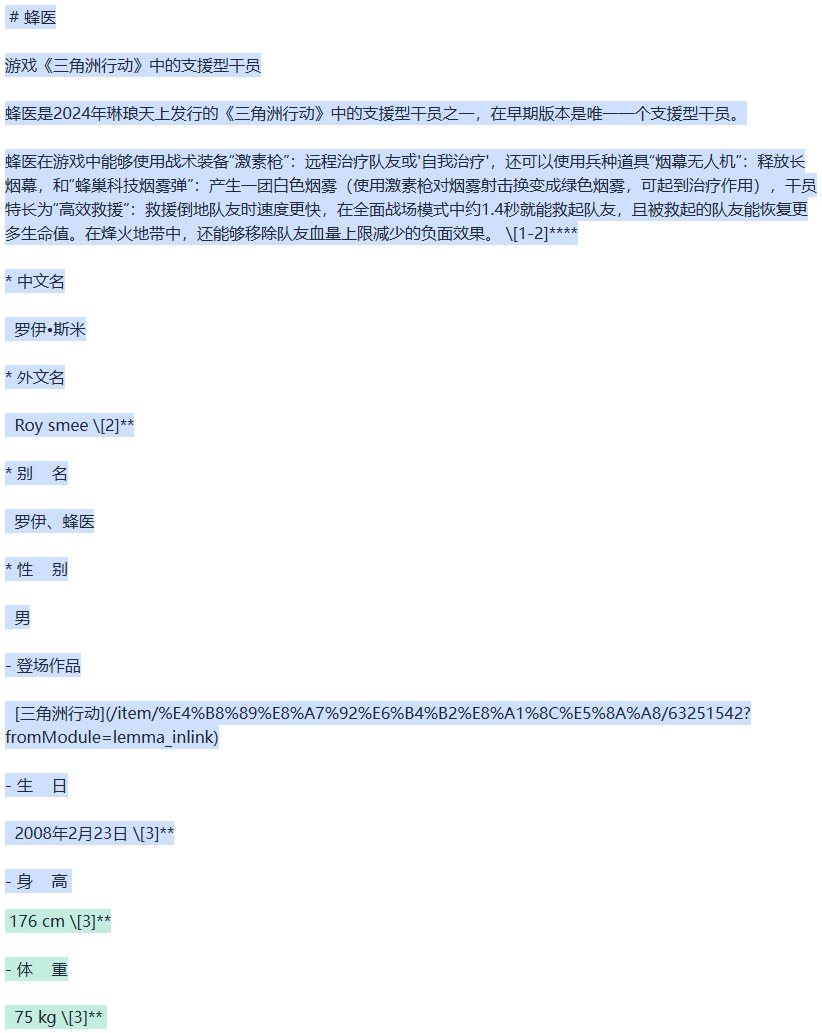
若将整篇“蜂医”角色档案视为一个文本块,就是一个典型的“大块反例” 。
⚠️ 问题一:信息太杂,检索“找不到重点”
用户问:“蜂医怎么用烟幕无人机?”→ 模型面对的是包含角色背景、技能、装备、操作机制、参考资料等上千字的混杂内容。向量检索算法会被大量无关信息干扰,可能匹配到“高效救援”或“身高体重”,而不是真正的操作说明。
⚠️ 问题二:语义被稀释,模型“看不懂重点”
即使检索到了这一大段,LLM 也要在有限的上下文窗口内消化所有内容。它可能被迫忽略关键细节(如“长按开火键引导转向”),因为要优先处理前面的角色设定或后面的参考链接。
⚠️ 问题三:结构被破坏,阅读体验“灾难级”
如果你是玩家,想查“烟雾弹怎么用”,结果系统返回的是从“蜂医是2024年琳琅天上发行的角色”开始的一整段——你不得不再次手动扫描、寻找关键词。这根本不是“智能检索”,而是“全文搜索+人工筛选”。
✅ 因此,提升检索精度与效率的关键,不是“尽量少分块”,而是“恰到好处地分块”:
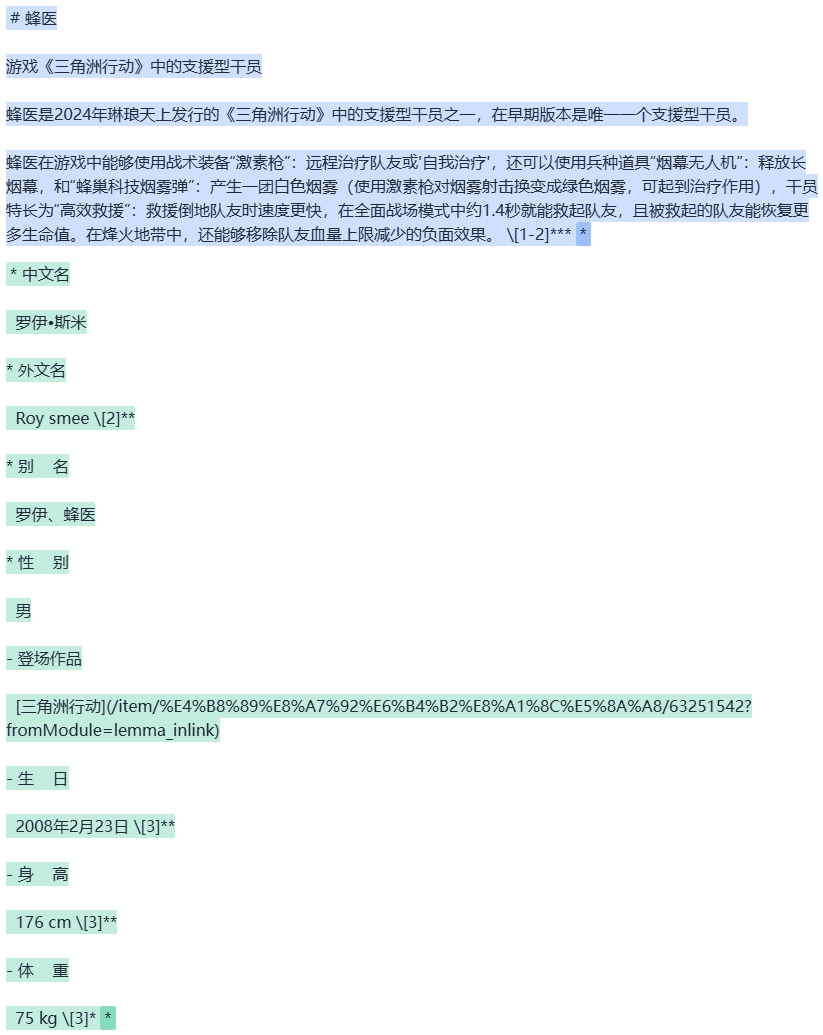
结构化分块正例 ——“蜂医”角色档案的语义切分示范。
(3)、维护上下文完整性
“文本分块的最终目的,不是简单地“把长文本变短”,而是在模型可处理的前提下,尽可能保留原始信息的语义完整性和逻辑连贯性。如果分块策略过于机械(例如按固定 token 数截断),很容易在句子中间、列表项之间或代码块内部强行切断,导致每个片段都无法独立表达完整含义。
✅因此,高质量的分块应优先遵循文本自身的语义边界:
- 不在句子中间断开;
- 保持段落、列表、表格、引用、代码块等结构的完整性;
- 在必要时适当放宽长度限制,以容纳关键上下文(如术语解释、因果逻辑)。
💡 分块的目标,是让每一块都能被准确编码、精准检索、有效利用。
2. 初级分块策略
掌握一些基础且常用的分块策略是构建 RAG 系统的起点。这些策略各有优劣,适用于不同的场景。
(1)、固定大小分块
这是最简单、也最常用的分块策略。其核心思想非常直接:按预设的字符数(character count)或 token 数(token count)对文本进行等长切割。例如,每 512 个 token 切一刀,超出部分归入下一块。
为了缓解“在句子中间硬切”带来的语义断裂问题,实践中通常会引入 “重叠”(Overlap)机制:让每个块的末尾与下一个块的开头保留一段重复内容。这样,即使切分点落在句子中,关键上下文仍有可能被保留在相邻块中,降低信息丢失风险。
✅ 优点
- 实现极其简单,几乎不需要复杂的逻辑;
- 计算开销非常小,处理速度快;
- 对文本格式没有特殊要求。
❌ 缺点
- 极易破坏语义完整性:可能在句子、代码、列表中间切断,导致块内信息不完整;
- 重叠方案存在局限:虽能减少断裂风险,但重复内容会增加存储和计算负担,且关键语义仍可能丢失;
- 划分粒度缺乏弹性:对技术文档和叙述性内容采用统一处理方式,无法适应不同文本特性。
📌 适用场景
- 结构简单或长度均匀的文本(如日志、新闻简报);
- 数据量极大,需要快速进行初步处理;
- 作为更复杂分块策略(如递归分块)的最后“兜底”手段。
📝 实现代码
from langchain.text_splitter import CharacterTextSplitter
from langchain_community.document_loaders import TextLoader

# 1. 文档加载
loader = TextLoader("../../data/C2/txt/蜂医.txt", encoding="utf-8")
docs = loader.load()

# 2. 初始化固定大小分块器
text_splitter = CharacterTextSplitter(
    chunk_size=200,    # 每个块的大小
    chunk_overlap=10   # 块之间的重叠大小
)

# 3. 执行分块
chunks = text_splitter.split_documents(docs)

# 4. 打印结果
print(f"文本被切分为 {len(chunks)} 个块。\n")
print("--- 前5个块内容示例 ---")
for i, chunk in enumerate(chunks[:5]):
    print("=" * 60)
    # chunk 是一个 Document 对象,需要访问它的 .page_content 属性来获取文本
    print(f'块 {i+1} (长度: {len(chunk.page_content)}): "{chunk.page_content}"')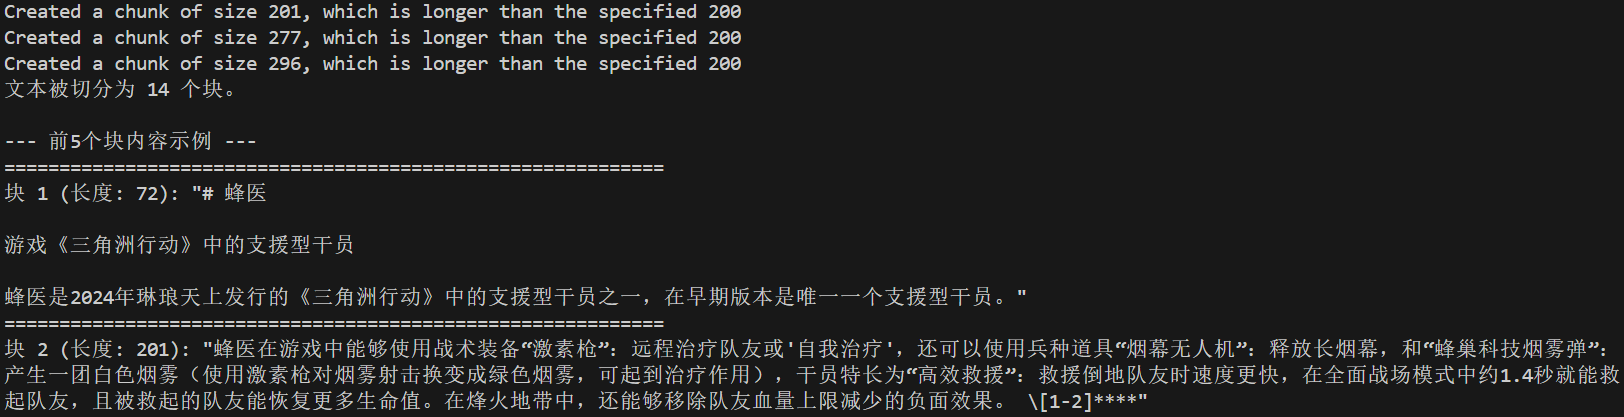
(2)、基于句子的分块
如果说固定大小分块是“用尺子裁布”,那么基于句子的分块就是“顺着针脚缝线剪”——它试图尊重语言最自然的单元:句子。
核心流程分为两步:
- 先使用句子分割器(Sentence Splitter)将原文拆分成独立句子。分割可基于简单标点(如句号、问号、感叹号),但更推荐采用成熟的NLP工具(如NLTK、spaCy),以避免将类似"Mr. Smith"这类专有名词错切的情况;
- 再将一个或多个连续句子组合成一个文本块(Chunk),使其长度尽量接近目标大小。同样可以引入句子级别的重叠。
✅ 优点
- 更好地保持语义完整性;
- 更贴合人类阅读习惯。
❌ 缺点
- 句子长度差异大:有的句子很短,有的很长,导致文本块(Chunk)大小极不均匀,影响嵌入模型输入稳定性;
- 依赖 NLP 分割质量:仅基于简单标点规则容易出错,依赖NLP 工具(如 NLTK、spaCy)进行优化;
- 不适用于非句子结构:对代码、YAML 配置、无标点列表、表格等“非文本文档”效果较差;
- 仍可能切断跨句逻辑:比如一个论点由三句话共同构成,若在第二句后切分,第三句就失去了上下文。
📌 适用场景
- 处理结构良好、以完整句子为主的文本(如新闻文章、报告、小说等);
- 对句子级语义敏感(如问答、摘要)。
📝 实现代码
from langchain_community.document_loaders import TextLoader
import re

# 1. 文档加载
loader = TextLoader("../../data/C2/txt/蜂医.txt", encoding="utf-8")
docs = loader.load()

# 2. 提取文档内容并分句
text_content = docs[0].page_content

# 使用正则表达式进行分句
pattern = r'[^。!?;]+?[。!?;]+'
sentences = re.findall(pattern, text_content)

# 处理未以标点结尾的剩余文本
full_text = "".join(sentences)
if len(full_text) < len(text_content):
    remaining = text_content[len(full_text):].strip()
    if remaining:
        sentences.append(remaining)

# 3. 创建基于句子的分块
chunks = []
current_chunk = ""
for sentence in sentences:
    # 如果当前块加上新的句子仍不超过200个字符,则继续添加,否则创建新块
    if len(current_chunk) + len(sentence) + 1 <= 200: # +1是为了解释可能的空格或换行符
        current_chunk += sentence + " "
    else:
        chunks.append(current_chunk.strip())  # 去掉两端多余的空格
        current_chunk = sentence + " "

# 添加最后的块(如果有的话)
if current_chunk:
    chunks.append(current_chunk.strip())

# 4. 打印结果
print(f"文本被切分为 {len(chunks)} 个块。\n")
print("--- 前5个块内容示例 ---")
for i, chunk in enumerate(chunks[:5]):
    print("=" * 60)
    print(f'块 {i+1} (长度: {len(chunk)}): "{chunk}"')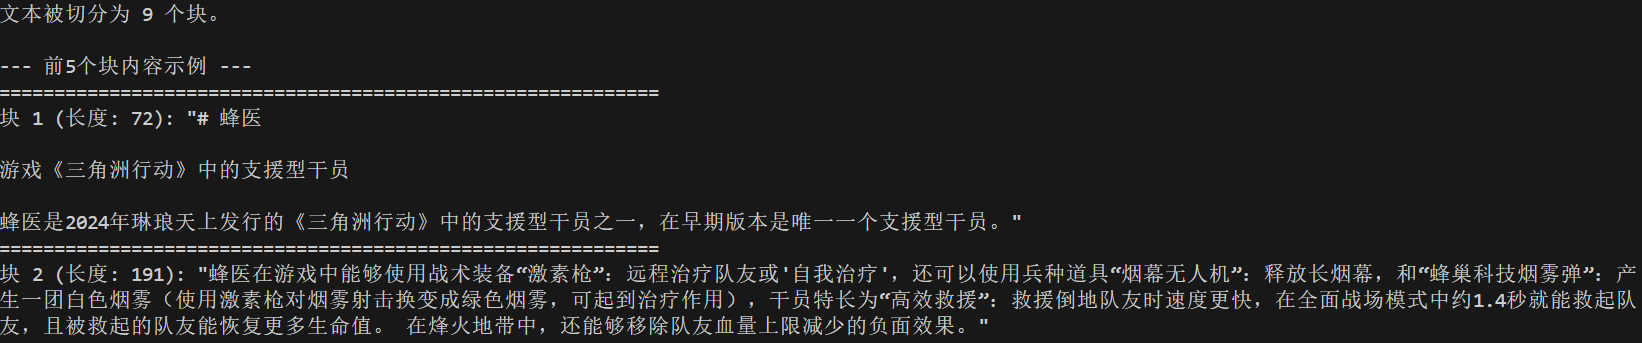
(3)、递归字符分块
如果说“固定大小分块”太机械,“基于句子分块”又依赖外部 NLP 工具,,而递归字符分块找到了“黄金平衡点”。作为 LangChain 等主流框架推荐的方法。这种轻量级智能方法既能控制文本长度,又能最大程度保持文本的自然结构。
✅ 优点
- 保持语义结构:优先保留段落、列表等高语义单元,尽可能维持文本的逻辑结构;
- 无需外部依赖:不依赖 NLTK、spaCy 等 NLP 库;
- 通用性强:对多种类型文档都有不错表现。
❌ 缺点
- 分隔符选择影响效果:若文档使用非标准换行(如无空行分段),默认规则可能失效;
- 对密集文本效果有限:在没有明显分隔符的长段落(如学术论文)中,可能最终退化为“固定大小分块”;
- 无法理解深层语义:它知道“\n\n”是段落,但不知道这两段可能在讲同一个论点。
📌 适用场景
- 通用 RAG 应用的首选策略,尤其当文档结构较清晰(如含段落、列表、标题);
- 希望在不引入复杂 NLP 流程的前提下,获得比固定分块更合理的块;
- 作为高级分块策略(如语义分块)的最后“兜底”手段。
📝 实现代码
from langchain.text_splitter import RecursiveCharacterTextSplitter
from langchain_community.document_loaders import TextLoader

loader = TextLoader("../../data/C2/txt/蜂医.txt", encoding="utf-8")
docs = loader.load()

text_splitter = RecursiveCharacterTextSplitter(
    # 针对中英文混合文本,定义一个更全面的分隔符列表
    separators=["\n\n", "\n", "。", ",", " ", ""], # 按顺序尝试分割
    chunk_size=200,
    chunk_overlap=10
)

chunks = text_splitter.split_documents(docs)

print(f"文本被切分为 {len(chunks)} 个块。\n")
print("--- 前5个块内容示例 ---")
for i, chunk in enumerate(chunks[:5]):
    print("=" * 60)
    print(f'块 {i+1} (长度: {len(chunk.page_content)}): "{chunk.page_content}"')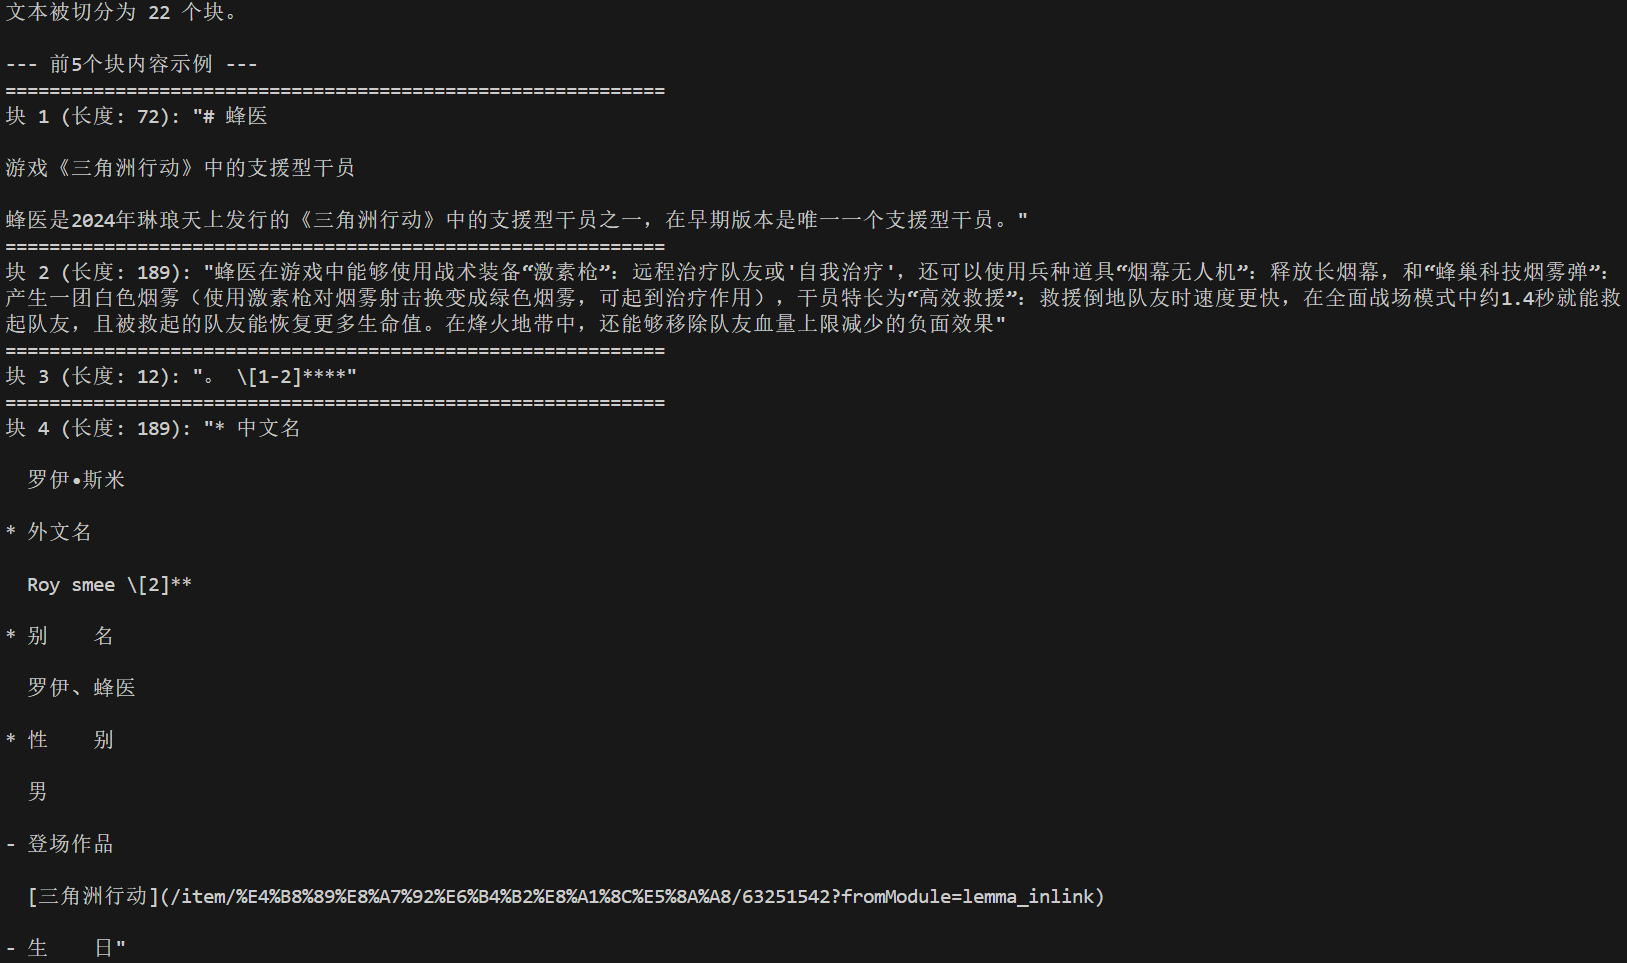
(4)、基于文档结构分块
当文本本身具备结构化特征——如网页的HTML、笔记的Markdown、配置文件的YAML或知识库的JSON时,最佳实践是遵循其固有结构进行切分。这种基于文档结构的分块方法,通过识别原文的标记符号、标签体系或层级关系,将其作为自然的分割边界。
✅ 优点
- 结构完整性:能够最好地保持原文组织架构;
- 内容内聚性:一个段落、一个列表项、一个 FAQ 条目,往往本身就是完整的信息单元;
- 元数据友好性:结构化标签自带上下文信息,无需额外提取。
❌ 缺点
- 依赖结构质量:若文档格式混乱(如无标题的纯文本、错误嵌套的 HTML),策略会失效;
- 文本块大小不均:不同结构元素的文本量可能差异巨大,导致文本块(Chunk)大小极不均匀;
- 格式适配成本高:需为 HTML、Markdown、LaTeX等分别实现解析器。
📌 适用场景
- 具有清晰、标准化结构的文档(如网页、Markdown 文档、JSON、XML)等;
- 构建可溯源、可过滤的 RAG 系统,例如“只检索‘安装指南’章节”。
📝 实现代码
from langchain_community.document_loaders import TextLoader
from langchain.docstore.document import Document

# 1. 加载文档
loader = TextLoader("../../data/C2/txt/蜂医.txt", encoding="utf-8")
docs = loader.load()
text = docs[0].page_content

# 2. 按段落分割(两个及以上换行符视为段落分隔)
paragraphs = [p.strip() for p in text.split('\n\n') if p.strip()]

# 3. 构建 Document 对象列表
chunks = [Document(page_content=para) for para in paragraphs]

# 4. 输出结果
print(f"文本被切分为 {len(chunks)} 个结构块。\n")
print("--- 前5个块内容示例 ---")
for i, chunk in enumerate(chunks[:5]):
    print("=" * 60)
    print(f'块 {i+1} (长度: {len(chunk.page_content)}): "{chunk.page_content}"')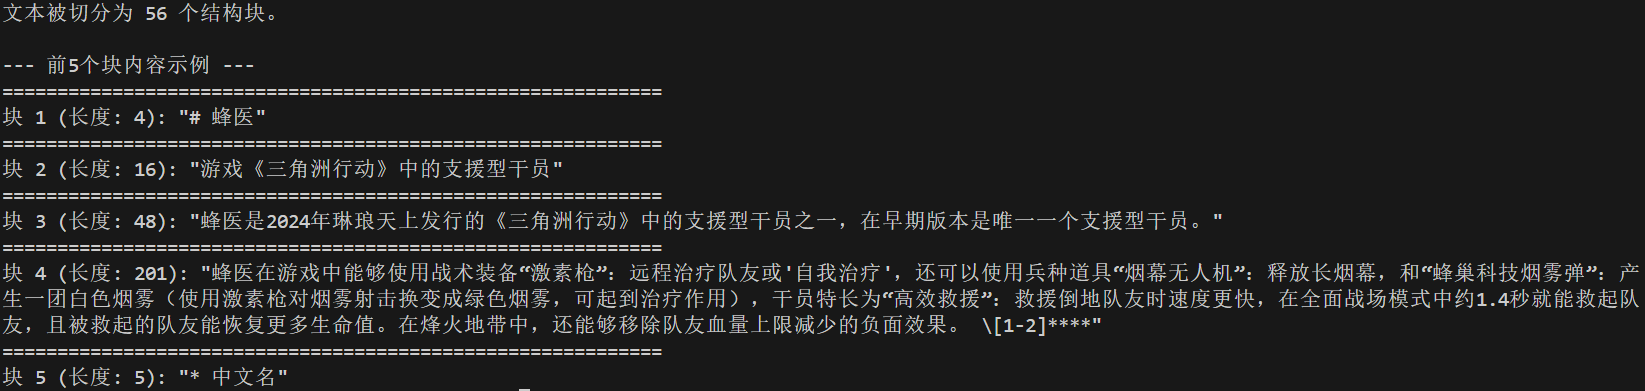
(5)、混合分块
现实中的文档通常兼具结构化和自由文本特征。例如百度页面则同时包含列表、代码块和长篇论述。在这种情况下,单一分块策略往往难以兼顾,因此混合分块就成为最佳解决方案。
✅ 优点
- 兼顾结构与长度:既能利用文档的宏观结构,又能确保最终块大小可控;
- 元数据丰富:可以方便地继承来自结构化分割的元数据(如标题层级);
- 适应性强:可根据文档类型灵活组合策略。
❌ 缺点
- 实现复杂度高:需设计多阶段处理流程,调试成本较高;
- 参数调优精细:大块阈值、子块大小、元数据映射等都需要反复测试优化;
- 依赖结构质量:若原始文档结构混乱,可能导致首层切分失效。
📌 适用场景
- 对分块质量要求较高,需要兼顾上下文连贯性、结构完整性和内容大小控制的场景;
- 处理Markdown、富文本文档等兼具结构化和自由文本特征的内容。
📝 实现代码
from langchain_community.document_loaders import TextLoader
from langchain.docstore.document import Document
import re

# 1. 加载文档
loader = TextLoader("../../data/C2/txt/蜂医.txt", encoding="utf-8")
docs = loader.load()
text = docs[0].page_content

# 2. 清理多余空行
text = re.sub(r'\n{3,}', '\n\n', text)

# 将一级标题 "# 蜂医" 替换为语义标题 "## 背景介绍"
text = re.sub(r'^#\s*蜂医\s*\n?', '## 蜂医背景介绍\n', text, flags=re.MULTILINE)

# 将纯文本"参考资料"规范化为二级标题
text = re.sub(r'(?<=\n)\s*参考资料\s*(?=\n)', '## 参考资料', text)
text = re.sub(r'^\s*参考资料\s*(?=\n)', '## 参考资料\n', text, flags=re.MULTILINE)
text = re.sub(r'(?<=\n)\s*参考资料\s*$', '\n## 参考资料', text, flags=re.MULTILINE)

# 3. 按行处理
lines = text.split('\n')

# 4. 按标题分块
chunks = []
current_chunk = ""
current_title = ""

for line in lines:
    stripped_line = line.rstrip()

    # 识别二级标题
    if stripped_line.startswith("## ") and not stripped_line.startswith("####"):
        if current_chunk.strip():
            chunks.append(Document(page_content=current_chunk.strip(), metadata={"title": current_title}))
        current_title = stripped_line[3:].strip()
        current_chunk = ""
    # 识别三级标题
    elif stripped_line.startswith("### "):
        if current_chunk.strip():
            chunks.append(Document(page_content=current_chunk.strip(), metadata={"title": current_title}))
        current_title = stripped_line[4:].strip()
        current_chunk = ""
    else:
        # 普通行
        current_chunk += line + "\n"

# 添加最后一个块
if current_chunk.strip():
    chunks.append(Document(page_content=current_chunk.strip(), metadata={"title": current_title}))

# 5. 智能切分长块
final_chunks = []
MAX_LENGTH = 500
NO_SPLIT_TITLES = {"参考资料", "背景介绍"}

for chunk in chunks:
    content = chunk.page_content
    title = chunk.metadata.get("title", "")

    if title in NO_SPLIT_TITLES:
        final_chunks.append(chunk)
    elif len(content) <= MAX_LENGTH:
        final_chunks.append(chunk)
    else:
        # 按自然段或列表项边界切分
        sub_parts = re.split(r'(\n\n|\n(?=- ))', content)
        temp_chunk = ""
        for part in sub_parts:
            if not part.strip():
                continue
            if part in {'\n\n', '\n'}:
                temp_chunk += part
                continue
            candidate = temp_chunk + part
            if len(candidate) > MAX_LENGTH and temp_chunk.strip():
                final_chunks.append(Document(page_content=temp_chunk.strip(), metadata={"title": title}))
                temp_chunk = part
            else:
                temp_chunk += part
        if temp_chunk.strip():
            final_chunks.append(Document(page_content=temp_chunk.strip(), metadata={"title": title}))

# 6. 输出结果
print(f"文本被切分为 {len(final_chunks)} 个结构块。\n")
print("--- 前5个块内容示例 ---")
for i, chunk in enumerate(final_chunks[:5]):
    print("=" * 60)
    title = chunk.metadata.get("title", "")
    print(f'块 {i+1} | 标题: "{title}" | (长度: {len(chunk.page_content)}): \n{chunk.page_content}')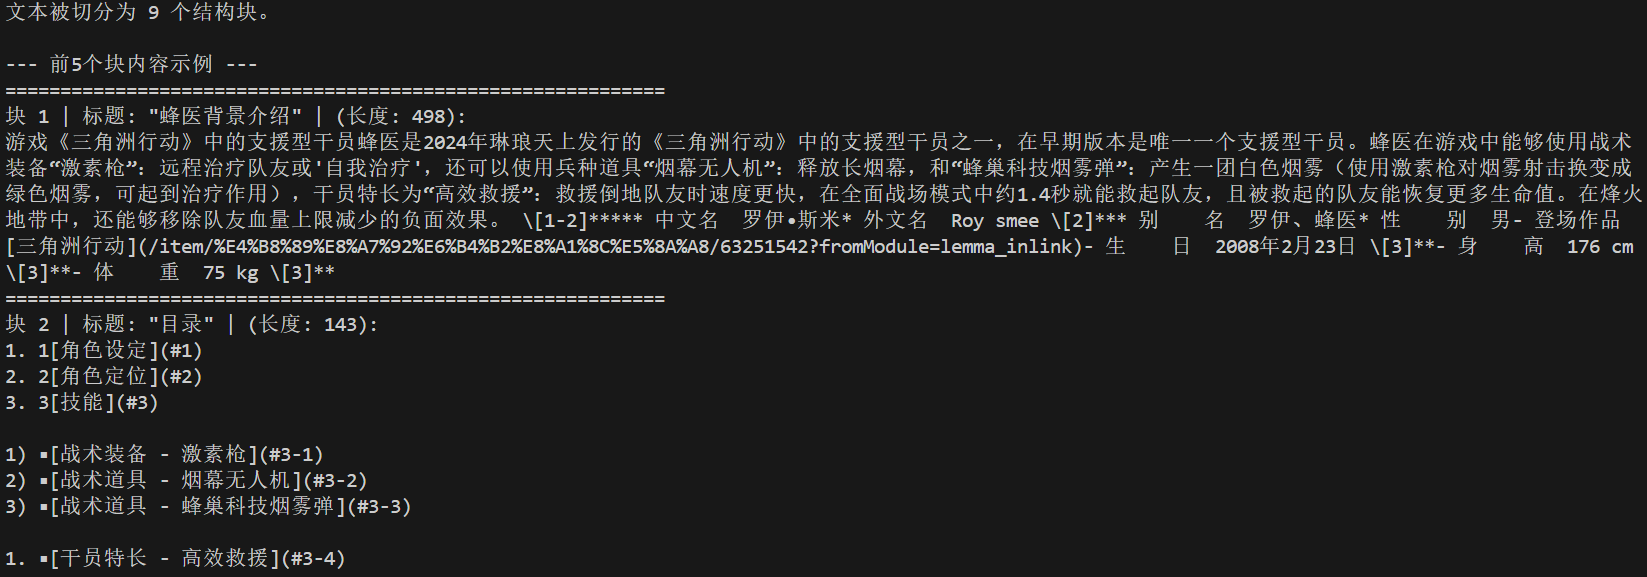
3. 高级分块策略
当基础策略无法满足更复杂的需求时,或者当你想追求极致的检索效果时,可以探索以下更高级的分块方法。这些方法通常更侧重于语义理解或利用更复杂的模型/流程。
(1)、语义分块
如果说前面的策略都是“看形式切分”,那么语义分块就是真正“看意思切分”——它不关心字符数、标点或 HTML 标签,而是通过向量空间中的语义距离,找到话题自然转变的地方。
🔧 实现原理
- 将文本拆分为最小语义单元(如单个句子);
-
为每个单元生成 Embedding 向量(如bge-base-zh-v1.5),得到向量序列:
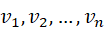
-
使用余弦距离计算相邻单元之间的语义距离:
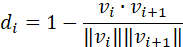
- 设定一个语义距离阈值
 :
- 如果
 ,说明话题发生明显跳跃,在此处切分;
- 否则,将
 合并到当前块中。
- 如果
- (可选)使用滑动窗口、聚类算法(如层次聚类)或动态阈值,进一步提升边界检测精度。
✅ 优点
- 精准语义切分:总能在话题转折处断开;
- 内容聚焦性强:每个块聚焦一个主题,极大提升检索相关性和 LLM 理解效果;
❌ 缺点
- 计算开销较大:需为每个句子生成 Embedding 向量并计算语义距离,速度远慢于固定大小或递归字符分块;
- 模型依赖性较强:直接受嵌入模型(Embedding Model)性能影响,若模型无法区分"烟幕无人机"和"激素枪"的语义差异,分块就会失效;
- 阈值调优复杂:太敏感 → 块太碎;太宽松 → 块太杂。通常需要多次试验才能确定合适值;
- 长距离依赖难捕捉:仅看相邻句相似度,难以识别跨越多个句子的整体行文结构(如“总-分-总”结构)。
📌 适用场景
- 没什么结构化标记,但语义丰富的文本内容(如小说、对话记录等);
- 对分块质量要求很高,并且计算资源比较充裕的场景。
📝 实现代码
from langchain_experimental.text_splitter import SemanticChunker
from langchain_huggingface import HuggingFaceEmbeddings
from langchain_community.document_loaders import TextLoader
from dotenv import load_dotenv
load_dotenv()

embeddings = HuggingFaceEmbeddings(
    model_name="BAAI/bge-small-zh-v1.5",
    model_kwargs={'device': 'cpu'},
    encode_kwargs={'normalize_embeddings': True}
)

# 初始化 SemanticChunker
text_splitter = SemanticChunker(
    embeddings,
    breakpoint_threshold_type="percentile" # 也可以是 "standard_deviation", "interquartile", "gradient"
)

loader = TextLoader("../../data/C2/txt/蜂医.txt", encoding="utf-8")
documents = loader.load()

docs = text_splitter.split_documents(documents)

print(f"文本被切分为 {len(docs)} 个块。\n")
print("--- 前2个块内容示例 ---")
for i, chunk in enumerate(docs[:2]):
    print("=" * 60)
    print(f'块 {i+1} (长度: {len(chunk.page_content)}):\n"{chunk.page_content}"')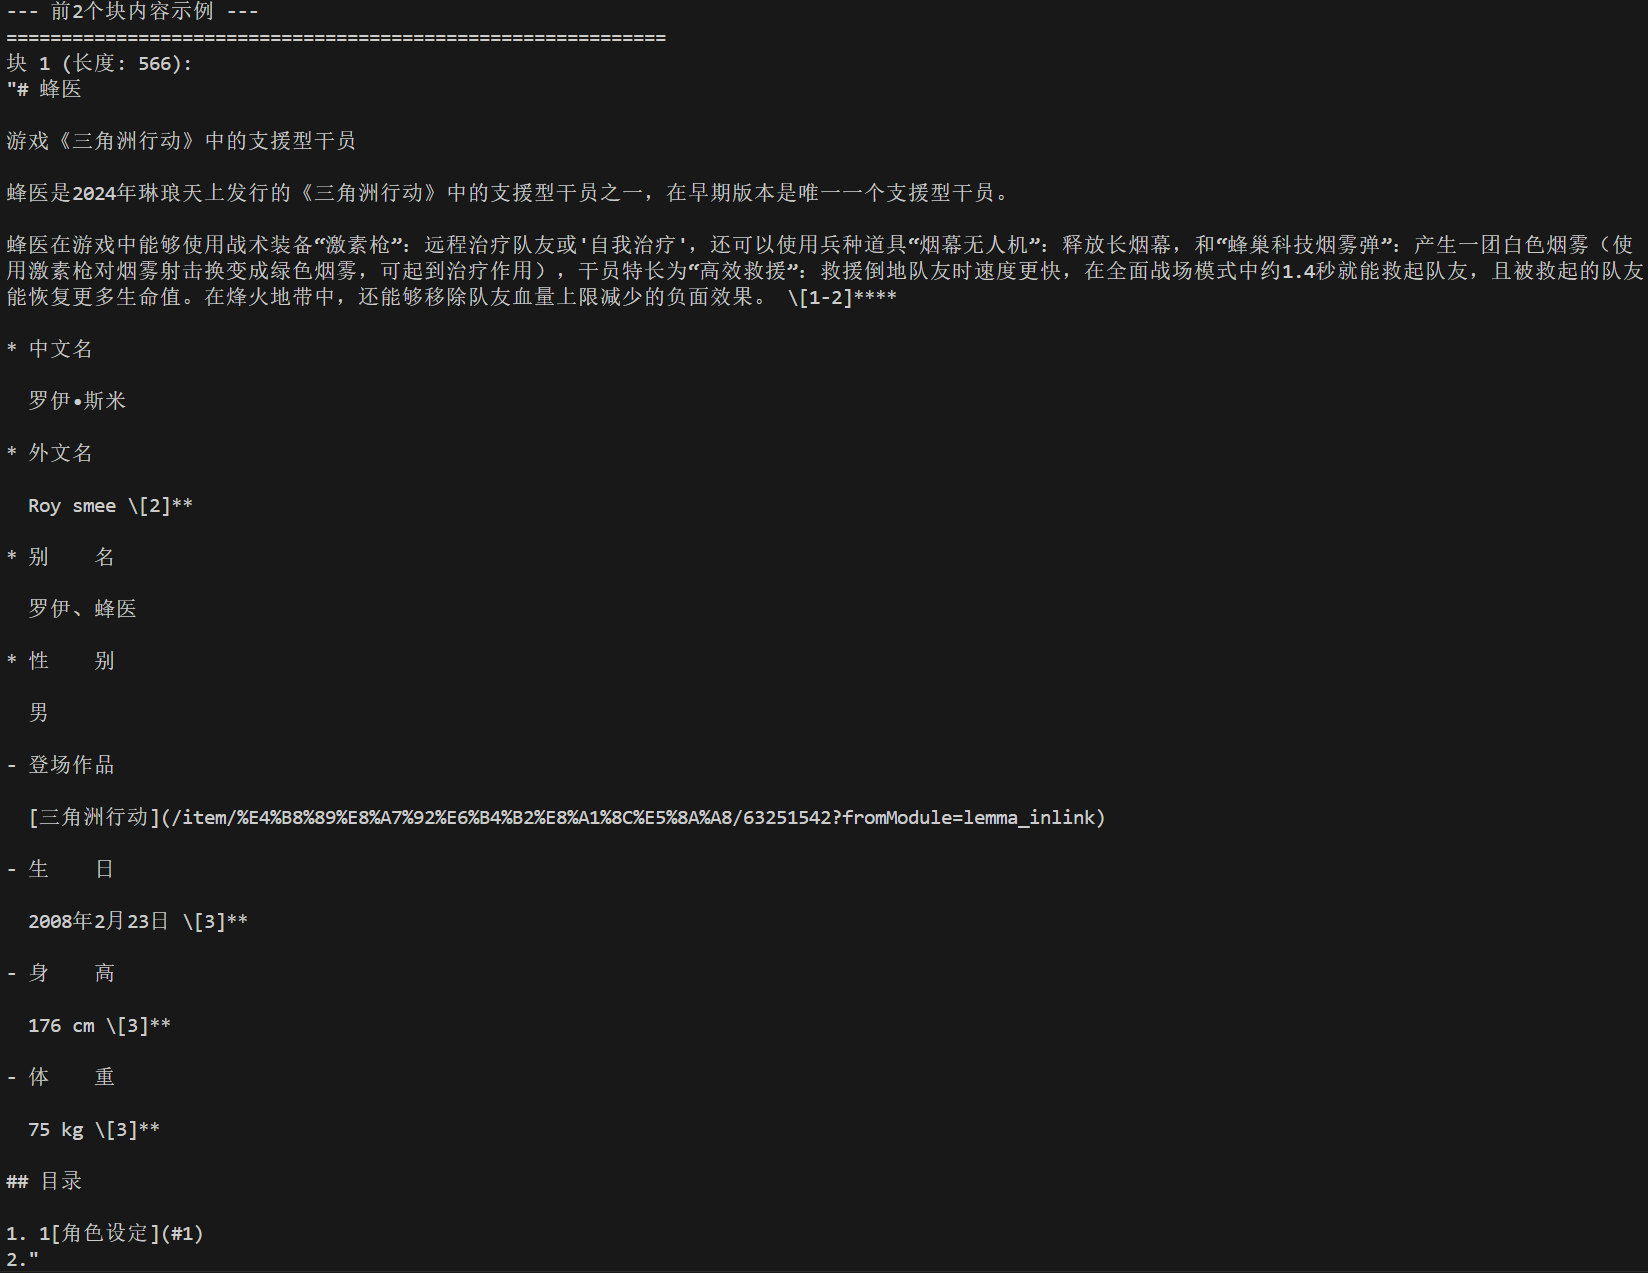
(2)、分层分块
与混合策略类似,如果说混合分块是“粗切再细切”,那么分层分块就是“系统性地构建多尺度知识视图”。它不只生成一种粒度的文本块,而是按文档的内在层级结构,自上而下创建多个级别的文本块(Chunks),形成一个从宏观到微观的信息金字塔。
✅ 优点
- 灵活适配不同查询需求:事实型问题用小块,解释型问题用大块;
- 保留多层次上下文:既不错过细节,也不丢失整体逻辑。
❌ 缺点
- 索引与存储开销增大:相同内容会在多个层级重复存储;
- 关系管理复杂:需要额外维护父子块之间的映射关系(通常通过ID或元数据实现);
- 检索逻辑需定制::无法直接使用标准向量检索,需设计分层检索策略。
📌 适用场景
- 结构清晰的长文档(如书籍、长篇报告等);
- 需要兼顾检索精度与回答连贯性的场景。
📝 实现代码
import re
from langchain_experimental.text_splitter import SemanticChunker
from langchain_huggingface import HuggingFaceEmbeddings
from langchain.text_splitter import MarkdownHeaderTextSplitter
from langchain_core.documents import Document

# 文本清洗函数
def clean_baike_text(text: str) -> str:
    # 1. 清理参考文献标记
    text = re.sub(r'\\\[[^\]]*\]\*{0,4}', '', text)

    # 2. 标准化换行和空格
    text = re.sub(r'\n+', '\n', text)
    text = re.sub(r' +', ' ', text)
    text = text.strip()

    # 3. 按句子分割
    sentences = re.split(r'(?<=[。!?;])', text)
    seen_sentences = set()
    cleaned_sentences = []

    for sent in sentences:
        sent = sent.strip()
        if not sent:
            continue
        # 去重
        if sent in seen_sentences:
            continue
        seen_sentences.add(sent)
        cleaned_sentences.append(sent)

    cleaned_text = ''.join(cleaned_sentences)

    return cleaned_text


# 1. 加载并清洗原始文本
input_path = "../../data/C2/txt/蜂医.txt"

with open(input_path, "r", encoding="utf-8") as f:
    raw_text = f.read()

cleaned_text = clean_baike_text(raw_text)

# 2. 第一层:按 Markdown 标题结构分块
headers_to_split_on = [
    ("#", "一级标题"),
    ("##", "二级标题"),
    ("###", "三级标题"),
]

markdown_splitter = MarkdownHeaderTextSplitter(
    headers_to_split_on=headers_to_split_on,
    strip_headers=False  # 保留标题文本在内容中
)

docs_by_header = markdown_splitter.split_text(cleaned_text)

# 3. 第二层:语义分块
embeddings = HuggingFaceEmbeddings(
    model_name="BAAI/bge-small-zh-v1.5",
    model_kwargs={'device': 'cpu'},
    encode_kwargs={'normalize_embeddings': True}
)

semantic_splitter = SemanticChunker(
    embeddings,
    breakpoint_threshold_type="percentile"  # 也可尝试 "gradient"
)

# 4. 分层分块 + 保留元数据
final_chunks = []
for doc in docs_by_header:
    sub_chunks = semantic_splitter.split_text(doc.page_content)
    for sub in sub_chunks:
        sub = sub.strip()
        if len(sub) < 10:  # 过滤过短的 chunk
            continue
        final_chunks.append(
            Document(
                page_content=sub,
                metadata=doc.metadata
            )
        )

# 5. 输出结果
print(f"文本被切分为 {len(final_chunks)} 个块。\n")

print("--- 前 2 个块示例---")
for i, chunk in enumerate(final_chunks[:2]):
    print("=" * 70)
    print(f"块 {i + 1}")
    print(f"层级路径: {chunk.metadata}")
    print(f"内容长度: {len(chunk.page_content)}\n{chunk.page_content}")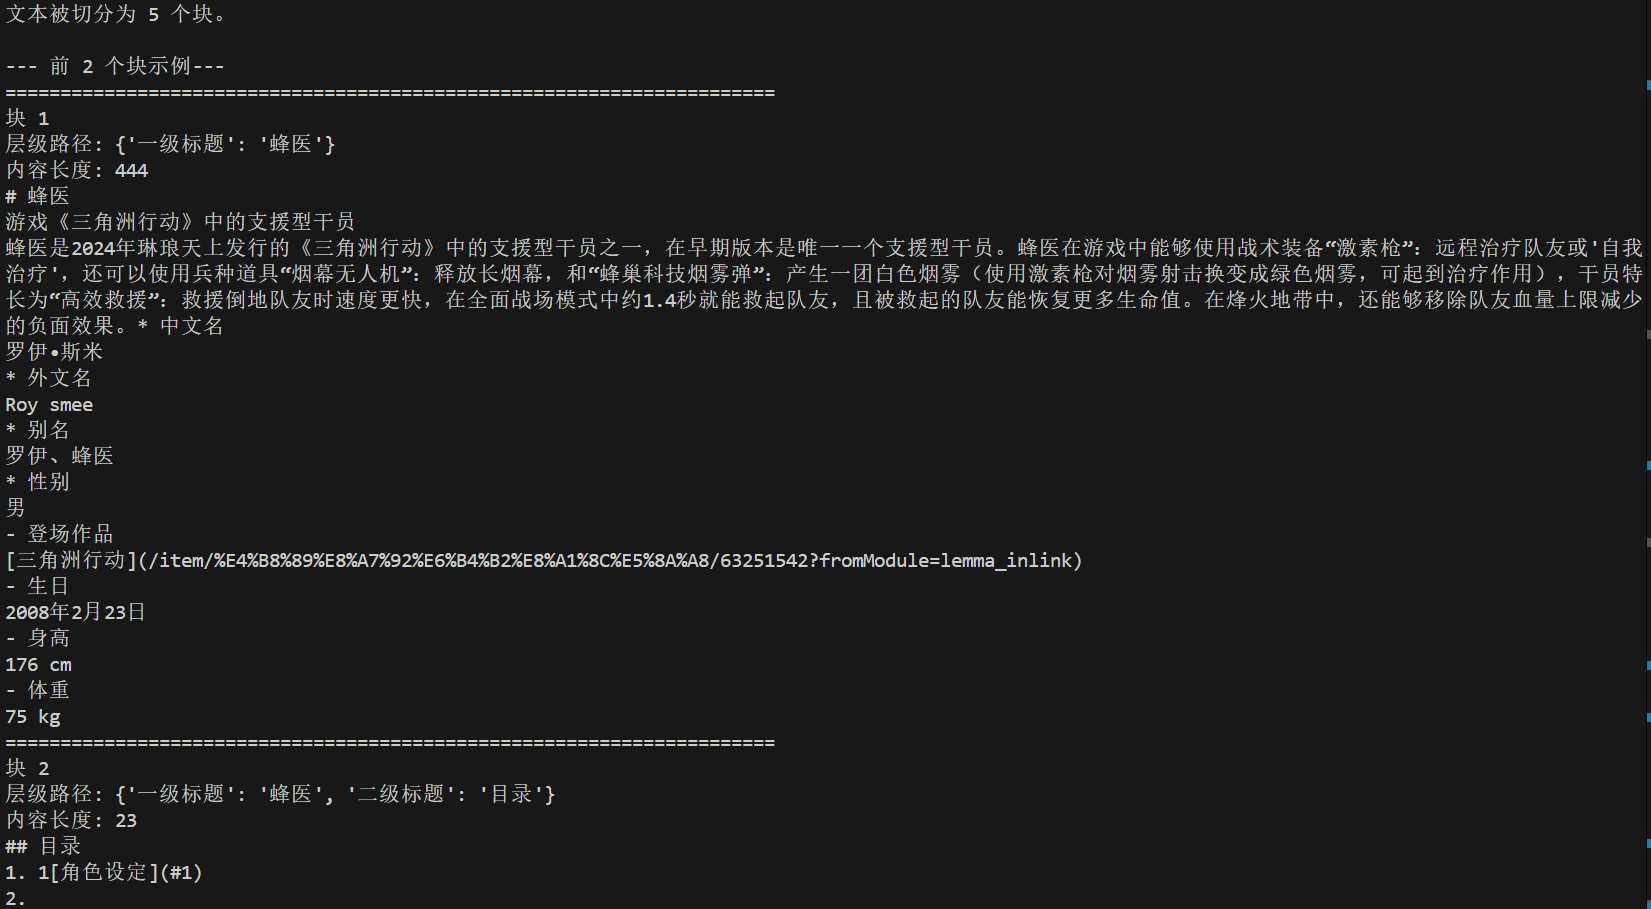
(3)、命题分块
命题分块是将知识拆成原子性的事实。它的目标不是保留段落或句子,而是将文本解构为最小、独立、可验证的语义单元——命题。
✅ 优点
- 极致细粒度:每个块只表达一个独立事实,极大提升检索精度;
- 高度聚焦:避免无关信息干扰,特别适合事实型问答;
- 便于知识融合:原子命题易于去重、对齐、跨文档聚合,是构建结构化知识图谱的基础。
❌ 缺点
- 模型依赖性极强:大语言模型可能遗漏、误析或幻构命题;
- 计算性能开销大:每句话都要调用大语言模型解析,计算成本高昂,处理速度慢;
- 信息保真度不足:语气、修辞、复杂逻辑(如“虽然…但是…”)难以在原子命题中保留;
- 输出整合难度大:大语言模型需将多个离散命题“重组成连贯回答”,可能遗漏逻辑连接。
📌 适用场景
- 对信息的原子性和精确性要求极高的场景(如知识库构建、事实性问答系统等);
📝 实现代码
❗ 要先预先安装以下依赖:
pip install spacy
python -m spacy download zh_core_web_trf
from langchain.text_splitter import SpacyTextSplitter
from langchain_community.document_loaders import TextLoader

# 1. 文档加载
loader = TextLoader("../../data/C2/txt/蜂医.txt", encoding="utf-8")
docs = loader.load()

# 2. 按命题分割
text_splitter = SpacyTextSplitter(
    pipeline="zh_core_web_trf",
    chunk_size=300,
    chunk_overlap=10,
    separator="\n"
)

# 3. 执行分块
chunks = text_splitter.split_documents(docs)

# 4. 打印结果
print(f"文本被切分为 {len(chunks)} 个块。\n")
print("--- 前5个块内容示例 ---")
for i, chunk in enumerate(chunks[:5]):
    print("=" * 60)
    print(f'块 {i+1} (长度: {len(chunk.page_content)}): "{chunk.page_content}"')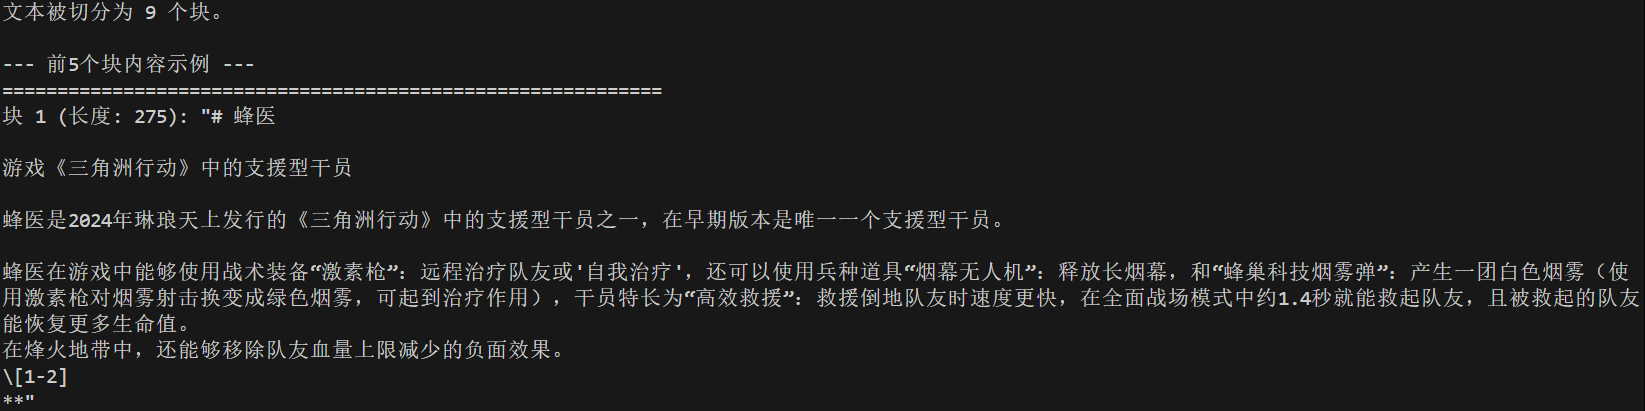
(4)、基于智能体/大语言模型的分块
更进一步,让一个智能体 (Agent) 或直接使用 LLM 来决策如何进行分块。可以给 LLM 设计特定的 Prompt,让它根据内容理解来判断最佳的分割点,或者让 Agent 动态地选择和组合不同的分块策略。
✅ 优点
- 潜力巨大:理论上可以实现最智能、最符合语义和上下文的分块。
❌ 缺点
- 实现非常复杂:需要精巧的提示词工程(Prompt Engineering)或智能体(Agent)逻辑设计;
- 延迟高、速度慢:相比其他分块,耗时可能高出几个数量级;
- 可控性弱:难以保证块长度、数量或格式的确定性;
- 仍属前沿探索:缺乏标准化工具链,多数实现为研究原型或定制方案。
📌 适用场景
- 研究探索性质的项目;
- 对分块质量有极致追求且不计成本的特定应用。
📝 实现代码
import os
# 启用 Hugging Face 镜像(如需要)
# os.environ['HF_ENDPOINT'] = 'https://hf-mirror.com'
from dotenv import load_dotenv
from langchain_community.document_loaders import TextLoader
from langchain_experimental.text_splitter import SemanticChunker
from langchain_huggingface import HuggingFaceEmbeddings
from langchain_openai import ChatOpenAI

load_dotenv()

# 1. 文档加载
markdown_path = "../../data/C2/txt/蜂医.txt"
loader = TextLoader(markdown_path, encoding="utf-8")
docs = loader.load()

# 2. 中文语义嵌入模型
embeddings = HuggingFaceEmbeddings(
    model_name="BAAI/bge-small-zh-v1.5",
    model_kwargs={'device': 'cpu'},
    encode_kwargs={'normalize_embeddings': True}
)

llm = ChatOpenAI(
    model="deepseek-ai/DeepSeek-R1",
    base_url="https://api.siliconflow.cn/v1",
    api_key=os.getenv("SILICONFLOW_API_KEY"),
    temperature=0.7,
    max_tokens=4096,  # type: ignore

)

# 3. 语义分块器
text_splitter = SemanticChunker(
    embeddings=embeddings,
    breakpoint_threshold_type="percentile",
    breakpoint_threshold_amount=90
)

chunks = text_splitter.split_documents(docs)

# 4. 打印结果
print(f"文本被切分为 {len(chunks)} 个块。\n")
print("--- 前2个块内容示例 ---")
for i, chunk in enumerate(chunks[:5]):
    print("=" * 80)
    print(f'块 {i+1} (长度: {len(chunk.page_content)}): "{chunk.page_content}"')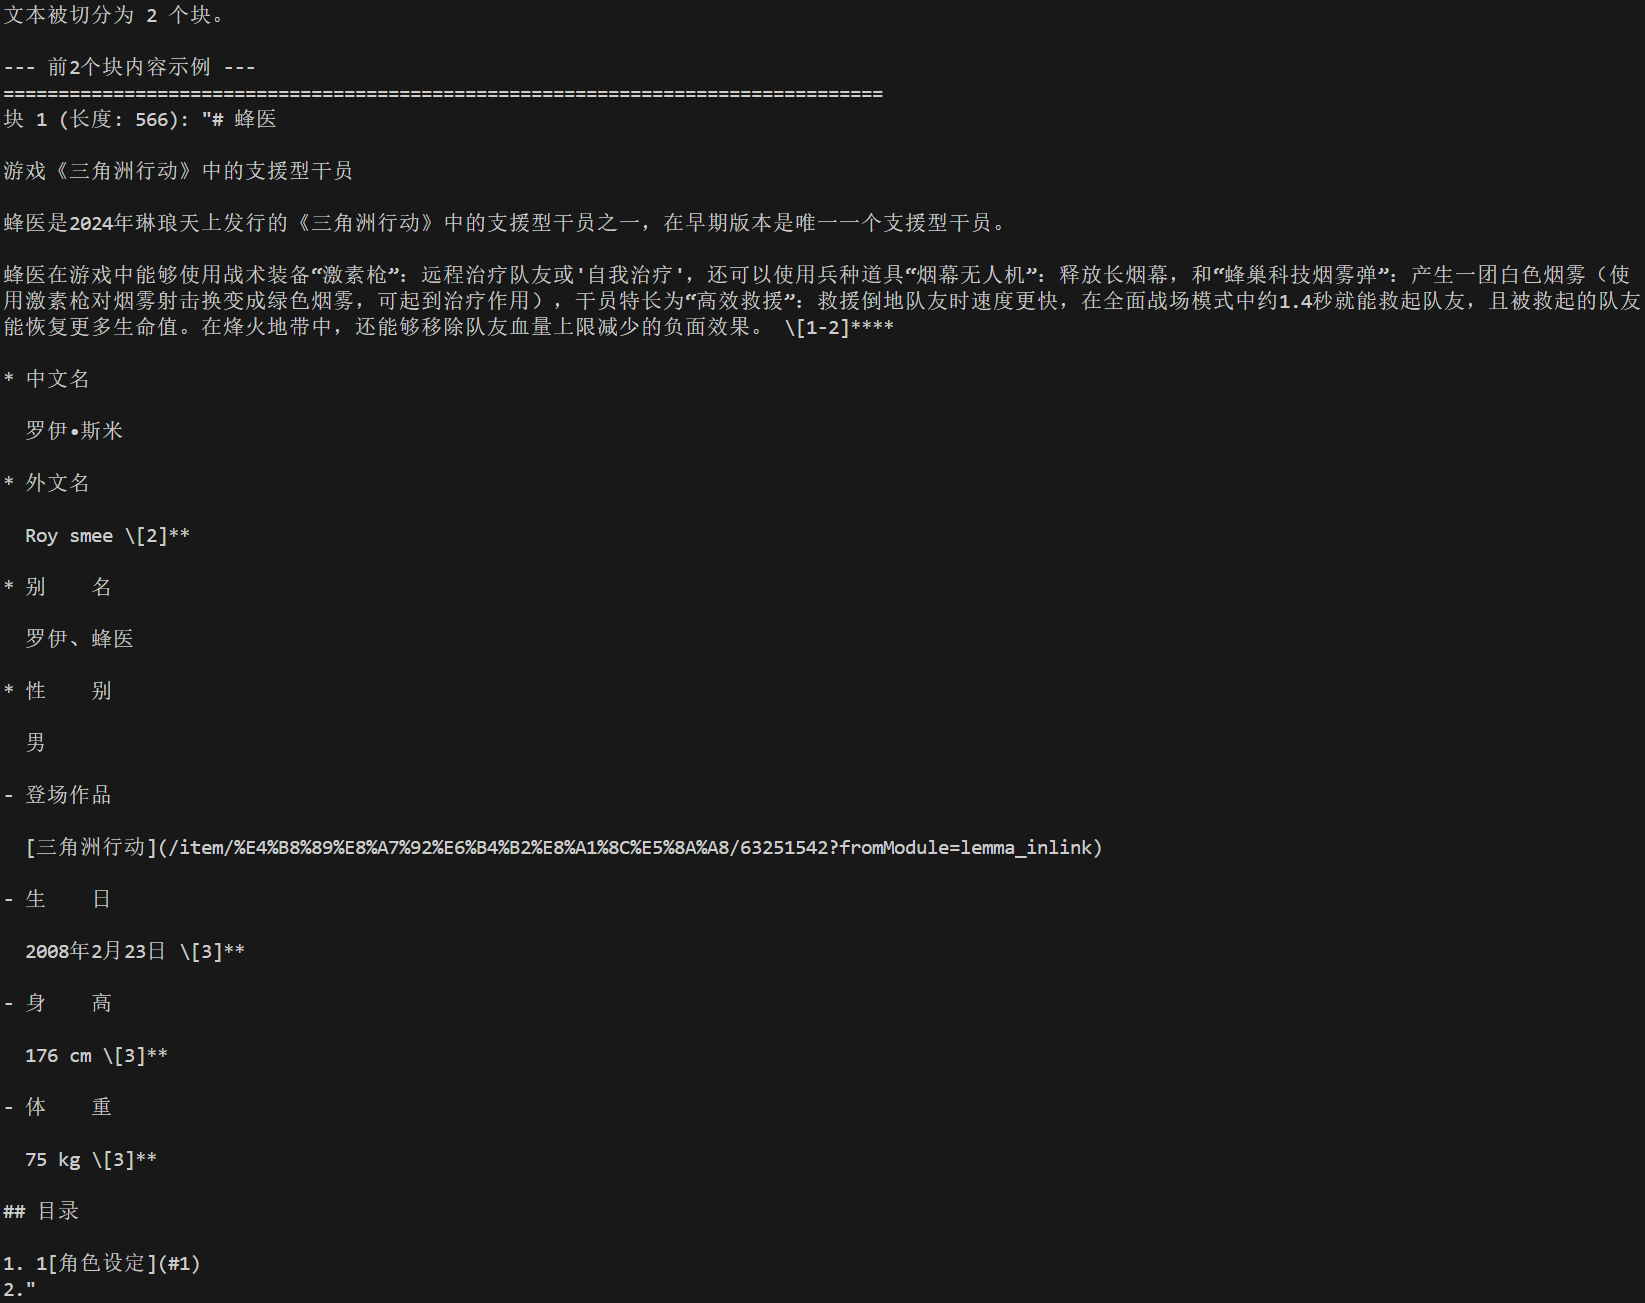
总结
正如开篇所言:“垃圾进,垃圾出”——高质量的 RAG 系统,始于高质量的数据加载与文本分块。它们不是可有可无的预处理环节,而是整个知识管道的地基。地基不稳,即便使用最强的大语言模型(LLM),也难免“地动山摇”:检索不到关键信息,生成答案似是而非,系统表现远低于预期。从简单高效的递归字符分块,到尊重文档结构的语义切分,再到前沿探索的大语言模型(LLM)智能分块,每一种策略都是在上下文完整性、检索精度与计算效率之间寻找平衡。没有放之四海而皆准的“最佳方案”,只有针对具体场景的“最优选择”。
参考文献
《All-in-RAG 第二章 数据准备》 https://datawhalechina.github.io/all-in-rag/《(万字长文)告别粗暴切分:入门 RAG 文本分块,从策略到优化》https://zhuanlan.zhihu.com/p/38753080790《RAG背后的数学:向量点积与余弦的秘密》https://zhuanlan.zhihu.com/p/1889350390845248589《向量相似度大揭秘:长度、相关性与关键词如何“迷惑”Embedding模型?》https://zhuanlan.zhihu.com/p/1896367608149813123

中国智能体开发者社区,聚焦智能体与大模型开发,提供前沿资讯、实用工具链、开源项目及行业案例。通过技术沙龙、开发者大赛等活动,促进经验交流与协作,助力开发者快速构建创新智能应用。
更多推荐



 26
 0
- 0


 已为社区贡献2条内容

所有评论(0)