盘点Retdec里对二进制分析可能有用的库(capstone2llvmir)
首先贴一下Retdec官方对各种库及其工具的介绍(使用ChatGPT进行翻译)
地址:https://github.com/avast/retdec/wiki/Repository-Overview
Overview
库
- ar-extractor - 用于从归档文件中提取目标文件的库(基于 LLVM)。
- bin2llvmir - 将二进制文件转换为 LLVM IR 模块的 LLVM Pass 库。
- capstone2llvmir - 将二进制指令翻译为 LLVM IR 的库。
- common - 实现其他模块通用对象的库。
- config - 表示和管理 RetDec 配置数据库的库。
- cpdetect - 检测二进制文件中的编译器和加壳工具的库。
- ctypes - 表示 C 函数数据类型的库。
- ctypesparser - 用于从 JSON 文件解析 C 函数数据类型为 ctypes 表示的库。
- debugformat - 用于统一表示 DWARF 和 PDB 调试信息的库。
- demangler - 能够处理由 GCC/Clang、Microsoft Visual C++ 和 Borland C++ 编译器生成的名称的符号还原库。
- fileformat - 用于解析和统一表示各种目标文件格式的库。目前支持以下格式:COFF、ELF、Intel HEX、Mach-O、PE、原始数据。
- llvmir-emul - 用于单元测试的 LLVM IR 仿真库。
- llvmir2hll - 将 LLVM IR 模块翻译为高级源代码(如 C、类 Python 语言)的库。
- loader - 用于统一表示加载到内存中的二进制文件的库。支持与 fileformat 相同的格式。
- macho-extractor - 用于从胖 Mach-O 二进制文件中提取常规 Mach-O 二进制文件的库(基于 LLVM)。
- patterngen - 二进制模式提取库。
- pdbparser - Microsoft PDB 文件解析器库。
- pelib - 用于操作 Microsoft 可移植可执行(PE)文件的库。
- retdec - 主要的反编译库。
- rtti-finder - 用于查找二进制文件中 GCC/Clang 和 MSVC RTTI 结构的库。
- serdes - 用于序列化和反序列化各种 RetDec 类的库。
- stacofin - 静态代码查找器库。
- unpacker - 解包功能的集合。
- utils - 通用的 C++ 工具库。
- yaracpp - YARA 的 C++ 封装库。
注意事项
- 库名称也是 RetDec 组件名称,可以通过
find_package(retdec <version> REQUIRED COMPONENTS <component> [...])使用。 - 与
<component>关联的 CMake 目标始终命名为retdec::<component>。 - 可以通过在 CMake 配置中设置
RETDEC_ENABLE_<component>=ON来启用单个<component>的构建和安装。 - 有关使用这些组件的演示,请参阅 retdec-build-system-tests。
工具(应用程序)
- ar-extractortool - ar-extractor 库的前端工具(安装为
retdec-ar-extractor)。 - bin2pat - 从二进制文件生成模式的工具(安装为
retdec-bin2pat)。 - capstone2llvmirtool - capstone2llvmir 库的前端工具(安装为
retdec-capstone2llvmir)。 - demanglertool - demangler 库的前端工具(安装为
retdec-demangler)。 - fileinfo - 主要的二进制分析工具。支持与 fileformat 相同的格式(安装为
retdec-fileinfo)。 - getsig - 从二进制文件生成签名的工具(安装为
retdec-getsig)。 - idr2pat - 用于从 IDR 知识库提取模式的工具(安装为
retdec-idr2pat)。 - macho-extractortool - macho-extractor 库的前端工具(安装为
retdec-macho-extractor)。 - pat2yara - 用于将模式转换为 YARA 签名的工具(安装为
retdec-pat2yara)。 - retdec-decompiler - 主要的反编译应用程序——retdec 库的前端工具。此工具用于完整的二进制到 C 的反编译。
- stacofintool - stacofin 库的前端工具(安装为
retdec-stacofin)。 - unpackertool - 基于插件的解包工具(安装为
retdec-unpacker)。
注意事项
- 工具名称也是 RetDec 组件名称。
- 可以通过在 CMake 配置中设置
RETDEC_ENABLE_<component>=ON来启用单个<component>的构建和安装。
脚本
支持脚本:
- retdec-archive-decompiler.py - 反编译指定 AR 归档中的目标文件。
- retdec-fileinfo.py - Fileinfo 工具的包装脚本。
- retdec-signature-from-library-creator.py - 从指定库中提取函数签名的脚本。
- retdec-unpacker.py - 尝试使用支持的解包器解包指定的可执行文件。
- retdec-utils.py - Python 工具集合。
- retdec-tests-runner.py - 运行单元测试目录中的所有测试。
- type_extractor - 类型信息生成器(仅供内部使用)。
https://github.com/avast/retdec/wiki/Capstone2LlvmIr
关于capstone2llvmir
Capstone2LlvmIr 库将指定的二进制数据翻译为 LLVM IR 指令序列。
该库使用 Capstone 引擎将数据反汇编为汇编指令,然后利用 C++ 程序生成与这些汇编指令等价的 LLVM IR 序列。
基本设计原则
汇编指令的翻译必须通过在 Capstone 指令与 LLVM IR 序列模板之间进行简单映射来完成。
模板中的变量部分通过 Capstone 提供的具体汇编指令信息生成。
不得进行涉及整个 LLVM 模块的复杂推理,也不得进行超出当前翻译指令范围的模块修改。
Capstone2LlvmIr 对指令翻译范围的目标
Capstone2LlvmIr 被设计用于 RetDec 反编译器的前端。RetDec 的目标是生成高质量的 C/C++ 输出,以便人类能够轻松理解和分析。这旨在简化并加速手动二进制分析。
因此,Capstone2LlvmIr 并不致力于完全翻译(赋予意义/语义)所有的汇编指令。实际上,这种方法会适得其反,因为许多汇编指令无法通过合理简单的 C 命令来表达。它们的完整语义过于复杂,可能会使生成的 C 输出过于冗长,从而导致直接分析原始汇编代码更加容易。
因此,Capstone2LlvmIr 的指令翻译模式如下:
-
完整语义翻译
对于简单的汇编指令(通常来自核心指令集),生成一组 LLVM IR 指令,理想情况下捕获其完整语义。 -
翻译为内置函数(Intrinsic Functions)
汇编指令被翻译为内置函数调用,参数和返回值完全处理。这些内置函数来源或受到各种编译器内部使用函数的启发,通常较为知名或容易理解。 -
翻译为伪汇编调用(Pseudo Assembly Call)
汇编指令被翻译为从 Capstone 的指令表示自动生成的函数调用。函数名根据指令名派生,例如add->__asm_add()。参数和返回值依赖 Capstone 提供的信息,可能不完全准确。 -
不翻译
某些情况下选择忽略某些指令。
虽然反编译是主要目标,但如果有人希望将 RetDec 框架用于其他目的,例如需要复杂指令的语义处理,当前项目如 QEMU 或 McSema 可能是更好的选择。不过,也可能有人自行为 Capstone2LlvmIr 添加复杂语义支持。我们目前没有这样的计划,因为这并不容易实现;但如果有良好的基础准备,或许难度也不会太大(毕竟 QEMU 中的类似功能也是手写的)。即使这样实现了,这对反编译也未必有益(如前所述)。因此,我们可能需要采取以下两种方法之一:
-
分离翻译器
将这些复杂语义的翻译器与当前翻译器分开使用。 -
统一翻译器
将所有翻译功能集成到一个翻译器中,但允许用户指定哪些指令应翻译、哪些不应翻译,或者选择为特定指令使用哪种翻译模式。
通用库结构
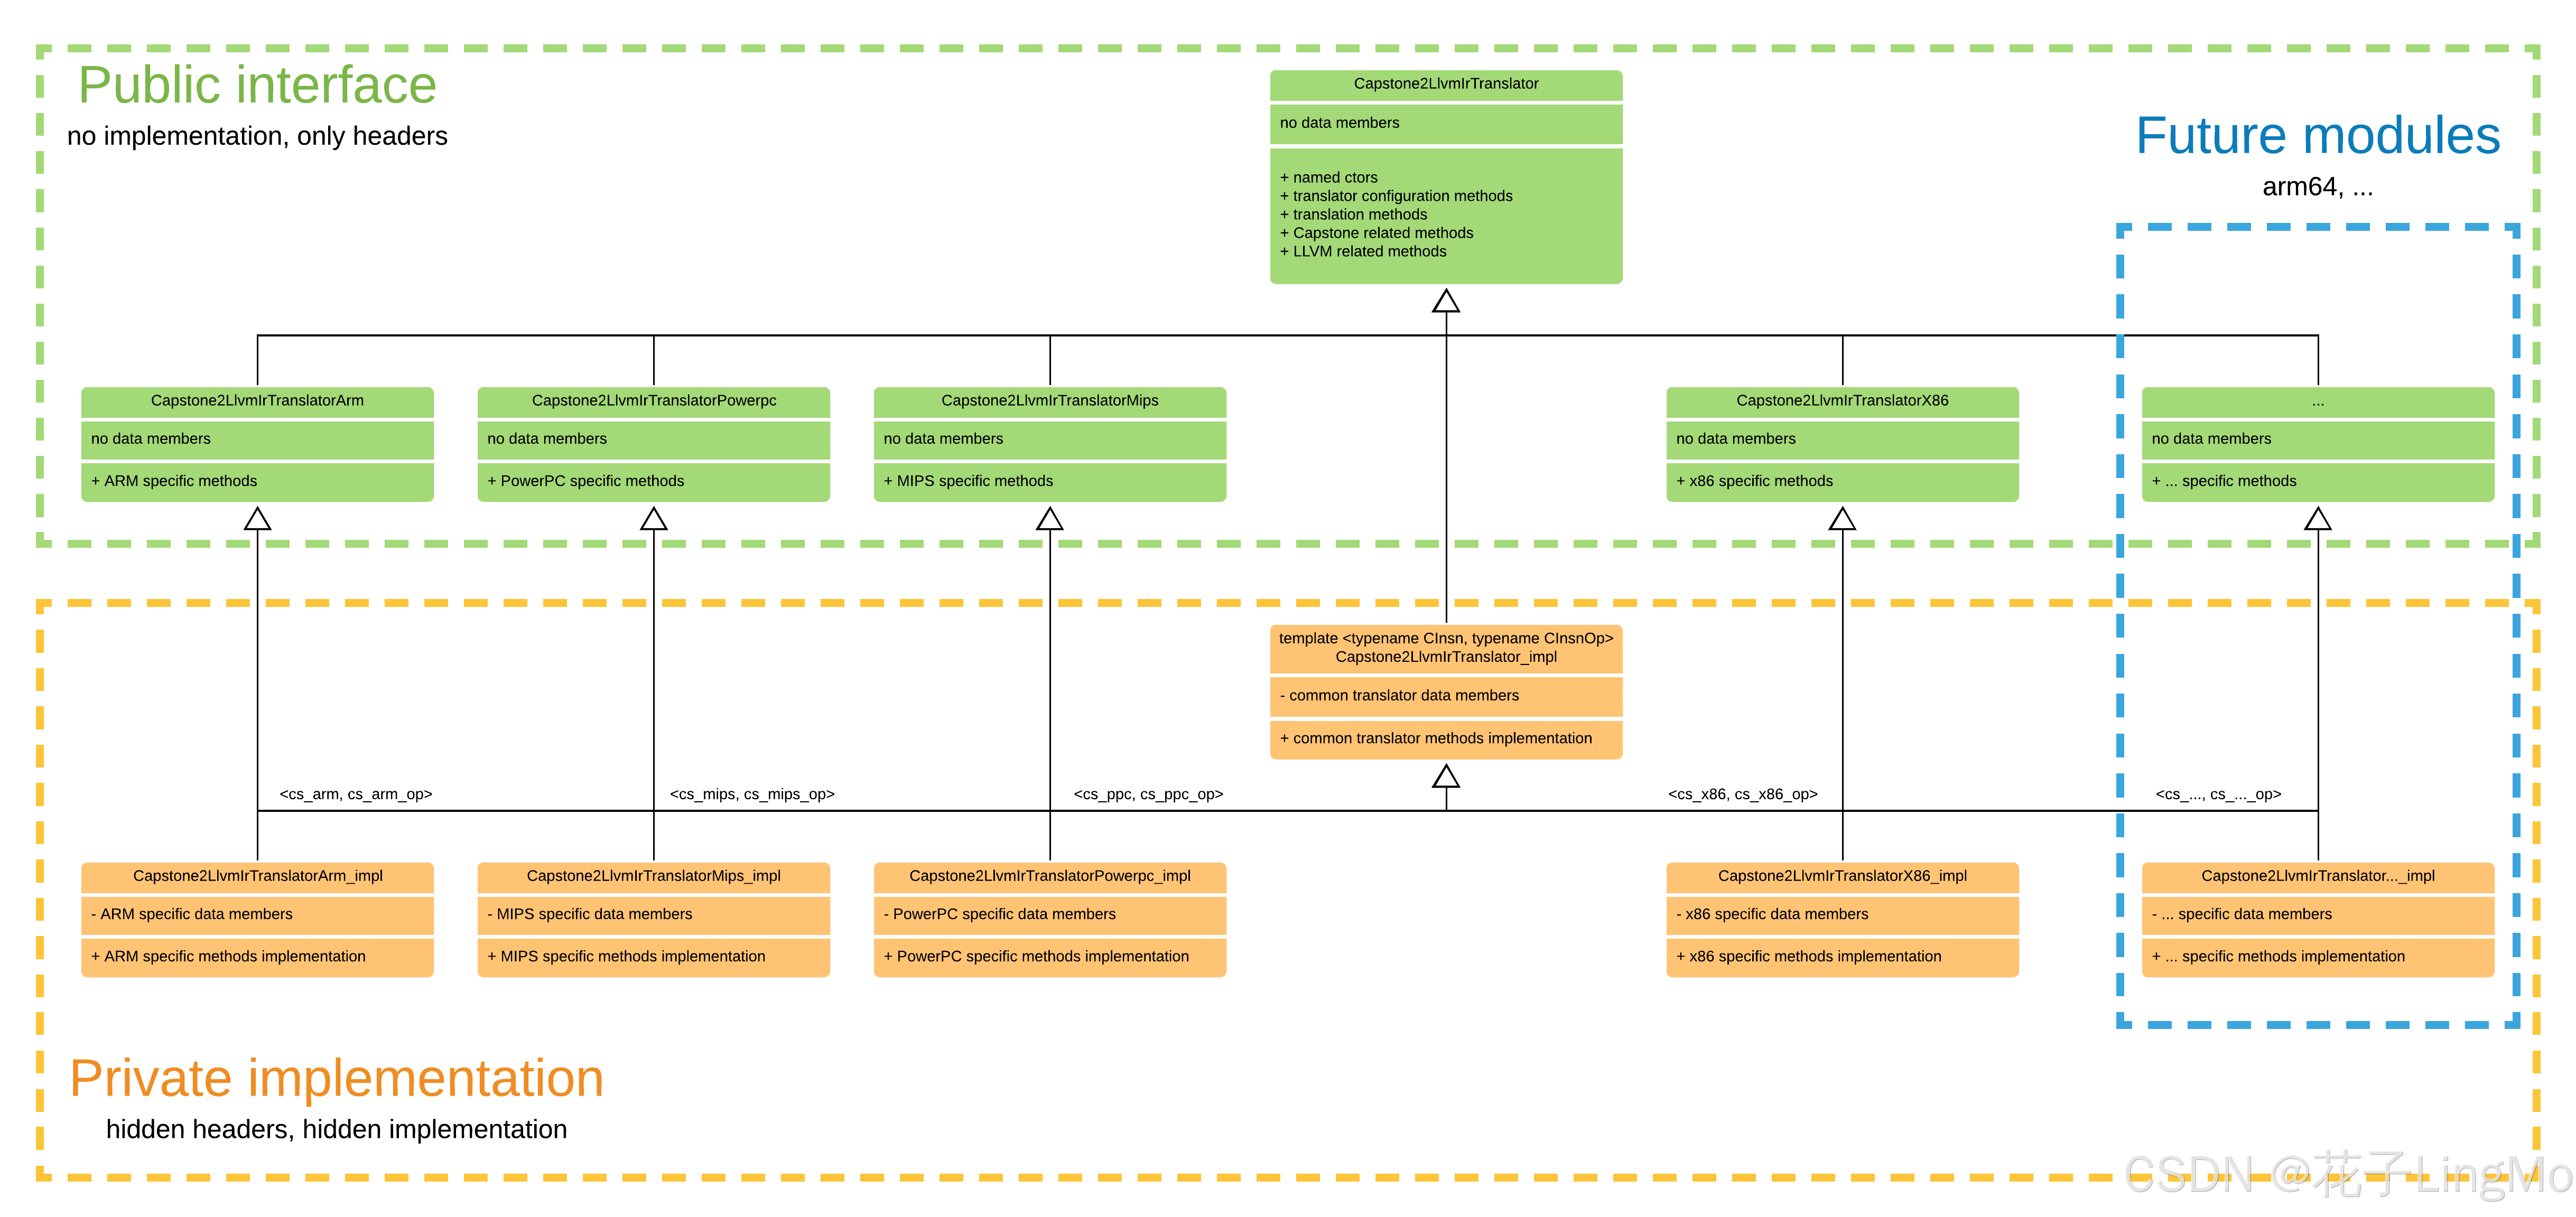
该库可以通过以下几种方式进行划分:
1. 公共部分与隐藏部分
- 公共接口头文件(位于
include/retdec/capstone2llvmir):
包含库用户需要看到的所有内容,无实现代码、无数据成员,仅包含隐藏实现提供的接口。 - 隐藏实现(位于
src/capstone2llvmir):
包括隐藏的头文件和实现源文件。
2. 通用翻译器与特定架构模块
- 通用公共翻译器:
提供通用翻译接口(如Capstone2LlvmIrTranslator)。 - 通用隐藏翻译器实现:
包含通用功能的实现(如Capstone2LlvmIrTranslator_impl)。 - 架构特定的公共翻译器头文件:
包含针对特定架构的扩展(如Capstone2LlvmIrTranslatorArm)。 - 架构特定的隐藏翻译器实现:
包含针对特定架构的功能实现(如Capstone2LlvmIrTranslatorArm_impl)。 - 单独的架构特定实现模块:
这些是最终的翻译器,包含翻译指定架构所需的所有功能。
Capstone2LlvmIr库的工作原理
所有架构特定的模块基本上工作相同。我们通过翻译两条x86指令 add eax, 0x1234 和 je 0x1000 来演示这个过程。
首先,为给定架构(在这个例子中是x86)创建翻译器模块。该模块会触发以下操作:
-
构造函数接受一个LLVM IR模块。翻译器期望该模块为空,传入非空模块会导致未定义行为。
-
构造函数初始化Capstone引擎以及其他工作所需的内部结构。
-
构造函数在给定的LLVM IR模块中创建架构特定的环境:
-
特殊的汇编到LLVM IR映射全局变量
@_asm_program_counter = internal global i64 0
对该全局变量的存储操作是特殊的——它们总是存储整数值,表示汇编指令的地址,对应于后续LLVM IR序列(即从哪个汇编指令生成)。
例如:@_asm_program_counter = internal global i64 0 ; ... ; add eax, 0x1234 @ 0x1000 store volatile i64 4096, i64* @_asm_program_counter ; ... LLVM IR序列对应的加法指令 ; sub ebx, 0x1234 @ 0x1005 store volatile i64 4101, i64* @_asm_program_counter ; ... LLVM IR序列对应的减法指令 -
生成控制流相关的伪函数
这些表示控制流变更操作——调用、返回、分支、条件分支等。所有这些操作在LLVM IR中都有等效的指令,但我们不使用它们,而是生成对这些伪函数的调用。原因是LLVM IR控制流指令需要目标标签,而我们无法直接在指令中使用整数地址作为目标。正确地创建标签需要复杂的推理和修改模块,违背了Capstone2LlvmIr的基本设计原则。用户需要负责这些过程,Capstone2LlvmIr生成的结果需要进一步分析和修改。declare void @__pseudo_call(i32) declare void @__pseudo_return(i32) declare void @__pseudo_branch(i32) declare void @__pseudo_cond_branch(i1, i32) -
架构特定的寄存器
每个架构的寄存器都作为全局变量生成。例如,对于x86:@eax = internal global i32 0 @ecx = internal global i32 0 ; ... @st0 = internal global x86_fp80 0xK00000000000000000000 @st1 = internal global x86_fp80 0xK00000000000000000000 ; ... -
架构特定的数据布局和环境
例如x86 FPU语义模型中使用的伪函数。
-
第二步,翻译器可以用来翻译给定大小、给定地址的二进制数据,并将结果放置在LLVM IR模块中的指定位置。
假设翻译数据 05 34 12 00 00,大小为5字节,地址为0x1000,并将结果放置在entry_point函数的开头,x86翻译器执行以下步骤:
-
使用Capstone引擎将数据
05 34 12 00 00反汇编为add eax, 0x1234。Capstone不仅提供汇编指令的文本表示,还提供包含所有必要信息的内部结构。例如,add eax, 0x1234:General info: id : 8 (add) addr : 1000 size : 5 bytes : 05 34 12 00 00 mnem : add op str : eax, 0x1234 Detail info: R regs : 0 W regs : 1 25 (eflags) Architecture-dependent info: prefix : 00 00 00 00 opcode : 05 00 00 00 rex : 0 addr sz: 4 modrm : 0 disp : 0 -
查找实现该汇编指令(
X86_INS_ADD)的LLVM IR序列模板的翻译例程。每个翻译器模块定义了一个映射,将Capstone指令ID映射到相应的翻译例程。对于每个指令ID,翻译器执行以下三种可能的模式:- Capstone ID映射到一个ID特定的例程,该例程实现指令的完整语义或指令特定的内部调用。
- Capstone ID映射到一个特定的伪汇编生成方法,这些方法使用Capstone提供的操作数来生成特定的预定义模式。
- Capstone ID没有映射到任何值(
nullptr)。如果翻译器设置为自动生成伪汇编调用,它将使用Capstone提供的指令信息来自动生成这样的调用。
-
执行选定的例程。对于我们的例子,翻译后的LLVM模块如下:
@eax = internal global i32 0
@ecx = internal global i32 0
; ...
declare void @__pseudo_call(i32)
declare void @__pseudo_cond_branch(i1, i32)
; ...
@_asm_program_counter = internal global i64 0

define void @entry_point() {
entry:
  ; add eax, 0x1234 @ 0x1000
  store volatile i64 4096, i64* @_asm_program_counter
  %0 = load i32, i32* @eax
  %1 = add i32 %0, 4660     ; eax + 0x1234
  ; ... 其他指令
  store i32 %1, i32* @eax
  ret void
}
我们可以看到,LLVM IR序列不仅描述了加法操作,还隐式设置了标志。
如果翻译数据 74 f9(即 je 0x1000),大小为2字节,地址为0x1005,并将结果放置在前一个翻译序列之后,则执行相同的步骤。翻译后的LLVM模块如下:
@eax = internal global i32 0
@ecx = internal global i32 0
; ...
declare void @__pseudo_call(i32)
declare void @__pseudo_cond_branch(i1, i32)
; ...
@_asm_program_counter = internal global i64 0

define void @entry_point() {
entry:
  ; add eax, 0x1234 @ 0x1000
  store volatile i64 4096, i64* @_asm_program_counter
  %0 = load i32, i32* @eax
  %1 = add i32 %0, 4660     ; eax + 0x1234
  ; ...
  store i32 %1, i32* @eax
  ; je 0x1000 @ 0x1005
  store volatile i64 4101, i64* @_asm_program_counter
  %0 = load i1, i1* @zf
  call void @__pseudo_cond_branch(i1 %0, i32 4096)
  ret void
}
请注意,生成了控制流相关的伪函数,而不是LLVM的br指令。这样,我们就避免了在分支目标地址0x1000创建标签,从而避免了修改当前翻译指令以外的模块。
Capstone2LlvmIr库开发
目前,RetDec团队成员正在专注于以下领域的工作:
-
支持先进的x86扩展集(如MMX、SSEx等):团队正在努力将更多的指令集及其对应的语义纳入库中。该任务可能包括:
- 标记未处理的指令:识别当前实现未处理的与特定扩展(如MMX、SSEx)相关的指令,并将其标记以便后续处理。
- 语义建模:开发对这些指令在LLVM IR中的行为的完整理解。这可能涉及将更复杂的行为纳入LLVM IR模型,例如它们如何与寄存器、内存和标志进行交互。
- 为不支持的架构编写新模块:扩展库以支持其他架构或先进的扩展,确保翻译过程正确处理这些指令。
如何贡献:
- 标记指令:如果你熟悉x86扩展集,可以通过标记需要特殊处理的指令来帮助改进代码库。
- 编写语义模型:如果你了解MMX、SSEx或其他高级指令集的行为,可以帮助编写或改进这些指令集的LLVM IR翻译语义模型。
- 开发新模块:如果你有其他架构或指令集的经验,而这些架构或指令集当前不被Capstone2LlvmIr支持,可以帮助为它们编写模块。
如果你有兴趣贡献,最好联系RetDec团队,讨论你如何在这些领域提供帮助。

中国智能体开发者社区,聚焦智能体与大模型开发,提供前沿资讯、实用工具链、开源项目及行业案例。通过技术沙龙、开发者大赛等活动,促进经验交流与协作,助力开发者快速构建创新智能应用。
更多推荐



 12
 0
- 0


 已为社区贡献1条内容

所有评论(0)