基于 LlamaIndex 实现一个功能较完整的 RAG 系统
·
简单实现了一个基于 llama_index 和 Qdrant 的文档问答系统,主要流程包括文档加载、向量化存储、检索增强生成(RAG)以及对话交互.
一:功能要求:
- 加载指定目录的文件
- 支持 RAG-Fusion
- 使用 Qdrant 向量数据库,并持久化到本地
- 支持检索后排序
- 支持多轮对话
二:安装依赖:
先创建conda环境
pip install --upgrade llama-index
pip install llama-index-llms-dashscope
pip install llama-index-llms-openai-like
pip install llama-index-embeddings-dashscope
pip install qdrant-client
清华源
pip install xxxx -i https://pypi.tuna.tsinghua.edu.cn/simple

阿里源
-i https://mirrors.aliyun.com/pypi/simple/
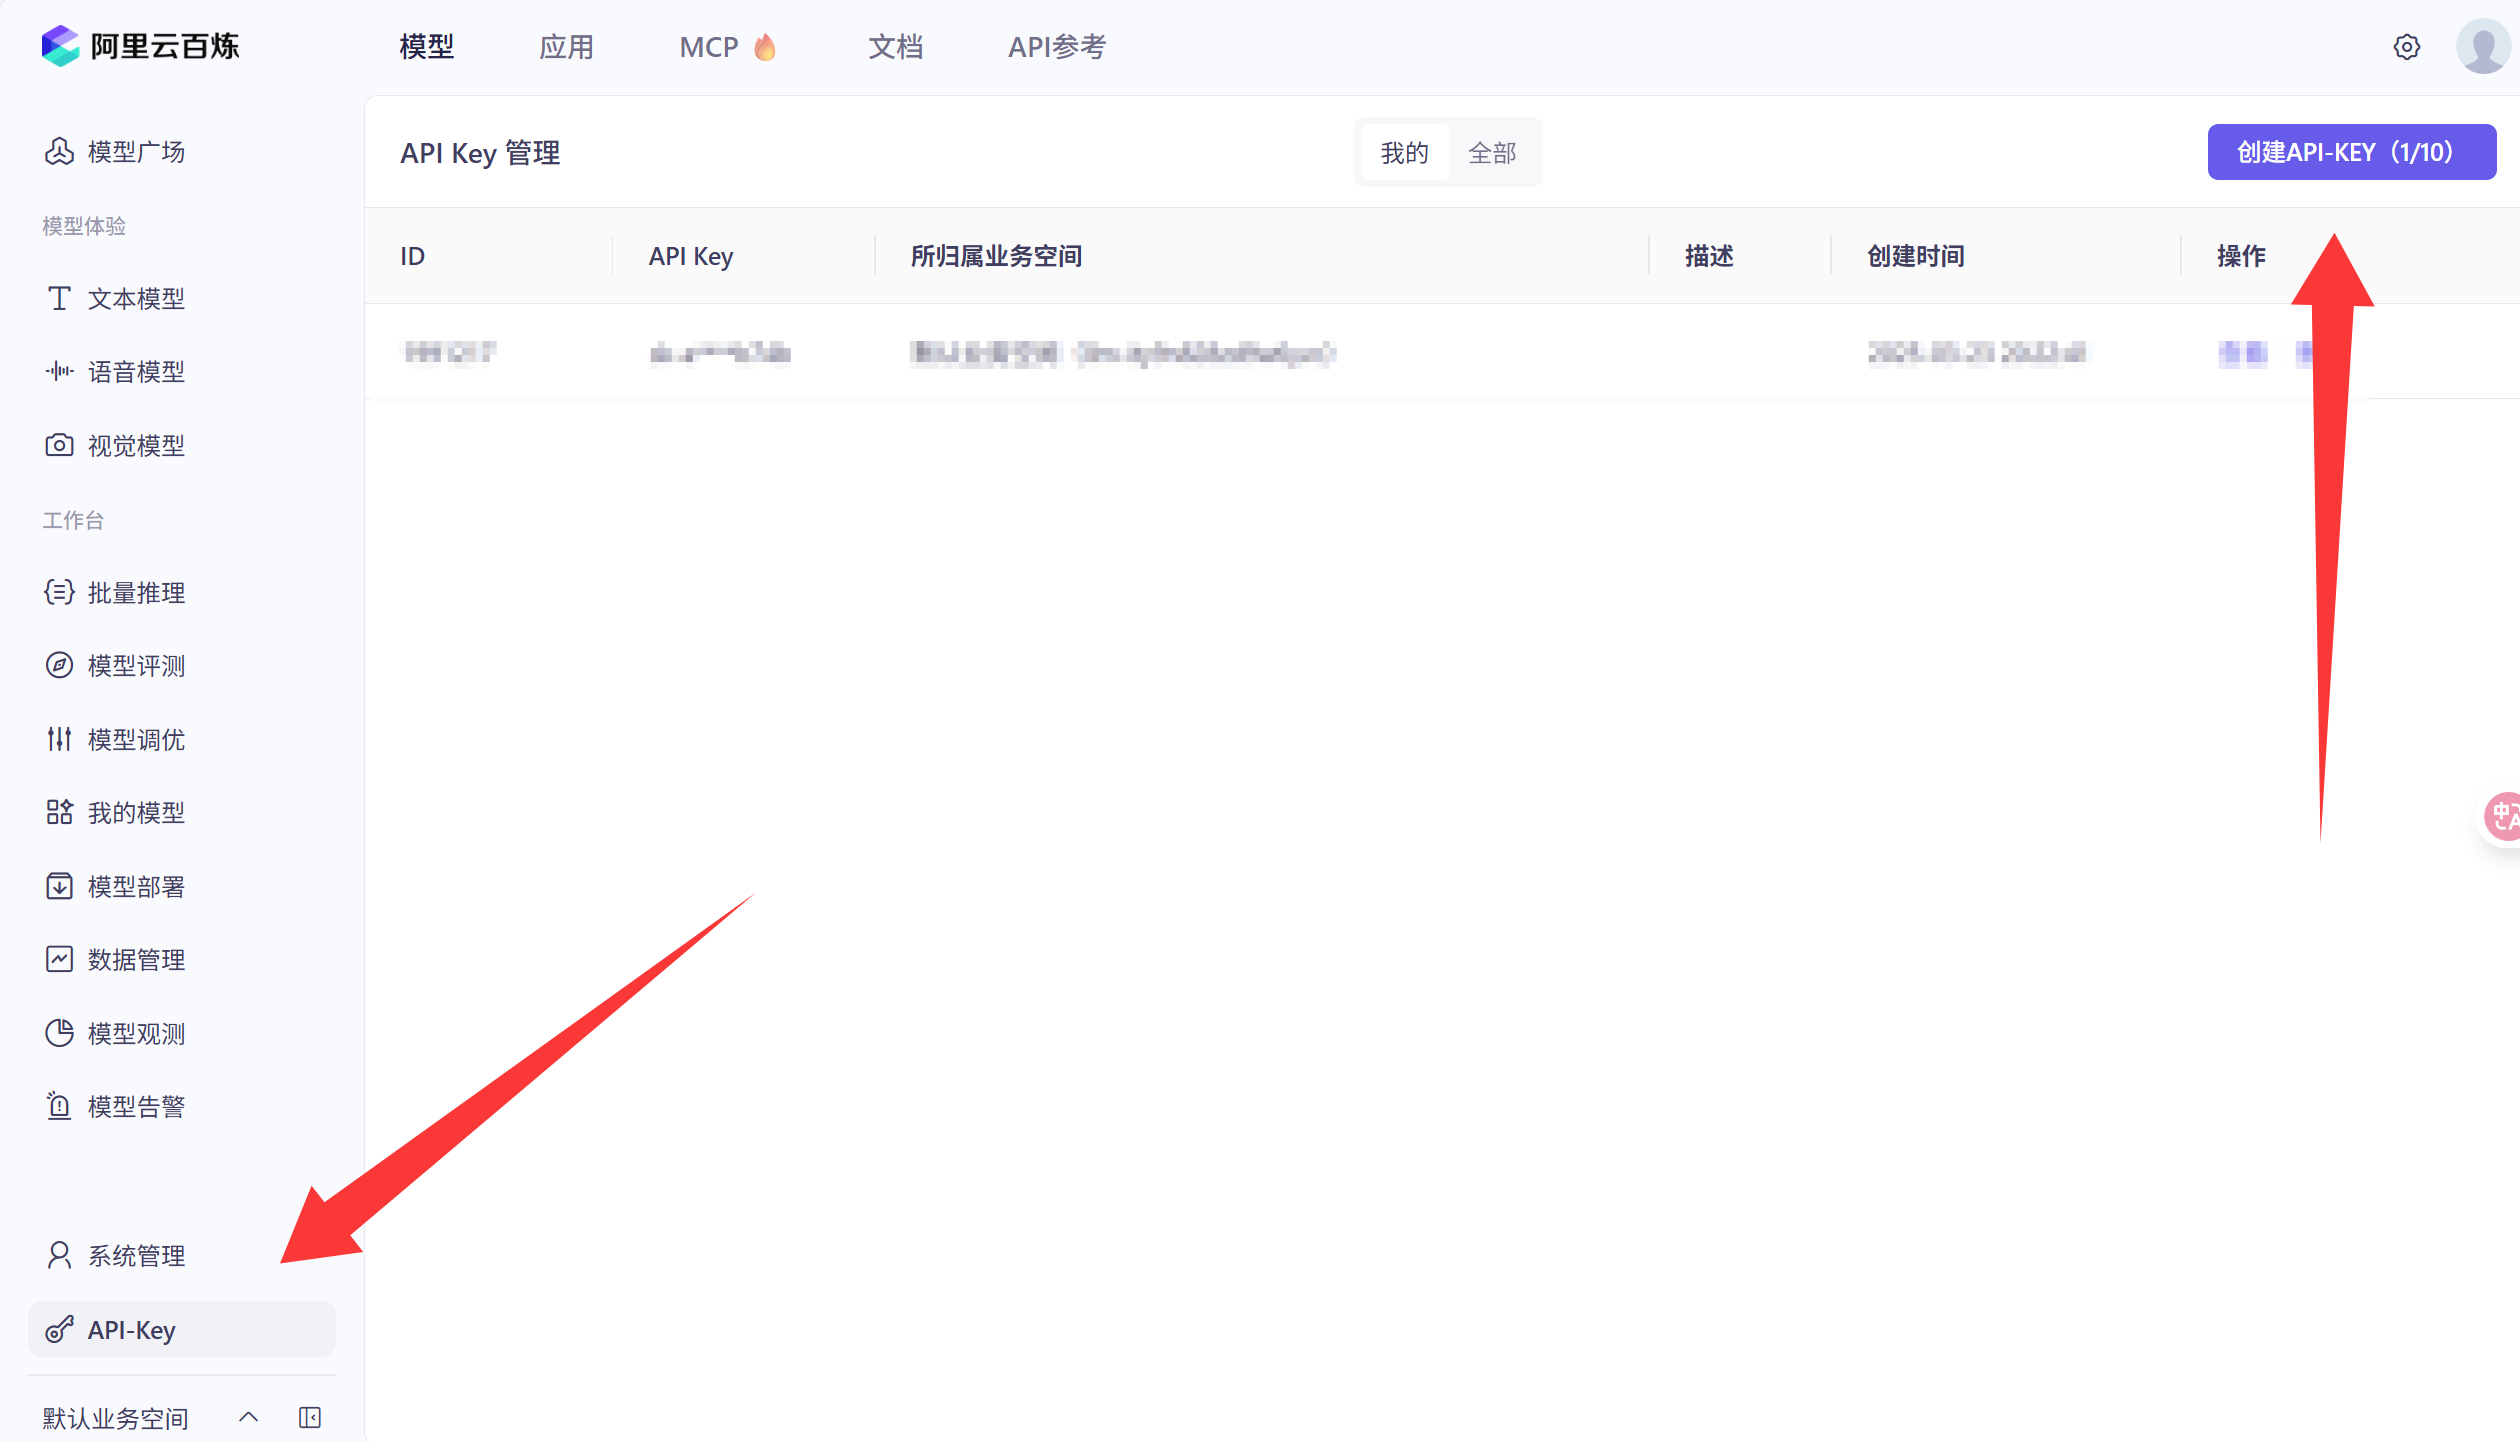
三:申请api
1.注册阿里云账户
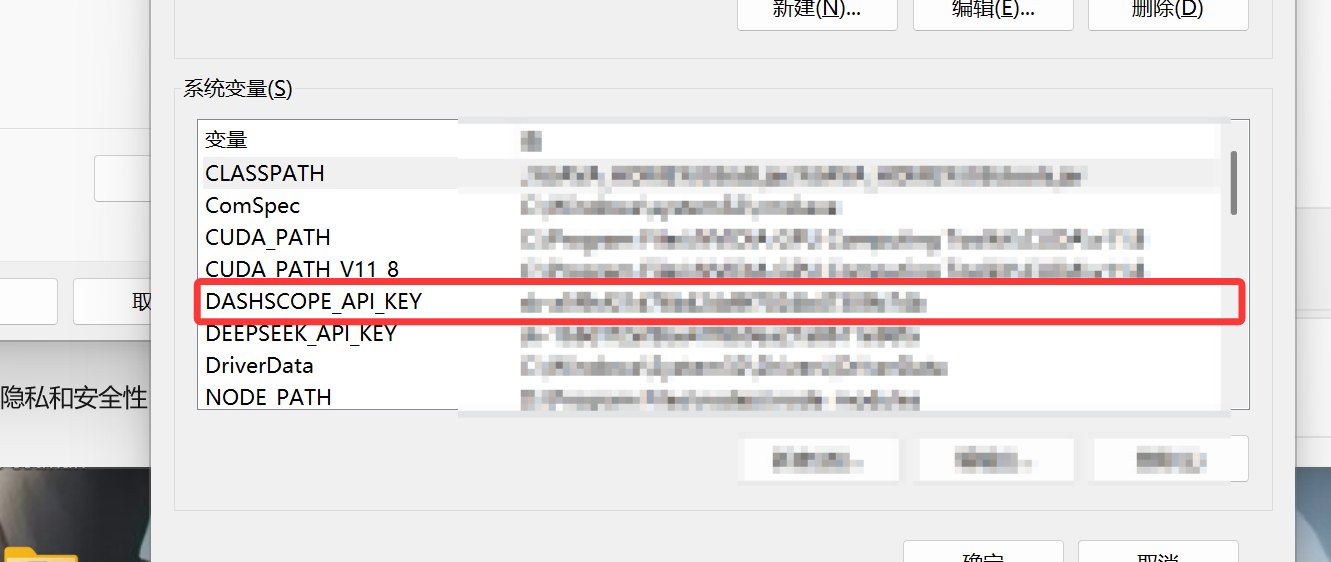
2.配置环境变量
配置完的环境变量须重启电脑后生效
三.代码实现与解析
from qdrant_client import QdrantClient
from qdrant_client.models import VectorParams, Distance

EMBEDDING_DIM = 1536
COLLECTION_NAME = "demo-01"
PATH = "./db"

client = QdrantClient(path=PATH)
EMBEDDING_DIM = 1536#向量维度
COLLECTION_NAME = "demo-01"#集合名称
PATH = "./db"#数据库路径
client = QdrantClient(path=PATH)#创建qdrant数据库
导包:
import os
from llama_index.core import VectorStoreIndex, SimpleDirectoryReader, get_response_synthesizer
from llama_index.core.node_parser import SentenceSplitter
from llama_index.core.response_synthesizers import ResponseMode
from llama_index.core.ingestion import IngestionPipeline
from llama_index.core import Settings
from llama_index.core import StorageContext
from llama_index.core.postprocessor import LLMRerank, SimilarityPostprocessor
from llama_index.core.retrievers import QueryFusionRetriever
from llama_index.core.query_engine import RetrieverQueryEngine
from llama_index.core.chat_engine import CondenseQuestionChatEngine
from llama_index.llms.dashscope import DashScope, DashScopeGenerationModels
from llama_index.embeddings.dashscope import DashScopeEmbedding, DashScopeTextEmbeddingModels

# 确保 QdrantVectorStore 导入正确
from llama_index.vector_stores.qdrant import QdrantVectorStore  # 修复后应可正常导入
模块一:指定llm与enmedding:
# 1. 指定全局llm与embedding模型
Settings.llm = DashScope(model_name=DashScopeGenerationModels.QWEN_MAX, api_key=os.getenv("DASHSCOPE_API_KEY"))
Settings.embed_model = DashScopeEmbedding(model_name=DashScopeTextEmbeddingModels.TEXT_EMBEDDING_V1)
我用的是TEXT_EMBEDDING_V1,V3的词向量维度最大,但不知道为啥不能用
Settings.llm = DashScope(...):指定使用通义千问最大版(QWEN_MAX)作为大语言模型。Settings.embed_model = DashScopeEmbedding(...):指定使用文本嵌入模型V1版本用于向量化文本。
模块二:指定全局文档处理的 Ingestion Pipeline
Settings.transformations = [SentenceSplitter(chunk_size=512, chunk_overlap=200)]该代码设置了Settings.transformations为一个包含SentenceSplitter对象的列表,功能是:
- 使用
SentenceSplitter对文本进行分块处理 - 每个文本块最大为512个字符(
chunk_size=512) - 相邻文本块之间有2个字符的重叠(
chunk_overlap=2),以保持语义连贯
模块三:加载本地文档
documents = SimpleDirectoryReader("./data").load_data()

if client.collection_exists(collection_name=COLLECTION_NAME):
    client.delete_collection(collection_name=COLLECTION_NAME)
如果collection不存在则创建,存在则删除
模块四:剩余部分看注释
# 5. 创建 Vector Store
vector_store = QdrantVectorStore(client=client, collection_name=COLLECTION_NAME)

# 6. 指定 Vector Store 的 Storage 用于 index
storage_context = StorageContext.from_defaults(vector_store=vector_store)
index = VectorStoreIndex.from_documents(
    documents, storage_context=storage_context
)

# 7. 定义检索后排序模型
reranker = LLMRerank(top_n=2)
# 最终打分低于0.6的文档被过滤掉
sp = SimilarityPostprocessor(similarity_cutoff=0.6)#这是基于相似度打分

# 8. 定义 RAG Fusion 检索器
fusion_retriever = QueryFusionRetriever(
    [index.as_retriever()],
    similarity_top_k=5, # 检索召回 top k 结果
    num_queries=3,  # 生成 query 数
    use_async=False,
    # query_gen_prompt="",  # 可以自定义 query 生成的 prompt 模板
)

# 9. 构建单轮 query engine
query_engine = RetrieverQueryEngine.from_args(
    fusion_retriever,
    node_postprocessors=[reranker],
    response_synthesizer=get_response_synthesizer(
        response_mode = ResponseMode.REFINE
    )
)

# 10. 对话引擎
chat_engine = CondenseQuestionChatEngine.from_defaults(
    query_engine=query_engine,
    # condense_question_prompt="" # 可以自定义 chat message prompt 模板
)- 创建向量数据库:使用Qdrant作为向量存储,构建
vector_store。 - 构建索引:将文档通过
VectorStoreIndex存入向量库中。 - 设置排序模型:使用LLM重排序和相似度过滤器对检索结果排序过滤。
- 融合检索器:使用
QueryFusionRetriever进行多角度查询增强检索效果。 - 构建查询引擎:结合检索器与后处理模块生成答案。
- 构建对话引擎:支持连续对话的问答引擎。
模块五:#测试多轮对话
while True:
    question=input("User:")
    if question.strip() == "":
        break
    response = chat_engine.chat(question)
print(f"AI: {response}")此部分为键盘录入,如果你按照文档步骤来搞应该没问题,你提供的文档格式如果不合适去用内置的工具重新切分并加载,如果还是不合适用这个文档智能_文档AI_智能文档处理_数据智能-阿里云,前期有免费额度。

中国智能体开发者社区,聚焦智能体与大模型开发,提供前沿资讯、实用工具链、开源项目及行业案例。通过技术沙龙、开发者大赛等活动,促进经验交流与协作,助力开发者快速构建创新智能应用。
更多推荐
 37
 0
- 0


 已为社区贡献1条内容

所有评论(0)