登录社区云,与社区用户共同成长
邀请您加入社区
暂无图片
为遵守国家网络实名制规定,未绑定将限制内容发布与互动
文献综述熬到崩溃?2026年四类AI学术工具实测盘点:找对工具,少走半年弯路 又到开学季,后台收到最多的私信就是:"学长,文献综述到底怎么写啊?""AI生成的参考文献全是假的,被导师骂惨了怎么办?""有没有什么工具能直接用?" 说实话,2026年了,写综述还在纯手工啃PDF、或者直接把题目丢给ChatGPT硬写,都是在走极端。这半年我把市面上主流的AI学术工具几乎都试了一遍,从通用大模型到AI智能
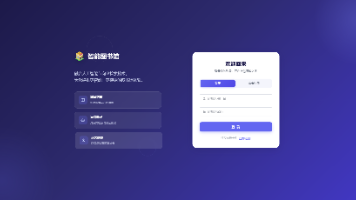
基于AI Agent的智能图书馆管理系统,集成DeepSeek大模型与Qdrant向量数据库。读者通过智阅助手以自然语言完成语义检索、借书还书、收藏图书,同时支持智能推荐、借阅记录与藏书书架管理。管理员可进行用户管理、图书维护、借阅审核与运营统计,覆盖图书馆日常运营全流程。
AI Agent 并不会取代安全工程师。但是它会改变安全工程师的工作方式。人↓工具↓结果人↓↓多个安全工具↓智能分析↓决策建议PythonLinux渗透工具Agent架构LLM调用RAGWorkflow自动化编排安全AI工程真正优秀的安全自动化系统,不是让 AI 替你执行所有事情。而是:让 AI 成为连接安全工具、知识库和工程流程之间的智能控制层。这个自动化渗透 Agent 的完整源码和环境配置文
第二个限制尤其反直觉:很多框架本身会做自动 resize(如 2000×2000 / 5MiB),所以。贵的模型在 55K 就触发压缩(全局默认 77K),便宜的保持 77K/38K 基线。贵的模型(如 pro)输入成本可能是便宜模型(如 flash)的。当系统里有多个成本差异很大的模型时,上下文压缩策略可以。——不是一刀切,而是让贵的模型更早瘦身。:把大图切成 N×N 的带重叠网格,让。处理视觉
读代码层:TS 和 C# 本来就是「远房亲戚」——asyncawait??、接口、泛型、严格空检查,你的心智模型几乎无缝平移。真正要适应的只有两件事:类型是具名而非结构化的(多一句显式声明),以及 NativeAOT 下的「禁反射」约束。写扩展层:你甚至可以不怎么碰 C#——Node.js 插件桥意味着你的 TypeScript 插件就是一等公民,而且能在生产 aot 车道跑。内核给你 .NET
重复率过了AI率又爆?2026论文辅助工具选型实录:大模型、智能体、一键双降到底怎么搭 又到开题、初稿、答辩连轴转的季节。先说一个今年最扎心的现实:2026年《学位法》正式施行后,高校对论文的审核已经从"单查重复率"变成了"重复率+AIGC率双查"。身边好几个同学都是重复率好不容易磨到8%,维普AIGC检测一跑46%,直接被导师打回;手动改完AI痕迹,重复率又反弹,来来回回把论文逻辑都改散了。 这
2026年彻底变为“智能体之年”,OpenClaw、Hermes等强大的智能体不再是实验室里的玩具,而是正在成为大家日常工作中不可或缺的小伙伴。尤其对于程序员来说,学习智能体已经不是“要不要”的问题,而是“什么时候开始”的问题。不过很多程序员在看OpenClaw源代码的第一反应不是兴奋而是害怕,四十多万行代码任谁都会头皮发麻,看不了两分钟就关了网页,还是去使用LangChain等框架去调API了,
典型不好的工具定义不好的原因是:描述太模糊,参数名意义不明,模型不知道什么时候该用正确的定义关键踩坑经验坑现象解决描述太短模型不知道什么时候用这个工具写清楚“何时调用 / 何时不要调用”参数名太短q / id / val 模型不知道填什么用完整语义的名词缺少类型约束传入字符串 "123" 但 API 要数字严格标注 JSON Schema 类型枚举值不全模型自己编造不在枚举里的值enum字段约束缺
像Bizfocus的AgentCore这类产品,在实施阶段会有全程的陪跑支持,这种”不是卖完系统就撒手”的服务模式,对没有专职AI工程团队的企业来说,实际落地效率差异会很明显。私有化部署想当然:不是所有平台都支持”完全私有化”,有的产品只是前端私有化、核心处理还是走云端,这一点在选型阶段就要问清楚,否则等到数据安全审计的时候才发现不合规就麻烦了。A:不完全等同,私有化部署的核心是”数据不出内网”,
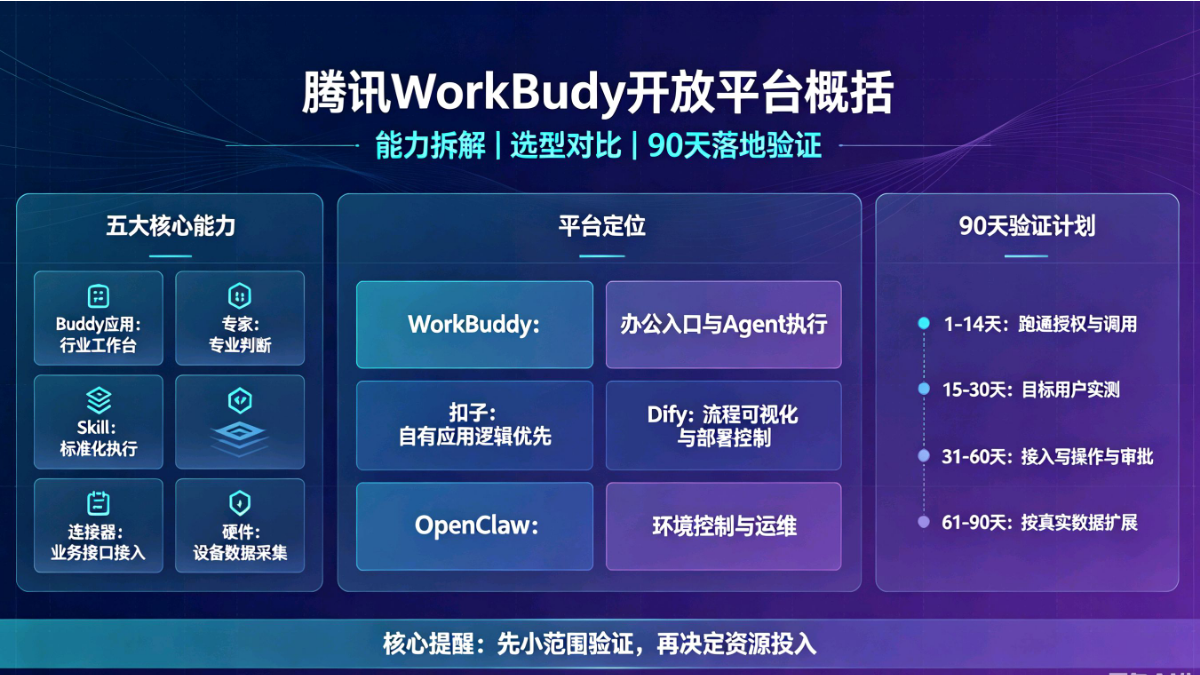
9月2号腾讯也扔出个WorkBuddy开放平台,通稿里“超百家生态伙伴”“9款联名硬件”“30+行业应用”,数字摆得整整齐齐,不知道的还以为行业明天就要洗牌了。举个例子,合格的“销售工作台”不是把“写作专家、表格专家”摆一排当货架,而是直接给你“整理拜访记录”“生成跟进草稿”这种现成的任务入口。同样的模型差不多的提示词,抄起来分分钟的事,真正难复制的是业务数据、服务权限和客户关系。很多人选平台跟选