登录社区云,与社区用户共同成长
邀请您加入社区
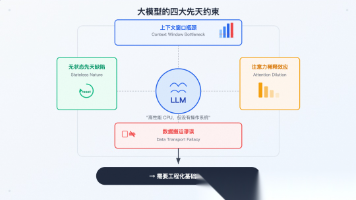
本文系统性地回顾了我们在构建企业级 AI Agent 平台过程中走过的完整技术演进路径——从大模型的先天约束出发,经历 Prompt 工程、Context 工程、Harness 工程三个阶段,最终演化出一套五层架构的 Agent 操作系统。每一层的出现都是因为前一层遇到了天花板。
AI Agent的初期爆火期已经过去,当下已经进入到更为理性和平静的沉淀期,应该沉下心,好好复盘每一个关键选型,让Agent能够真正的在业务场景中落地。
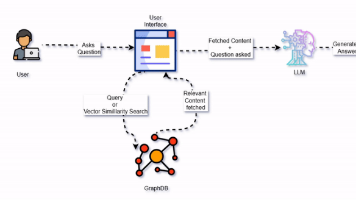
整体流程图:是否用户提问获取图谱 SchemaLLM 生成 Cypher 查询Neo4j 执行查询查询成功?获取查询结果返回错误信息LLM 增强生成自然语言回答详细流程说明:Neo4j图数据库大语言模型用户Neo4j图数据库大语言模型用户自然语言问题 + 图谱Schema生成 Cypher 查询语句Cypher语句执行 Cypher 查询返回查询结果问题 + 查询结果增强生成(总结回答)自然语言回
CANN自定义算子开发实战:从“这个算子不支持”到“跑起来了”
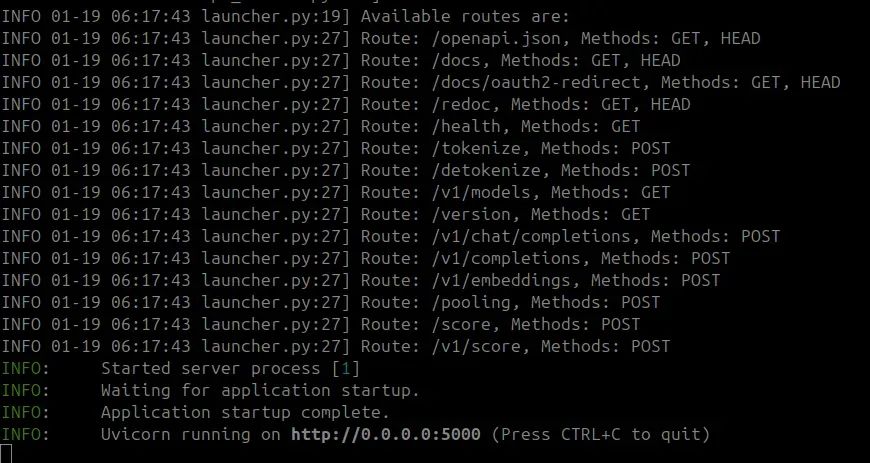
开源的LLM已经成为程序员、爱好者和希望在日常工作中使用生成式AI并保持隐私的用户的最佳选择,对于企业的私有化部署而言也是如此。这些模型提供了优秀的性能,有时在许多任务中可以与大型的闭源模型 (如 GPT-4o 或 Claude Sonnet 3.5) 相媲美。这些LLM是开源的,但并不意味着它们可以开箱即用,需要一个运行框架在本地或服务器上运行大模型以获得特定的用例。
图数据库(Graph Database)是一种以图结构为基础进行数据存储与查询的数据库。与传统的关系型数据库通过表格和主外键进行建模不同,图数据库使用节点(Nodes)和关系(Relationships)直接表示实体及其之间的连接,更加自然地映射现实世界中的关联结构,特别适用于处理复杂的连接型数据。
例如,可以构建一个智能相册管理系统,该系统不仅能自动识别照片中的人物并进行分类,还能检测出照片中的物体(如风景、动物、食物等)来辅助相册标签化。持续学习更先进的算法(如基于深度学习的MTCNN用于人脸检测),并探索如何用自己收集的数据集训练自定义模型,将是提升技能的下一个台阶。在开发相关应用时,尤其是在涉及公共空间或个人数据的场景下,必须遵循合法、正当、必要的原则,明确告知用户数据用途,并采取严格
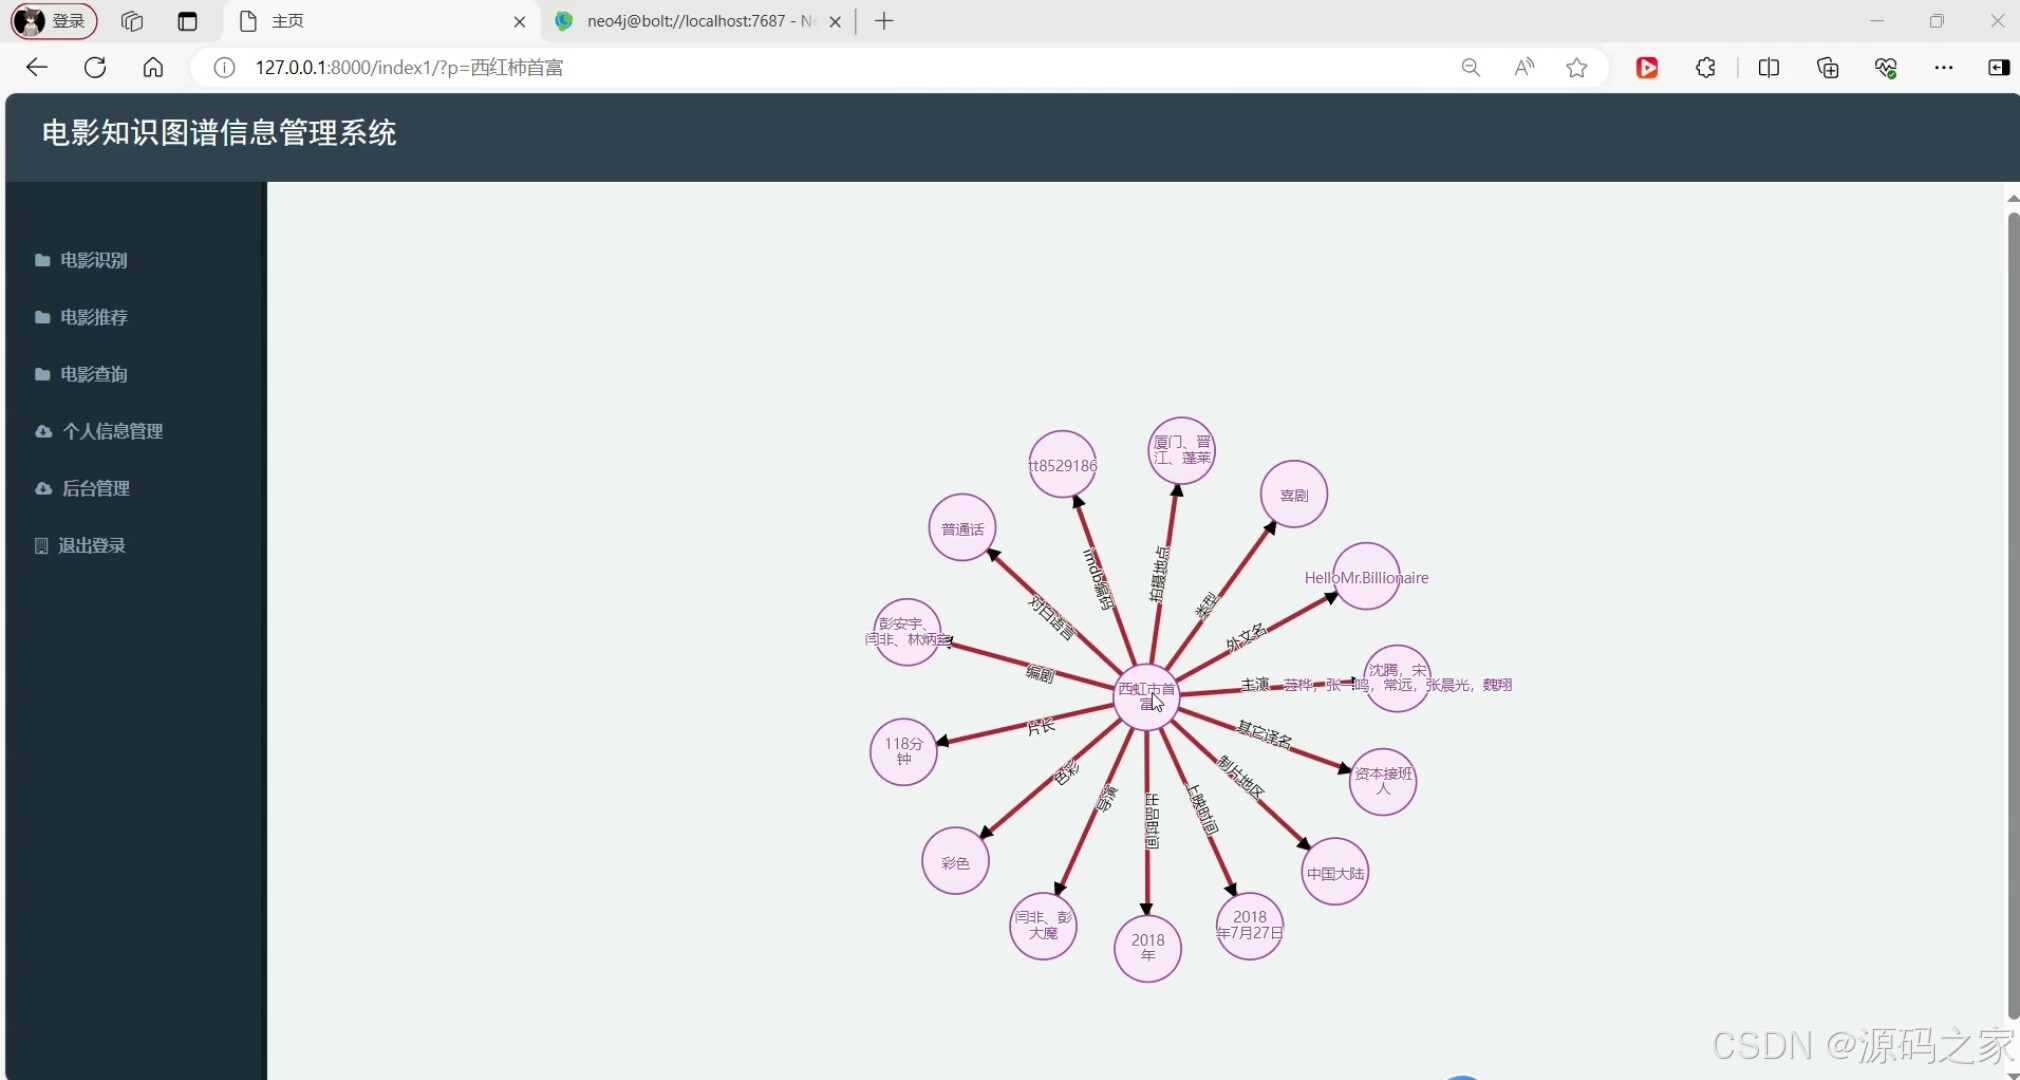
该项目是一款基于Python和Django的电影综合服务平台,融合Neo4j图形数据库和协同过滤算法,实现七大核心功能:1)电影知识图谱查询;2)Neo4j数据库可视化;3)智能问答系统;4)个性化电影推荐;5)Echarts数据可视化;6)个人中心管理;7)后台数据维护。系统通过多技术协同,为用户提供电影信息查询、智能推荐和自然语言问答服务,同时为管理员提供便捷的数据管理工具,实现了电影信息服务
在人工智能与移动计算深度融合的今天,将大语言模型(LLM)部署到移动端和边缘设备已成为行业发展的重要趋势。TensorFlow Lite作为专为移动和嵌入式设备优化的轻量级推理框架,为开发者提供了将复杂AI模型转换为高效、低功耗边缘计算解决方案的强大工具。随着移动设备硬件性能的不断提升和模型压缩技术的快速发展,2025年的移动端LLM部署已不再是遥远的愿景,而是正在成为现实的技术实践。
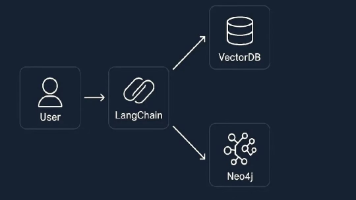
本文介绍了如何结合Neo4j知识图谱和LangChain构建精准可解释的RAG系统。传统向量检索在需要多跳推理和关系关键的场景下存在局限,而知识图谱能提供结构化关系和推理能力。文章详细展示了从设置Neo4j数据库、导入数据到使用Cypher查询的过程,并介绍了如何结合向量检索形成混合RAG管道。这种混合方法结合了图谱遍历和语义相似性匹配,使系统既能处理复杂推理又能保持灵活性,适用于医疗、金融、法律
知识图谱是一种强大的信息表达方式,由“实体”(节点)及它们之间的“关系”(边)组成,使我们能够比纯文本更直观地洞察事物之间的关联。
文章介绍了如何结合 Neo4j 知识图谱和 LangChain 构建 RAG 系统。相比传统向量数据库,知识图谱提供了关系推理、多跳查询和可解释性优势。文章详细讲解了安装配置、数据导入、Cypher查询、混合检索器和完整示例,展示了如何结合图谱遍历和嵌入检索创建精准、可解释、适合生产环境的 RAG 系统。这种方法特别适合需要复杂推理和多跳查询的应用场景。
摘要:本文提出基于知识图谱的农作物病虫害智能问答系统,利用Neo4j构建包含作物、病虫害、防治方法等关系的知识图谱,结合自然语言处理技术实现用户问题的精准解析与查询。系统通过机器学习持续优化模型,实验证明能有效提高农业病虫害防治信息的获取效率,为智能农业提供新思路。
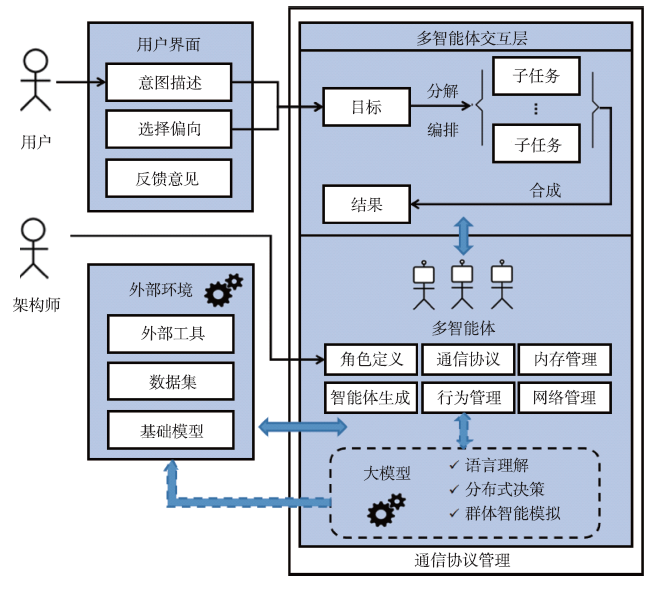
摘要:大模型驱动的多智能体系统在增强人工智能水平方面具有巨大的潜力,为军事智能化提供了创新解决方案。但是,目前的大模型驱动的多智能体系统能够独立完成任务目标的自主性受任务复杂程度的影响较大,且系统处理结果与初始目标之间的一致性程度较差,有必要对大模型驱动的多智能体系统的自主性和一致性进行评估分析。已有研究尚未对大模型多智能体系统的自主性和一致性水平进行全面评估。提出了一种多维评估方法,能够分析提取
阿里杀疯了,Qwen团队刚刚接连发布了两款重要模型:**Qwen3-Omni**,业界首个原生端到端全模态AI模型;以及**Qwen-Image-Edit-2509**,对标谷歌nano banana 图像编辑工具,根据预告,明天还有“大的”要发布
本文介绍了如何利用知识图谱和LLM构建高效的结构化数据问答系统。作者通过医疗行业案例说明传统RAG在处理复杂查询时的局限性,提出三种GraphDB解决方案:1)简单CypherQAChain实现基础问答;2)高级查询方法通过实体提取提升复杂问题处理能力;3)结合向量索引的GraphRAG技术处理非结构化数据。以电影数据集为例,详细演示了Neo4j数据库构建、Cypher查询生成和混合检索策略的实现
本文详细介绍了RaggedTensor与TensorFlow其他张量类型(密集张量和稀疏张量)之间的转换方法。主要内容包括: RaggedTensor转密集张量:使用to_tensor()方法填充默认值,适用于需要固定形状输入的场景 密集张量转RaggedTensor:使用from_tensor()方法剔除填充值,恢复可变长度结构 RaggedTensor转稀疏张量:使用to_sparse()方法
本文详细介绍了TensorFlow中tf.data.Dataset与RaggedTensor结合的四大核心应用场景。主要内容包括:1)使用RaggedTensor构建数据集,保留可变长度数据的原始结构;2)批处理与取消批处理操作对RaggedTensor的特殊处理方式;3)将非规则张量转换为Ragged批处理的技术。通过代码示例和结果解读,展示了RaggedTensor在处理可变长度数据时的优势—
摘要:TensorFlow中的不规则张量(RaggedTensor)专门处理非均匀长度数据,允许同一维度下元素长度不一致(如[[3,1,4,1], [], [5,9,2]])。它适用于可变长度特征、批量序列、分层数据等场景,支持100+原生运算(数学、数组、字符串操作等)。关键特性包括Python风格索引、算术重载、自定义转换,并能与Python列表/NumPy互转。RaggedTensor解决了
摘要:本文深入解析TensorFlow中RaggedTensor的不规则形状与广播机制。RaggedTensor通过静态形状(TensorShape)和动态形状(DynamicRaggedShape)描述其可变长度特性,静态形状中不规则维度恒为None,动态形状则记录实际行长度。广播机制继承普通Tensor规则但针对不规则维度特殊处理,允许标量、均匀维度为1的Tensor与RaggedTensor
docker已安装完成,故直接安装tugraph。在命令行中输入打开成功。tugraph用户名admin密码73@TuGraph。(改为123z)tugraph:首先获取两个json文件分别用于建立模型和导入数据:用于建模,由方法构建;用于导入数据,由方法构建。该模型共有6个顶点:, , , , , 。5条边:, , , , 。分别为指向其他顶点的关系。json文件书写代码如下:在网页端新建med
3. 辅助工具安装Blender 2.7: 官方下载pbrt-v3-tof: 从 Su et al. 的仓库 编译安装MatLAB: 需安装插件(用于处理 EXR 格式渲染结果)二、数据准备1. 下载预生成数据数据集链接: Google Drive下载(~20GB)下载预训练模型权重2. 自定义数据生成 (可选)若需生成新数据,按以下流程操作:(2) 生成瞬态渲染(pbrt-v3-tof)(3)
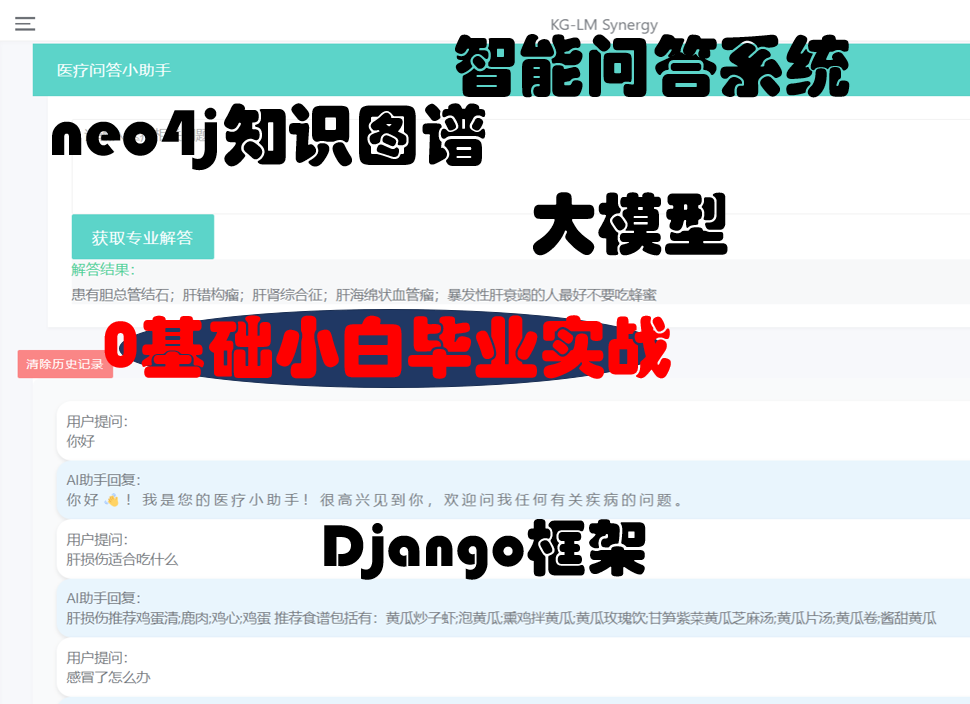
本文介绍了一个基于Python的医疗知识问答系统技术架构。系统采用Django框架开发,使用Neo4j构建知识图谱存储医疗知识,MySQL管理用户数据。核心技术栈包括Python3.7、Neo4j3.5、MySQL8.0和Django3.0.4。系统提供疾病症状查询、药物信息检索、智能问答等核心功能模块,通过py2neo和pymysql实现数据库操作。该系统整合了"寻医问药"平
项目演示登录展示:知识图谱可视化展示:智能问答展示:数据介绍数据来源于从百度百科网站上进行爬虫,见源码实体类型中文含义实体数量举例Check诊断检查项目3,353支气管造影;关节镜检查Department医疗科目54整形美容科;烧伤科Disease疾病8,807血栓闭塞性脉管炎;胸降主动脉动脉瘤Drug药品3,828京万红痔疮膏;布林佐胺滴眼液Food食物4,870番茄冲菜牛肉丸汤;竹笋炖羊肉Pr
安全是大模型走向真实世界应用过程中必须优先考虑的问题。HiddenDetect 提出了一种无需训练、基于激活信号的检测方法,为提升多模态模型的安全性提供了新的思路。该方法结构轻量、部署灵活,已在多个模型与攻击类型中展现出良好效果。尽管如此,该方法目前仍主要聚焦于风险提示,尚未对模型行为产生直接调控。未来,研究团队希望进一步拓展方法能力,并深入探索模态信息与模型安全性的内在关联,推动多模态大模型朝着
大型语言模型(LLMs) 在数学推理和多语言翻译 等任务上已取得显著进展。为进一步提升模型能力,各种强化学习范式被广泛应用。其中,RLHF依赖成本高昂且一致性不足的人工标注;RLVR依赖外部监督,获取可验证答案仍是一个瓶颈。对偶学习(Dual learning)利用任务的对偶性(如翻译与回译)来生成内在反馈,提供了一种自监督的替代方案。 然而,传统的对偶学习应用于LLMs时面临两大挑战:首先,大多
在8GB内存设备上部署7B参数模型实现实时推理,需结合多项优化技术。
LLM智能体的发展正从“追求功能全面”转向“追求安全可靠”,而幻觉问题是这一转型路上必须跨越的障碍。这篇综述的价值,不仅在于“系统性梳理现有研究”,更在于“为领域建立了统一的问题定义与分析框架”——它让原本模糊的“幻觉问题”变得可分类、可溯源、可解决。对于研究者,这份综述是入门的“地图”,清晰标注了每个方向的研究现状与缺口;对于开发者,它是排查问题的“手册”,可按5类幻觉快速定位产品中的风险点;而
本文解析了MCP Server的架构设计与Nacos协同方案,提出五种主流架构模式:直连Remote Server适用于轻量级应用,Proxy代理模式适合高并发场景,本地直连架构保障数据隐私,本地Proxy混合架构兼顾安全与扩展,混合模式则支持多云部署。重点阐述了Nacos在服务发现、健康检查和配置管理中的关键作用,并给出架构选择策略,建议根据任务复杂度、资源约束和安全需求选用合适方案。开发推荐J
在数字化转型中,企业面临海量半结构化数据的检索需求与复杂关系网络的分析挑战。Elasticsearch作为分布式搜索引擎,擅长处理大规模文本检索与实时数据分析;Neo4j作为领先的图数据库,在处理节点关系遍历、路径搜索等场景具有独特优势。两者整合可形成“全文搜索+图分析”的复合能力,解决传统单一数据库无法应对的复杂业务场景(如推荐系统中的语义搜索与关系推荐结合、金融风控中的实体关联分析等)。
普通人如何借势突围?大模型应用开发为本科生打开AI入行新通道
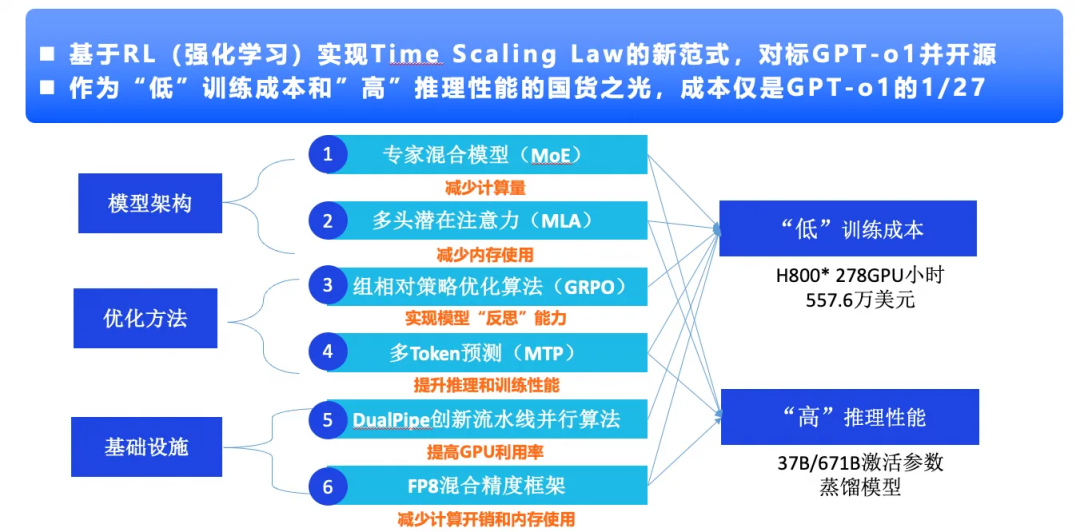
在 DeepSeek 问世之前,AI 赋能数据库智能运维的核心挑战在于落地的"最后一公里"。传统 AI 系统虽能生成诊断报告,但其输出结果往往呈现为专业术语堆砌的技术指标(如锁争用率、缓存命中率等),其分析结论只能作为参考。DeepSeek 的出现,让数据库运维管理中诊断决策这一"最后一公里"问题有了解决方案。如上图所示,构建数据库智能运维 (DBAIOPS) 需要三个关键基础,即“高精度的基础数
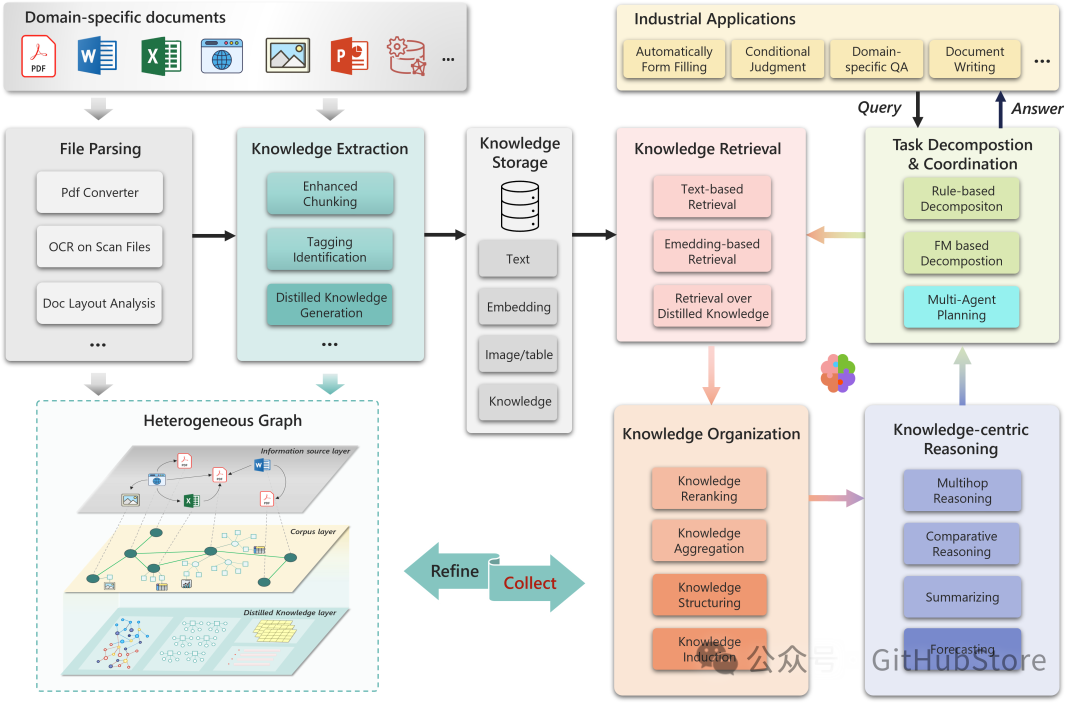
微软开源的一个用于专业领域问题的RAG系统:PIKE-RAG,它解决了传统RAG处理专业领域知识时的局限性,比较适合处理深度领域知识和多步逻辑推理的场景它通过提取、理解和应用领域特定知识,并构建连贯的推理逻辑,逐步引导LLM)生成准确答案PIKE-RAG包含文档解析、知识提取、知识存储、知识检索、知识组织、以知识为中心的推理以及任务分解和协调多个基本模块,通过调整子模块,来构建针对不同功能的 RA