登录社区云,与社区用户共同成长
邀请您加入社区
文章摘要: 《SinoMem:全本地中文记忆系统,让AI对话告别重复介绍》针对LLM对话无状态的问题,提出轻量级解决方案。通过SQLite+FTS5+jieba分词(支持bigram扩展)实现10ms级中文搜索,可选ONNX本地语义模型(24MB)。相比云API/向量数据库方案,具备零费用、部署简单(pip安装)、分词精准(优化中文召回率)三大优势,支持Claude Code/Hermes等Age
摘要 本文通过Nginx日志管理案例,系统阐述ELK Stack(Filebeat+Logstash+Elasticsearch+Kibana)的实战部署方案。重点解析四层架构设计(采集→处理→存储→展示),详细说明Filebeat多源日志采集配置、Logstash Pipeline的JSON格式解析与Grok正则处理技巧,以及基于索引生命周期管理(ILM)的热温冷分层存储策略。最后展示Kiban
本文深入解析UTF-8编码机制与GPT中文分词原理: UTF-8编码规则详解 通过二进制实例解析四种字节类型:0开头(单字节ASCII)、10开头(后续字节)、110开头(双字节前导)、1110开头(三字节前导) 完整演示字节流解析过程:01000001→A、11001110 10110001→α、11100100 10111101 10100000→"你" 解释UTF-8天然兼容ASCII的原因
本文介绍了中文NLP中的三大基础任务:分词、词性标注和词表示。在分词方面,详细讲解了精确模式、全模式和搜索引擎模式三种方法及其适用场景;在词性标注方面,强调了其在信息抽取和特征工程中的重要性;在词表示方面,对比了One-Hot向量和分布式/上下文向量的优缺点。文中提供了可运行的代码示例,并给出了工程实践建议:维护领域词典、繁简转换预处理、词性特征工程等。最后指出,扎实的基础处理是构建高质量NLP系
词向量是自然语言处理的核心技术,它将离散的词语转换为连续的向量空间表示,使机器学习模型能够 “理解” 语义。从早期的 Word2Vec 到如今的 BERT,词向量的发展推动了 NLP 任务的性能飞跃。尽管存在局限性,但词向量仍是连接文本与机器学习的重要桥梁,在各类实际应用中发挥着关键作用。
在自然语言处理(NLP)的诸多任务中,文本切分是一个看似基础却至关重要的环节。无论是文本预处理、问答系统、文档检索,还是大模型的上下文输入控制,都离不开合理的切分策略。随着大语言模型和语义理解技术的发展,传统的“按标点分句”已难以满足复杂场景的需求。本文将系统梳理文本切分的主要方法,结合典型的应用场景,帮助开发者选型和落地实现。
本文介绍了使用Docker部署Elasticsearch和Kibana 8.17.10的完整流程,包括:1)创建专用网络;2)拉取并运行ES容器;3)安装Kibana并连接ES;4)重点讲解如何安装IK中文分词器插件,详细说明ik_smart和ik_max_word两种分词模式的差异;5)提供优化IK分词器的方法,通过修改配置文件解决网络新词识别问题。部署完成后可通过9200和5601端口访问服务
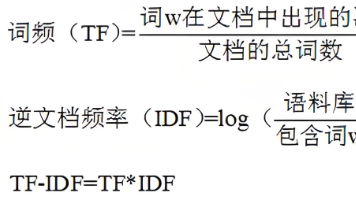
本文系统介绍了中文文本预处理的核心步骤,重点讲解了jieba分词工具的功能与应用。主要内容包括:分词处理:对比全模式(高速但冗余)和精确模式(高精度)的分词效果,演示基础分词操作;词典优化:通过添加自定义词典解决专有名词(如"百战程序员")的分词歧义问题;关键词提取:基于TF-IDF算法实现文本关键词抽取(如《三国演义》选段中的"玄德"、"张角"等),支持停用词过滤优化结果;词性标注:结合poss
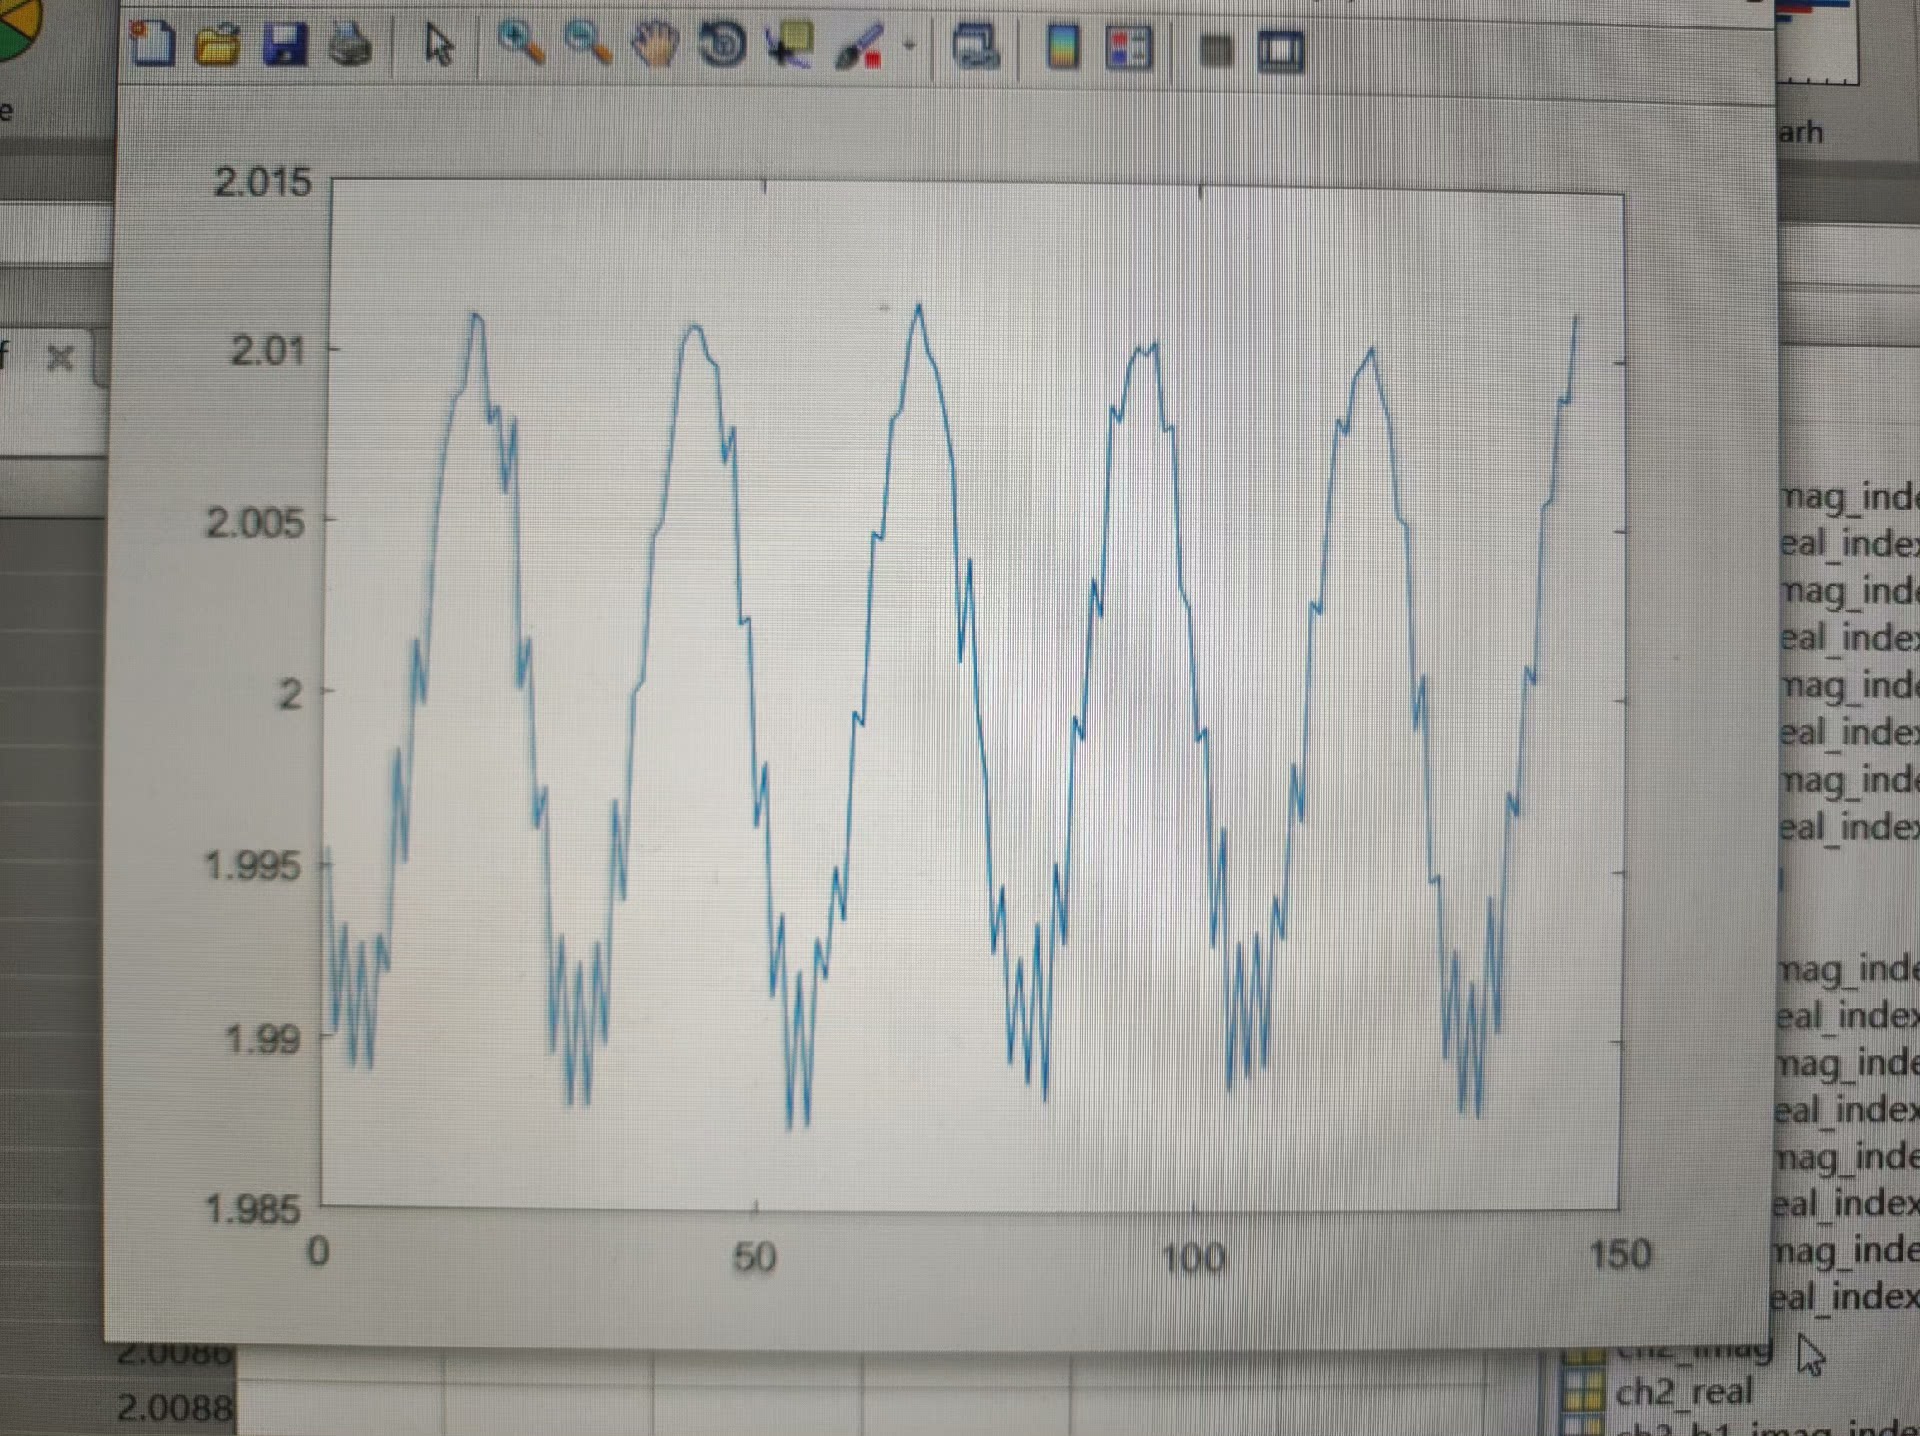
fpga相位差检测,基于vivado环境,7606三路采样,绝对,独此一份,包含源码,仿真和matlab代码在数字信号处理的领域中,相位差检测是一项关键技术,它在诸如电力系统监测、通信信号处理等众多应用场景中都有着举足轻重的地位。今天咱就来唠唠基于FPGA(现场可编程门阵列),在Vivado环境下实现的7606三路采样的相位差检测,而且还附上源码、仿真以及Matlab代码,绝对独此一份的干货分享。
中文分词方法多种多样,各有优缺点。在实际应用中,选择合适的分词方法需要考虑具体的应用场景、数据特点和计算资源。现代大模型(如 BERTGPT)通常采用子词分割方法(如 BPE、WordPiece),但在特定领域或任务中,其他方法也可能提供有价值的补充。随着技术的发展,分词方法也在不断演进,未来可能会出现更多创新的分词技术。在实际应用中,子词分割方法是中文大模型中的标准选择,因为它能有效处理新词、罕
Elasticsearch安装IK中文分词器
IK分词器是ElasticSearch(es)的一个最最最有名插件,能够把一段中文或者别的语句划分成一个个的关键字,进而在搜索的时候对数据库中或者索引库数据进一个匹配操作
本文详细介绍了在Windows系统上为Elasticsearch 8安装三种常用分词器的步骤: ICU分词器:通过elasticsearch-plugin命令安装官方维护的多语言分词器 IK分词器:需下载对应版本的zip包并解压到plugins/ik目录 拼音分词器:同样需要版本匹配,解压到plugins/pinyin目录 安装完成后需重启Elasticsearch并通过curl命令验证。注意事项
本文介绍了五种常用的中文自然语言处理工具:jieba、jiagu、snownlp、thulac和LAC,重点讲解了它们的分词功能及其他核心特性,并提供了相关示例代码。
可以将 Percolate Query(渗透查询)想象成一个筛子系统。● 筛子孔洞 (存储的查询): 预先制作了很多不同孔径的筛子(存储的查询条件),每种孔径代表一种筛选规则。● 沙子 (渗透的文档): 当新的沙子(文档)倒入筛子系统时,会穿过一些孔洞,而被另一些孔洞阻挡。● 穿过的孔洞 (匹配的查询): 最终哪些筛子的孔洞允许沙子穿过,就代表这个沙子符合哪些筛选规则(匹配的查询)
本文系统介绍了维基百科数据在构建RAG知识库中的全流程处理,包括数据获取、清洗与存储。主要内容包括:维基百科提供多种格式的数据转储文件(XML、SQL、JSON等),可通过wget或BitTorrent下载;使用WikiExtractor工具进行多进程并行处理,提取文本并去除标记语言;详细的数据清洗流程涵盖HTML实体解码、特殊页面过滤等步骤。文章还解析了维基百科XML文件结构和命名规范,为构建高
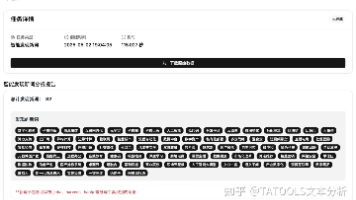
自定义词典的创建可提升文本分析精准度,尤其适合专业领域术语、新词和停用词处理。TATOOLS提供高频词提取和智能发现新词两种方式创建词典,并支持搜狗输入法词库转换,便于快速构建高质量领域词典。
使用LSTM进行中文分词的完整流程,从数据集准备,模型构建到训练与测试
本文详细介绍了在Elasticsearch 7.6.1上安装和使用Jieba中文分词插件的完整流程。主要内容包括:1)准备CentOS 7环境、JDK和Elasticsearch专用用户;2)通过国内镜像安装Gradle构建工具;3)下载并构建Jieba插件源码;4)解决插件版本不匹配问题;5)测试分词效果。文章还推荐了作者开发的ES小工具,帮助用户更方便地管理Elasticsearch。通过本教
中文分词(Chinese Word Segmentation,CWS)是自然语言处理中一项非常基础且重要的任务。中文文本不同于英文文本,中文没有空格分隔单词,因此需要通过算法来进行分词。中文分词的难点在于同一词汇在不同语境中的含义可能会有所不同,而且存在大量的词语歧义。为了进行准确的中文分词,通常需要使用一些NLP技术,如统计模型、词典匹配、机器学习等。
elasticsearch中文分词器的下载及配置教程
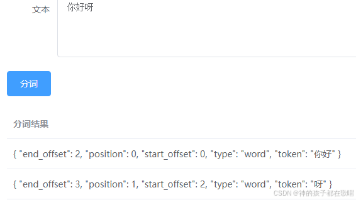
ik_max_word: 会将文本做最细粒度的拆分,比如会将“中华人民共和国国歌”拆分为“中华人民共和国,中华人民,中华,华人,人民共和国,人民,人,民,共和国,共和,和,国国,国歌”,会穷尽各种可能的组合;为什么要在elasticsearch中要使用ik这样的中文分词呢,那是因为es提供的分词是英文分词,对于中文的分词就做的非常不好了,因此我们需要一个中文分词器来用于搜索和使用。1,Elasti
词元和嵌入是使用大型语言模型(LLMs)的两个核心概念。正如我们在第一章中所看到的,它们不仅对于理解语言AI的历史非常重要,而且如果我们没有对词元和嵌入有一个良好的认识,我们就无法清楚地了解LLMs的工作原理、它们是如何构建的,以及它们将来会走向何方。在本章中,我们将更仔细地研究什么是词元以及用于支持大型语言模型(LLM)的分词方法。
(一)研究背景越来越多的消费者将新能源汽车(NEV)选作一种绿色、环保、节能的交通方式,近年来尤其是在中国市场呈现爆发式增长,比亚迪、特斯拉、蔚来、华为、小米等新能源汽车品牌应运而生,随着市场的逐渐成熟,激烈的市场竞争环境,不断增长和细分的消费群体,对于NEV品牌而言,了解及改善消费者满意度是一个迫切需要解决的问题。顾客满意度是指顾客对产品或服务的综合满意程度,电动汽车顾客的满意度除了受产品本身的
"我:"因为我考得不好?"小哥:"可是...我在您家门口发现门是开着的...""兔子:"不用,我自带。"猪爸爸摸摸她的头:"别哭,爸爸给你讲个笑话...呼呼呼~""我摇头,她冷笑:"因为这个手指最没用,跟你一样。"斑马:"我还没准备好,先让长颈鹿说吧,他脖子长看得远。"我:"医生,我从小就不爱吃糖。"医生:"我知道,你该减肥了。"我写了:"42"(《银河系漫游指南》梗)"学生:"因为我终于睡着了。